字节笔记本
2026年10月9日 · 约 9 分钟读完
流式三维重建,不该再开第二轮优化
把一万帧视频喂进三维重建,最怕的不是第一帧糊,而是走着走着坐标系漂走。常见做法是先出一个粗糙地图,再开第二轮优化把位姿和几何往回拧。LingBot-Map 把这件事收成一次前向:坐标锚定、稠密几何和长程漂移,都放进同一个流式框架。仓库 Robbyant/lingbot-map 本轮核到 17559 星,协议 Apache-2.0,页面写着 ECCV 2026 Best Paper Award Candidate。
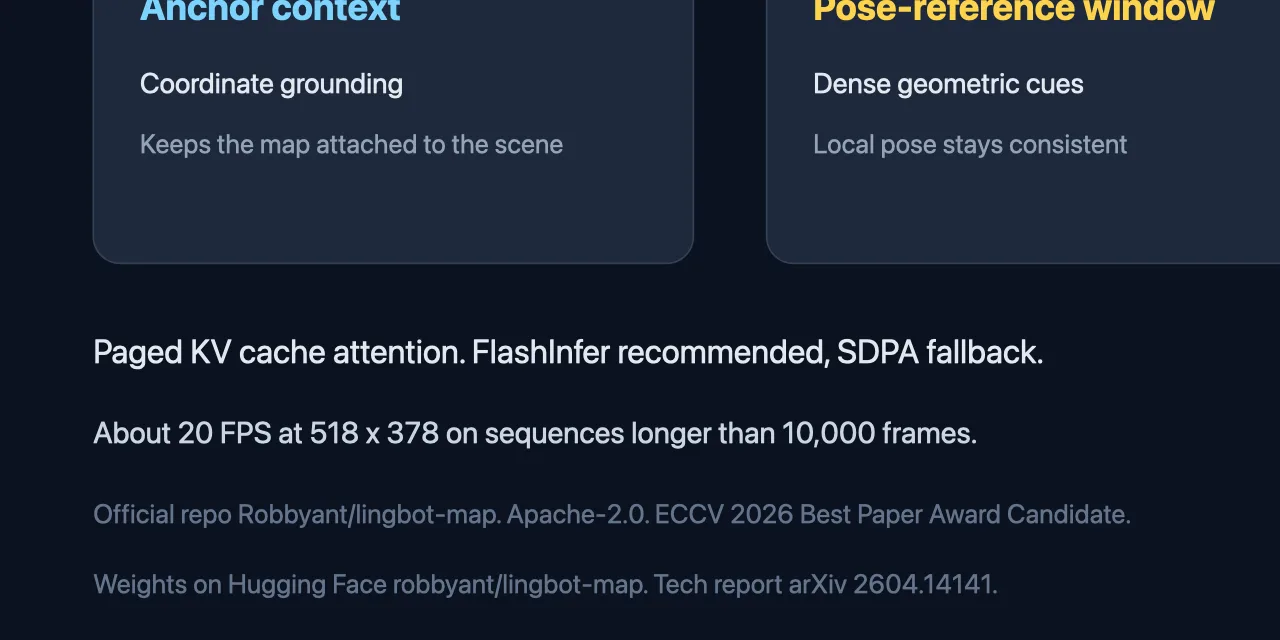
官方口径很具体。分辨率 518×378、序列超过 10000 帧时,稳定推理大约 20 FPS。权重在 Hugging Face 的 robbyant/lingbot-map,项目页是 technology.robbyant.com/lingbot-map。会议版 PDF 挂在 linzhuo.xyz/gct.pdf,扩写技术报告是 arXiv 2604.14141。本轮 GitHub API 还核到 1942 个 fork,默认分支 main,最近推送是 2026-10-06。
一次前向,三块几何上下文
README 把核心叫 Geometric Context Transformer。它不是再叠一个后处理模块,而是把三件事写进同一套流式注意:
- Anchor context:把坐标钉在场景上,避免地图整块滑走。
- Pose-reference window:用局部窗口里的稠密几何线索稳住当前位姿。
- Trajectory memory:对长轨迹做漂移修正,让后半段还能对上前半段。
推理侧配了分页 KV cache。官方推荐 FlashInfer,没有它就退回 PyTorch 自带的 SDPA。2026-06-28 修过 SDPA 的 KV cache 问题,长序列上 SDPA 比修之前稳,但仍建议用 FlashInfer。2026-04-24 还修过另一处:--keyframe_interval > 1 时,非关键帧被悄悄写进缓存;超过 320 帧后再跑,位姿和重建质量会差一截。2026-04-27 的加速入口是 --compile,也可以用 gct_profile.py --backend flashinfer --dtype bf16 --compile 在本机对一下。这几条都是仓库自己写的,不是第三方复现。
权重表里现在公开两档。lingbot-map 是论文、基准和离线演示用的平衡检查点,短序列和长序列一起折中。lingbot-map-stage1 是第一阶段训练检查点,可以装进 VGGT 做双向推理(c2w)。页面还写了一句“更强、更长序列的模型在训”,没有给发布时间。ModelScope 镜像是 Robbyant/lingbot-map。
超过训练窗,就改缓存策略,不要硬堆帧
训练用 video RoPE,窗口是 320 个视图。KV 里存超过 320 个视图,效果会掉。demo.py 会按序列自动算 --keyframe_interval:非关键帧仍出预测,只是不进缓存。官方还写明,默认不做 state reset,最大推理距离受训练集里见过的最远距离限制;超出之后如果位姿塌掉,再切 windowed。序列超过 3000 帧,README 建议这样跑:
python demo.py --model_path /path/to/lingbot-map.pt \
    --video_path video.mp4 --fps 10 \
    --mode windowed --window_size 128 --overlap_keyframes 16 --keyframe_interval 2
窗口按 KV 槽计数,不是按原始帧数。室内长视频示例大约 25000 帧、13 分钟,交互式 Viser 看不过来,要走 demo_render/batch_demo.py。那条离线管线还要 Kaolin,官方对齐的是 PyTorch 2.8.0 加 CUDA 12.8;只跑 demo.py 可以用更新的 PyTorch,但批量渲染就要自己编 Kaolin。室内预设里,window_size 128 的前 8 个槽留给 scale frames,剩下 120 个槽放关键帧。关键帧间隔如果按说明里的 13 来算,一个窗口覆盖 8 + 120 × 13 = 1568 原始帧。相邻窗口再重叠 8 个关键帧,用来对齐跨窗位姿。
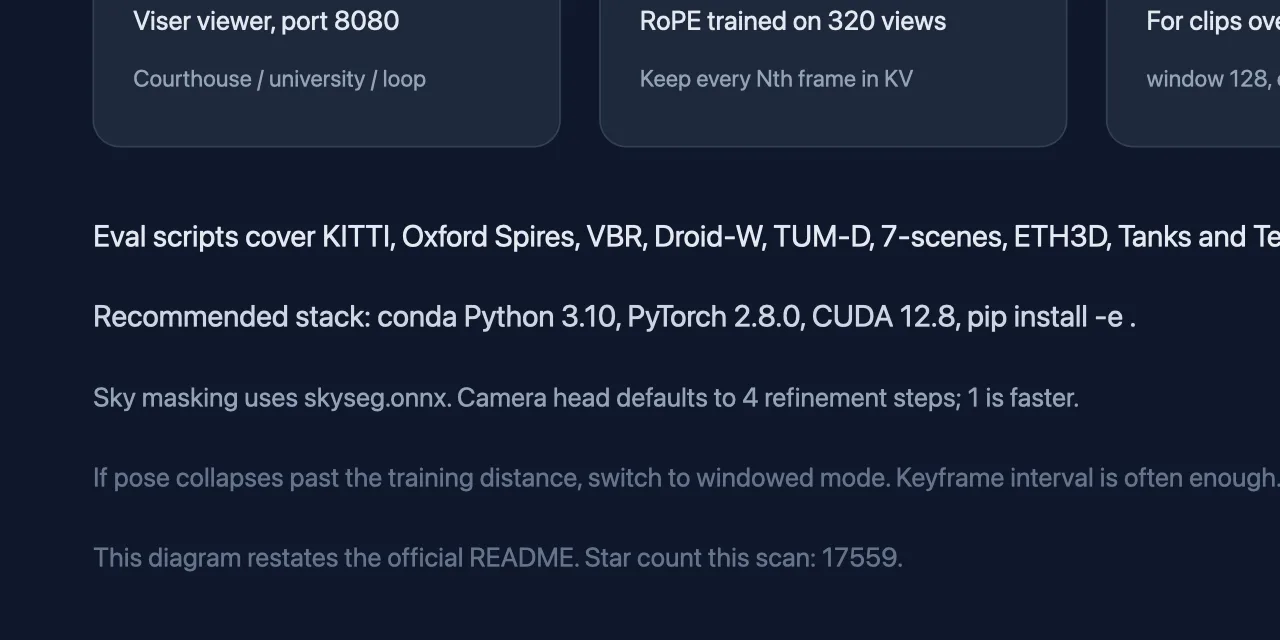
安装路径也写死了:conda 建 lingbot-map,Python 3.10,装 torch==2.8.0 和 torchvision==0.23.0,再 pip install -e .。可视化另装 .[vis],离线渲染再加 .[render],里面会拉 open3d>=0.19 和 pyyaml。底层还钉了 numpy<2。户外场景可加 --mask_sky,默认找当前目录的 skyseg.onnx,没有就从 Hugging Face 拉 JianyuanWang/skyseg。下载失败不会悄悄跳过,会抛 RuntimeError 并写明路径和地址。离线渲染用的是仓库自己发的 skyseg_batch.onnx。相机头默认 4 次迭代,--camera_num_iterations 1 会少三次精修,KV 也按 4 倍缩小。显存紧就保持默认的 --offload_to_cpu,或把 --num_scale_frames 从 8 降到 2。
Viser 默认端口 8080。点云显示还有 --conf_threshold 1.5、--point_size 0.00001、--downsample_factor 10。仓库自带三个可直接跑的示例:courthouse、university、loop。动态序列可从 robbyant/lingbot-map-demo 下,官方示例开了天空掩膜、4 次相机迭代、步长 2。
评测脚本已经开出来,数字仍以论文表为准
2026-05-25 起,仓库放出 KITTI 和 Oxford Spires 的评测脚本,Oxford 数据要先跑 preprocess/oxford.py。TODO 里还勾了 VBR、Droid-W、TUM-D、7-scenes、ETH3D、Tanks and Temples、NRGBD,以及室内、室外、航拍和 LingBot-World 的演示。README 只说在多样基准上优于现有流式方法和迭代优化方法,没有在首页再贴一张完整数字表。写进本文的硬指标,仍以 20 FPS、518×378、10000 帧、320 视图和 25000 帧室内示例为准。
离线渲染的产物也列得很清楚:<name>_pointcloud.mp4、<name>_pointcloud_rgb.mp4、配置快照 YAML,以及 batch_results.json。相机路径可以写成 follow、birdeye、static、pivot 四段,室内预设默认短景深、跟拍更紧。这些是演示管线,不是评测分数。
会议论文作者是 Chen Lin-Zhuo、Gao Jian、Zhang Shangzhan 等,ECCV 2026 页码 293 到 314。技术报告作者名单更长,编号仍是 2604.14141。仓库基于 VGGT、DINOv2 和 Flashinfer。本轮没有核到独立的第三方速度复现,20 FPS 按官方 README 记录。低显存社区实现有人另开过分支,那是第三方提交,本文不把它写成官方支持。
如果只想先看流式能否稳,按官方顺序就够:装环境、下平衡检查点、先跑短示例,再把超过 3000 帧的视频切到 windowed。不要一上来把全部帧都塞进 KV。这一步省下来的,不是应用层的技巧,而是跟训练窗对齐。