字节笔记本
2026年10月6日 · 约 10 分钟读完
CI 一红就写诊断日记:只读日志不动代码的救火工作流
CI 一红,多数团队的人肉流程是这样的:点进 Actions 页面,找到失败的 job,展开几百行日志,肉眼搜报错关键字,猜原因,再决定怎么修。真正耗时的往往不是修,而是「搞清楚哪里坏了」这一段。
本文介绍一条把这段流程交给 AI 的工作流设计。它的定位极其克制:CI 一红,AI 自动读日志、定位原因,把「红在哪、为什么、怎么修」写成一份精炼诊断,追加进仓库里的 ci-diary.md 文件。不推消息、不开 PR、不改代码。你想看的时候翻开日记,每条诊断都是决策就绪的 brief;修不修、怎么修,始终由人拍板。在 AI 自主程度的光谱上,这几乎是保守派的样板:AI 只动嘴,不动手。
触发:事件驱动,出事才跑
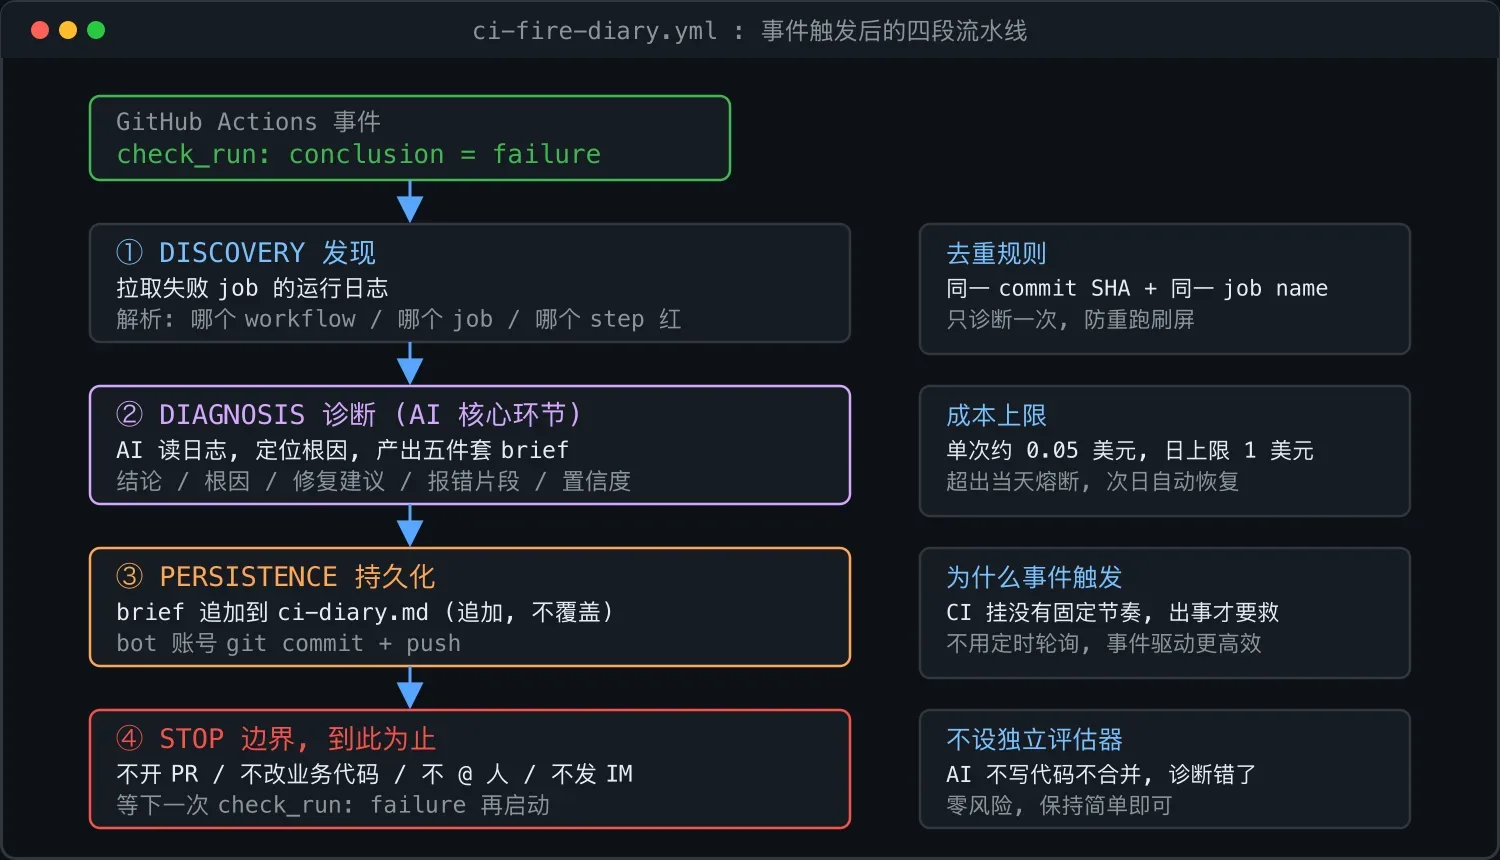
工作流监听 GitHub Actions 的 check_run 事件,且只在 conclusion 为 failure 时启动,cancelled 和 success 一律忽略。
为什么用事件触发而不是定时轮询?因为 CI 挂没有固定节奏,出事了才需要救。事件驱动的任务在这类场景下通常更高效:没有失败的日子它一次也不跑,失败高发的日子它逐次响应。
去重规则同样关键:同一个 commit SHA 加同一个 job name,只诊断一次。没有这条规则,一次重跑、多个 job 同时红,日记就会被同一条诊断刷屏。
四段流水线
第一段,发现。 拉取失败 job 的运行日志,解析出具体是哪个 workflow、哪个 job、哪个 step 变红。这一步不需要智能,只需要准确的定位信息。
第二段,诊断。 AI 读日志,输出五件套 brief,下文详述。这是整条工作流里唯一需要智能的环节。
第三段,持久化。 把 brief 追加到 ci-diary.md。注意是追加而不是覆盖,历史诊断全部保留;然后由 bot 账号提交并推送。
第四段,停止。 不开 PR,不改业务代码,不提及任何人,不发 IM 消息。循环到此结束,安静等下一次 check_run failure。
诊断日记:五件套 brief
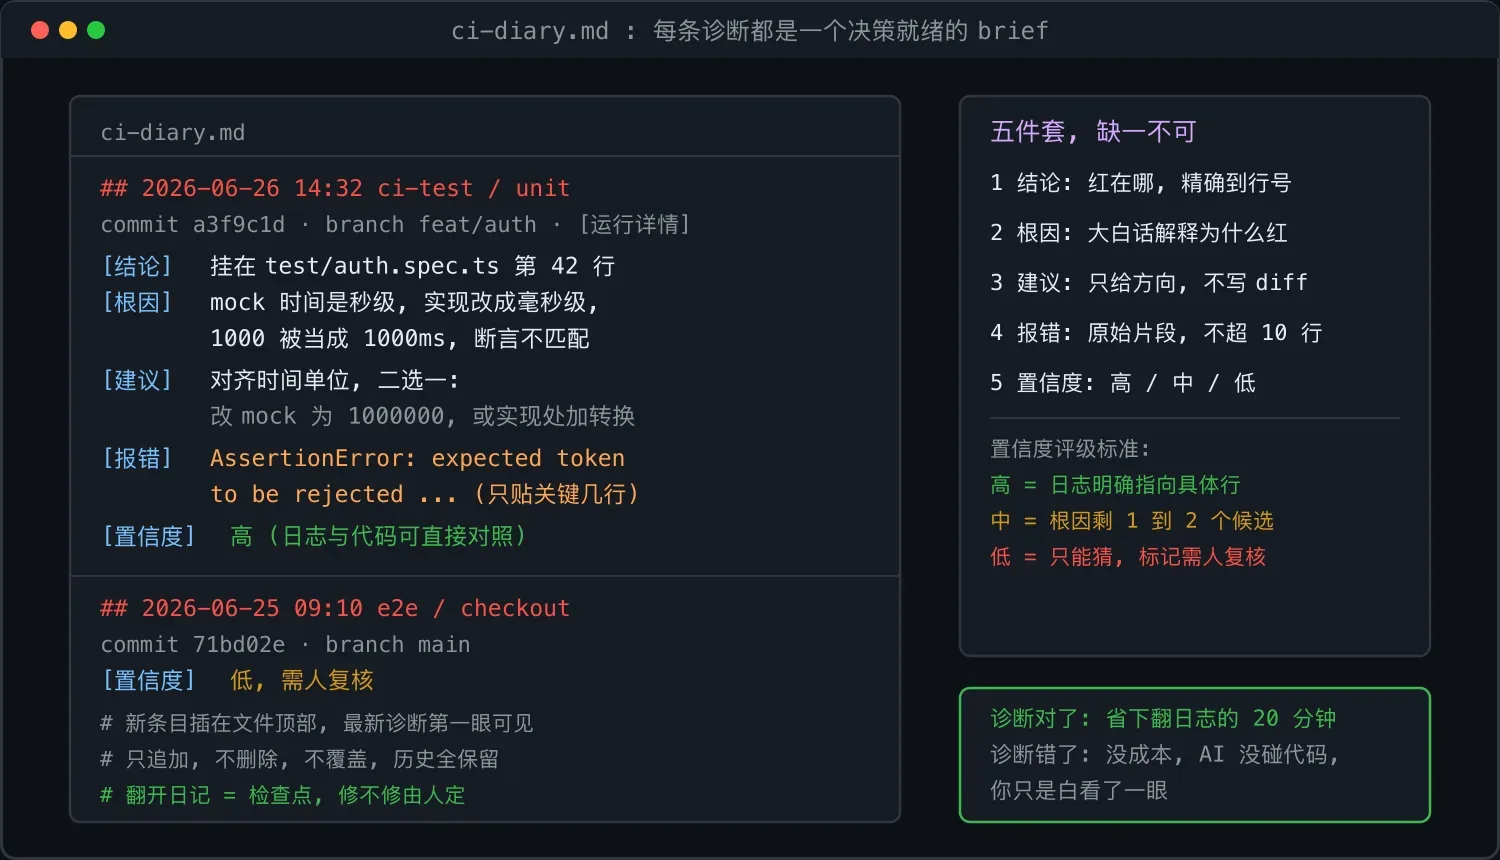
日记里每个条目固定五个部分,一个都不能少:
- 一句话结论:红在哪,精确到 job、测试或 step 和行号;
- 根因解释:用大白话说清楚为什么红,不堆术语;
- 修复建议:只给方向,不写完整 diff;
- 原始报错片段:只贴关键几行,上限十行,不把日志整段搬进来;
- 置信度:高、中、低三档。高意味着日志明确指向具体行、错误类型可对照;中意味着能缩小范围但根因还剩一两个候选;低意味着只能猜,必须显式标记需人复核。
一份合格的条目长这样(示例):
## 2026-06-26 14:32  workflow: ci-test / job: unit

commit: a3f9c1d · branch: feat/auth · [运行详情链接]

**结论**
红的 job 是 unit,挂在 test/auth.spec.ts 第 42 行
的 should reject expired token。

**根因**
测试的 mock 时间是秒级数值,新代码把 token 过期判断
从秒级改成了毫秒级,mock 的 1000 被当成 1000ms 而非
1s,断言不匹配。

**修复建议**
二选一:把 mock 时间改成 1000000 对齐毫秒;或在过期
判断处加单位转换。

**原始报错**
AssertionError: expected token to be rejected
  at test/auth.spec.ts:42:18

**置信度**:高(日志明确,mock 与实现的单位不一致可直接对照)
条目默认插在文件顶部,最新诊断第一眼可见;写入前先按 SHA 加 job name 查重,已有就跳过。
为什么不需要独立评估器
循环工程里有个常见设计:生成器与评估器分离,让另一个模型独立检验产出的代码。但这套工作流用不上,因为 AI 全程不写代码、不合并。诊断写错了,你翻日记时自然会发现,零风险。独立评估器是给「AI 自动改代码」的场景准备的;AI 只出报告的场景,保持简单才是对的。
检查点:翻开日记的那一刻
这条工作流没有主动检查点,不等人确认,跑完即止。但循环工程强调「永远留一扇门」,这里留的是被动检查点:你翻开 ci-diary.md 的那一刻就是检查点。诊断错了?没成本,AI 没碰代码,你只是白看了一眼。诊断对了?你省下了翻日志的二十分钟。
这也是「把推进做到极致」思路的一个极端版本:AI 把活全干完,读日志、定位、解释、建议,人只在自己选择的时刻介入,而且面对的是一份精炼 brief,不是一坨原始日志。
边界清单
| 不做什么 | 为什么 |
|---|---|
| 不改业务代码 | 自主程度最保守,修不修人定 |
| 不开 PR | 同上 |
| 不提及任何人 | 输出渠道就是文件,不打扰 |
| 不发 IM、邮件 | 同上 |
| 不删、不覆盖旧条目 | 日记是累积的,历史有价值 |
| 不读 node_modules 与构建产物 | 只看 CI 日志,定位需要时对源码也只读不写 |
成本护栏
单次诊断上限约 0.05 美元,约合 10000 输入 token 加 1000 输出 token;日上限一美元,约合每天二十次诊断,超出当天熔断,次日自动恢复。实现上可以在诊断脚本里做 token 计数加软上限检查,也可以直接在模型服务商后台设消费限额。护栏防的是某个反复失败的分支把账单烧穿,这是「先设上限再上线」原则的直接应用。
怎么落地
落地只需四步,每一步都有明确的验收口径:
- 在仓库放好触发器
.github/workflows/ci-fire-diary.yml,监听 check_run 的 completed 事件,条件过滤 conclusion 为 failure,并给足权限:contents 写权限用于提交日记,actions 读权限用于拉日志; - 写出诊断脚本,满足行为契约:读日志目录,输出五件套,置信度按评级标准打分,追加进 ci-diary.md;
- 配置模型 API key 的 secret;
- 手动触发一次失败,故意让一个测试红,确认 ci-diary.md 出现一条格式正确的 brief。
触发器骨架如下,诊断逻辑独立成脚本,方便单独测试与复用:
name: ci-fire-diary
on:
  check_run:
    types: [completed]

jobs:
  diagnose:
    if: github.event.check_run.conclusion == 'failure'
    runs-on: ubuntu-latest
    permissions:
      contents: write
      actions: read
    steps:
      - uses: actions/checkout@v4
      - name: 拉失败日志
        env: { GH_TOKEN: ${{ secrets.GITHUB_TOKEN }} }
        run: |
          RUN_ID=${{ github.event.check_run.run_id }}
          gh api "repos/${{ github.repository }}/actions/runs/$RUN_ID/logs" > logs.zip
          unzip -o logs.zip -d ./logs/
      - name: AI 诊断并写日记
        env:
          ANTHROPIC_API_KEY: ${{ secrets.DIARY_API_KEY }}
        run: node scripts/ci-diagnose.mjs
      - name: 提交日记
        run: |
          git config user.name "ci-fire-diary-bot"
          git config user.email "bot@ci-diary.local"
          git add ci-diary.md
          git commit -m "ci-fire-diary: update diary" || echo "no change"
          git push
写在最后
这条工作流回答了一个很实际的问题:AI 参与工程的切入点,不一定非得是替人写代码。读日志、写诊断这类高频、低风险、产出天然是文本的活,交给 AI 几乎零门槛,省下的时间却实实在在。如果你的 CI 天天红、日志天天翻,值得照着这套规格搭一条。