字节笔记本
2026年10月5日 · 约 29 分钟读完
Cloudflare 上线 GLM-5.2:每天免费额度跑编码模型
01 / 一条让人坐直的推文
2026 年 6 月底,推特上一条推文炸了。
如何 $0 免费用 GLM-5.2:通过 Cloudflare Workers AI,免费、无每日限额。 你朋友每月花 $20-200 在 coding agent 上,你 $0 拿到同样的强悍性能。
:这是 painn(@_0xpainn)发的,配了一个 5 分钟配置教程。
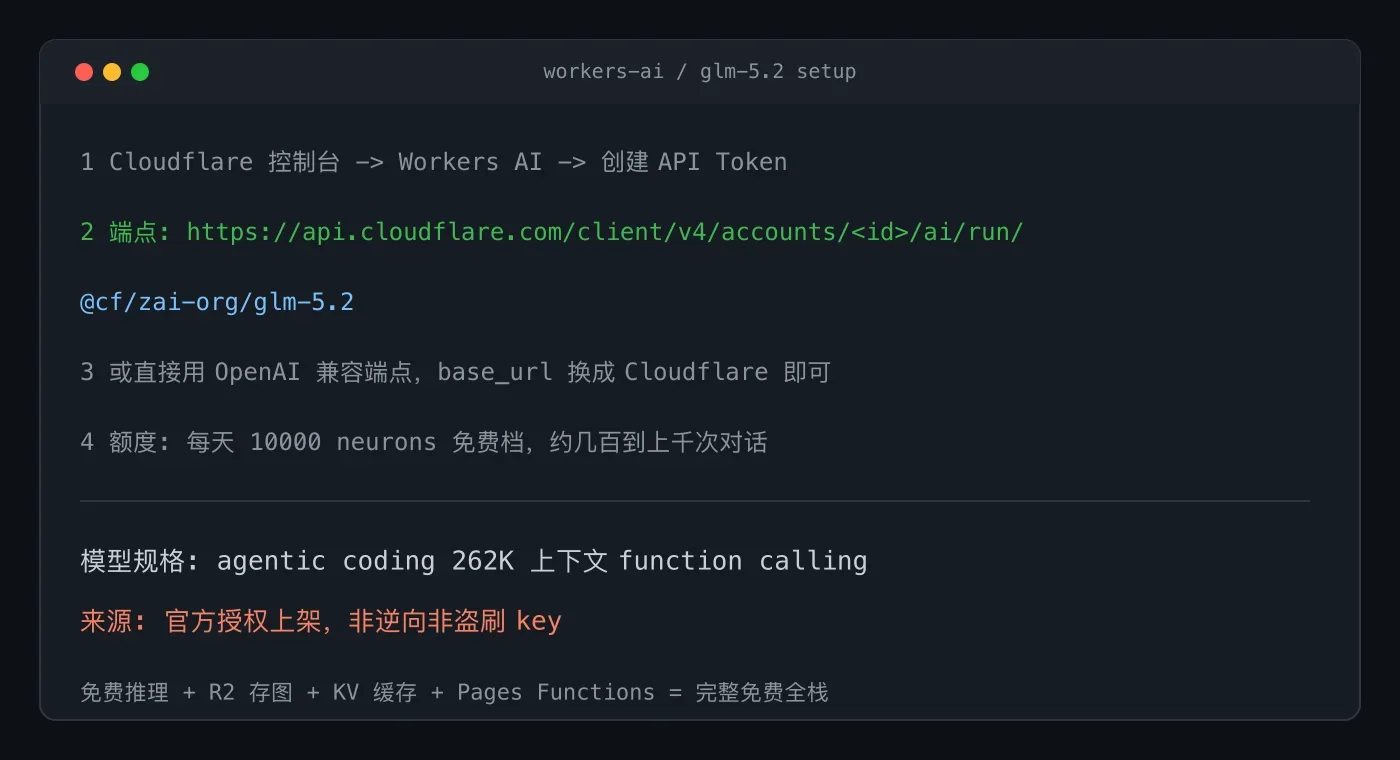
推文的核心信息很简单:Cloudflare 的 Workers AI 平台,上线了 GLM-5.2(模型 ID @cf/zai-org/glm-5.2),可以免费调用,不需要信用卡、不需要订阅、没有月费。
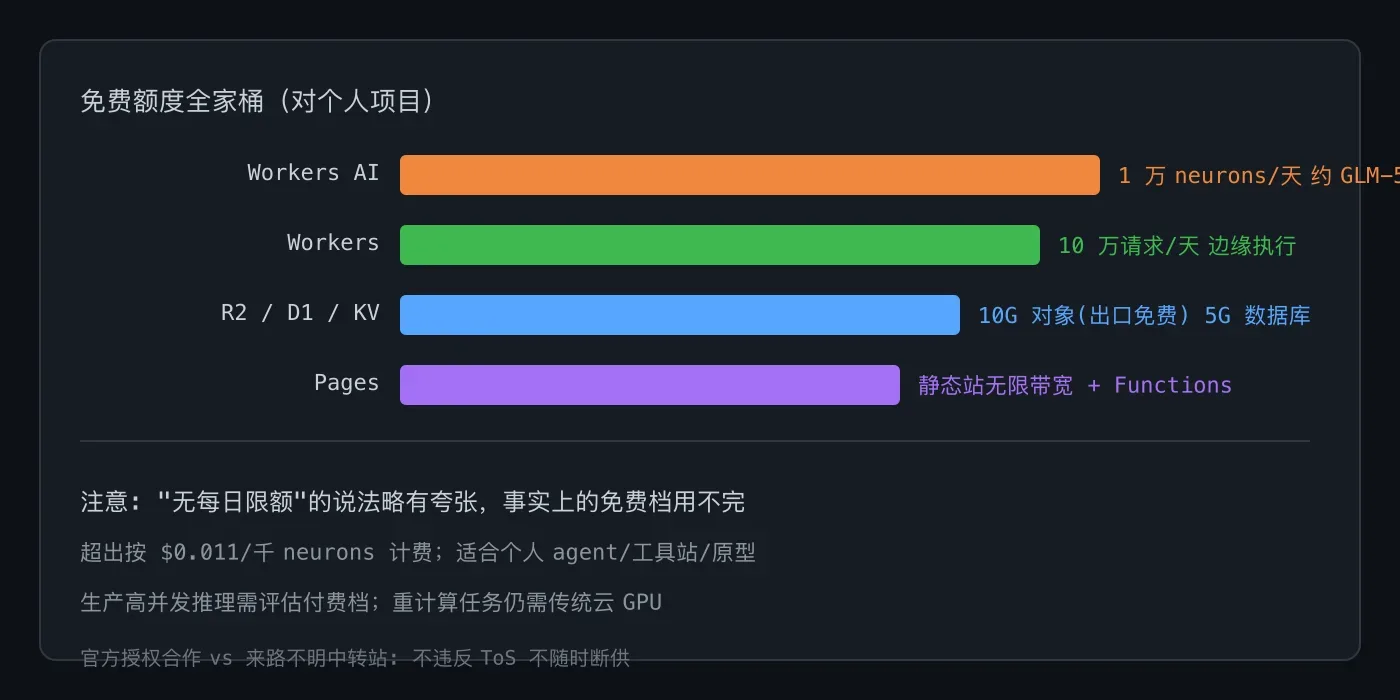
⚠️ 一个事实核查:painn 推文里说"无每日限额(no daily limit)"是有点夸张的。Cloudflare 官方给的是每天 10,000 个 neurons 的免费额度,超出后按 $0.011/千 neurons 计费。但 1 万 neurons 折算下来,每天能跑几百到上千次对话:对绝大多数个人开发者和工具站来说,等于用不完。所以"事实上的免费"成立,但严格意义上的"无限制"是夸大。
这个消息为什么值得注意?因为 GLM-5.2 不是个玩具模型。
它是 Z.AI(智谱)2026 年的旗舰编码模型,专门为 agentic coding(智能体编程)设计,原生支持:
- 🧠 强大的 agentic 编程能力:能自己拆解任务、调用工具
- 📚 262K 上下文窗口:一次性塞进整个中型代码库
- 🔧 Function calling(工具调用):能调外部 API、执行命令
- 🔌 OpenAI 兼容端点:改个地址就能从 GPT 切过来
放在半年前,这种规格的模型,要么你得付 OpenAI $5/$30 的 API 费,要么得用各种来路不明的中转。而现在,Cloudflare 直接给你免费用了。
这就是为什么有人管 Cloudflare 叫"赛博菩萨"。
02 / 为什么是 Cloudflare,不是别家
免费的大模型 API,网上一直有。但绝大多数都踩雷。painn 推文底下有人总结过:
| 来源 | 坑 |
|---|---|
| 来路不明的中转站(0.3 倍率那种) | 用逆向账号/盗刷 key 供给,账号随时被封,数据被偷看 |
| Google AI Studio 的免费档 | 区域限制、配额卡得严、模型不是最新 |
| HuggingFace Spaces | 经常排队、不稳定、不适合生产 |
| 国内"免费 API"推广 | 引流钩子,几天后开始收费或跑路 |
Cloudflare 的 GLM-5.2 不一样,因为:
- 它是官方授权的合作:Z.AI 把模型放到 Cloudflare 平台,不是逆向、不是盗刷
- 它是 Cloudflare 自己的产品:背后是 Cloudflare 全球 330+ 城市的边缘 GPU 节点
- 它的免费额度是"永久免费档":不是 12 个月试用,不是"前 100 次"
- 它默认在边缘跑:你的推理请求由离你最近的 GPU 节点处理,延迟低
最关键的是第 1 点。市面上那种"3 毛钱 1 美刀额度"的中转站,那种价格的来源,几乎都是逆向账号或盗刷 key,违反 ToS、随时断供、数据被偷看。Cloudflare 这种是模型方主动放出来的官方免费,性质完全不同。
赛博菩萨的恩赐,得是干净的恩赐。
03 / 五分钟接入:把免费的 GLM-5.2 接到你的工具里
讲这么多,不如动手。这一节,我们用最少步骤把免费的 GLM-5.2 跑起来。
方式一:一行 curl 调用(最快体验)
curl https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai/v1/models/@cf/zai-org/glm-5.2 \
  -H "Authorization: Bearer $CF_API_TOKEN" \
  -d '{
    "messages": [
      {"role": "user", "content": "用 Python 写一个快速排序,注释要详细"}
    ]
  }'
两个变量:
$ACCOUNT_ID:Cloudflare 控制台右侧栏的 Account ID$CF_API_TOKEN:去 cloudflare.com → My Profile → API Tokens 创建一个有 Workers AI 权限的 token
跑通这一行,你就已经在免费调用 GLM-5.2 了。
方式二:接到 Claude Code / Cursor / Aider 里(让 AI 编程助手免费)
这是 painn 推文的核心卖点。因为 GLM-5.2 是 OpenAI 兼容端点,任何吃 OpenAI API 的工具都能直接切过来。
Cursor 配置(Settings → Models → Custom):
Base URL: https://api.cloudflare.com/client/v4/accounts/YOUR_ACCOUNT_ID/ai/v1
Model: @cf/zai-org/glm-5.2
API Key: 你的 CF API Token
Claude Code / OpenCode 配置:
export OPENAI_BASE_URL="https://api.cloudflare.com/client/v4/accounts/YOUR_ACCOUNT_ID/ai/v1"
export OPENAI_API_KEY="你的-CF-API-Token"
# 然后启动你的 coding agent,选 GLM-5.2
改两行配置,你月付 $20 的 coding agent,立刻变成 $0。
方式三:在 Worker 里调用(边缘 + AI)
最酷的玩法:把 GLM-5.2 跑在 Cloudflare 的边缘计算里:
// worker.js
export default {
  async fetch(request, env) {
    const { prompt } = await request.json();
    const result = await env.AI.run("@cf/zai-org/glm-5.2", {
      messages: [{ role: "user", content: prompt }]
    });
    return Response.json(result);
  }
};部署后,你拥有了一个全球分布、自动扩缩容、免费起步的 AI 推理 API。
04 / 但赛博菩萨的恩赐,远不止 GLM-5.2
如果你以为 Cloudflare 只是"免费给你跑大模型",那是对它的严重低估。
painn 的推文只是个引子。真正有意思的故事是:Cloudflare 整个平台都在免费送。从计算到存储,从网络到数据库,免费额度大到能让一个独立开发者的全部基础设施零成本跑起来。
很多人对 Cloudflare 的印象停留在"免费 CDN"。但今天的 Cloudflare 已经长成了一个横跨计算、存储、网络、AI 的全球分布式云平台。
人类对 Cloudflare 的开发程度,不到它能力的 5%。
下面,我们从 GLM-5.2 这个"入口"往外扩,看看赛博菩萨到底给你准备了什么。
05 / 计算:你的代码,跑在全球 330 个城市
Cloudflare 最革命性的产品叫 Workers,它和传统云服务器的逻辑完全不同。
传统云:你租一台机器(或容器),代码跑在那台机器上,全球用户请求都路由到这台机器。延迟高、要扩缩容、要运维。
Workers 的模型:你写一段 JavaScript / TypeScript / Python / Rust 代码,上传后这段代码会被复制到 Cloudflare 全球所有节点。用户请求由离他最近的节点直接执行。
传统云:上海用户 ──→ us-east-1 大区 ──→ 你的实例
Cloudflare:上海用户 ──→ 香港节点 ──→ 直接执行 Worker 代码
这意味着:
- 延迟低:每个用户都连最近的节点
- 无需扩缩容:从 10 次到 1000 万次,自动应对
- 冷启动几乎为零:用的是 V8 isolate(和 Chrome 同源),不是 Docker,启动在毫秒级
免费额度:每天 10 万次请求,永久免费。
一个最小例子:
export default {
  async fetch(request) {
    const city = request.cf?.city ?? "unknown";  // 自动注入访问者位置
    return new Response(`Hello from ${city}!`);
  }
};
request.cf 是 Cloudflare 给你的超能力:每个请求都自带访问者国家、城市、时区、ASN。一行代码部署全球:
npm create cloudflare@latest my-worker
npx wrangler deploy
⚠️ CPU 时间限制:免费版每次请求 10ms CPU 时间(不是墙钟时间,是真正执行计算的时间;等数据库 IO 不算)。一个"转发 + 简单处理"的 Worker 绰绰有余,但做加密计算、图片处理会触限。
06 / 存储:三种形态,覆盖你所有数据
有计算就要有存储。Cloudflare 给了三个主力产品。
R2:对象存储(对标 AWS S3)
存文件、图片、视频、备份。API 完全兼容 S3,所有 S3 工具改个地址就能用。
它最香的一点不是存储本身,是出口流量免费:
| 项 | Cloudflare R2 | AWS S3 |
|---|---|---|
| 存储 | $0.015/GB·月 | $0.023/GB·月 |
| 出口流量 | $0 | $0.09/GB |
| 免费额度 | 10GB 存储 | 5GB(仅首年) |
对有大量下载流量的场景(图片站、视频站、软件分发),S3 出口费是云账单大头。R2 直接砍掉这一项。
D1:SQL 数据库(SQLite 的全球分布版)
底层是 SQLite,但是全球分布的读副本 + 单点写入。读可以就近完成(快),写路由到主库。读多写少的应用特别合适。
| 项 | 免费版 |
|---|---|
| 存储 | 5GB |
| 行读取 | 500 万行/天 |
| 行写入 | 10 万行/天 |
在 Worker 里查询:
const result = await env.DB.prepare(
  "SELECT * FROM posts ORDER BY created_at DESC LIMIT 10"
).all();
KV:键值存储
最简单的存储:key 对 value,全球分布,读取几十毫秒。适合存配置、缓存、特征开关。
| 项 | 免费版 |
|---|---|
| 存储 | 1GB |
| 读取/写入 | 各 10 万次/天 |
三者怎么选:文件/图片/视频 → R2;结构化业务数据 → D1;简单 key-value 缓存 → KV。
07 / 托管:静态站 + 后端,一站搞定
如果你只想托管一个静态网站(博客、文档、落地页、SPA),Pages 是最省事的选择。
| 项 | 免费版 |
|---|---|
| 项目数 | 100 个 |
| 带宽 | 无限 |
| 请求数 | 无限 |
"无限带宽"是另一个反 AWS 的设计:S3 + CloudFront 托管静态站,流量大了账单难看;Pages 是真的零成本。
接入方式:连 GitHub/GitLab,push 自动部署。或者一行命令:
npx wrangler pages deploy ./distPages Functions 让你在静态站里直接写后端:本质是 Workers,但和 Pages 一体化。文件即路由:
functions/api/users.js    →  /api/users
functions/projects/[id].js → /projects/123放个文件,访问对应路径就能跑后端代码。全栈一站搞定。
08 / AI:不止 GLM-5.2,是一整个模型库
回到开头。Workers AI 不只有 GLM-5.2,而是一个模型仓库,把主流开源模型都搬到边缘节点。
- 文本生成:GLM-5.2、Meta Llama 系列、Mistral、Microsoft Phi、Qwen
- 图像生成:Stable Diffusion 系列
- 语音:Whisper(识别)、翻译
全部走同一套 API,全部享受 每天 1 万 neurons 的免费额度。换模型只是改个 ID:
// 从 GLM-5.2 换成 Llama,只改一个字符串
await env.AI.run("@cf/meta/llama-3.3-70b-instruct-fp8-fast", { ... })
还有一个叫 AI Gateway 的产品:把你对各种 LLM 的调用(OpenAI、Anthropic、Workers AI)统一走 Cloudflare 代理,提供缓存、限流、监控、故障转移。一个地方管所有 AI 流量。
组合玩法:用 Workers AI 跑免费推理,用 R2 存 AI 生成的图片,用 KV 缓存常见问答,用 Pages Functions 暴露 API:一个完整的 AI 应用,全部跑在免费额度里。
09 / 自动化与高级能力
还有几个产品,把 Cloudflare 从"基础设施"推向"自动化平台"。
Cron Triggers(定时触发)
给 Worker 加 cron,类似定时任务。这正好**Loop Engineering(循环工程)**的经典实现:一个 Cron Trigger + 一个 Worker,就是最小可用的循环:
# wrangler.toml
[triggers]
crons = ["0 6 * * *"]   # 每天早上 6 点跑
Durable Objects(全球唯一有状态对象)
Workers 体系里最黑科技的产品。普通 Worker 无状态,但有些场景必须有状态:实时协作、WebSocket 长连接、限流计数器。Durable Objects 给你"全球只有一个实例"的对象。
Tunnel(cloudflared)
反向隧道:不用公网 IP、不用开端口,把内网服务安全暴露到互联网。
cloudflared tunnel --url http://localhost:3000一行命令给你一个 *.trycloudflare.com 临时域名,指向本机。本地开发、内网穿透、临时演示的瑞士军刀。我们前面做 dev-sync 插件时,就是用类似机制连远程的。
10 / 拼起来:用免费额度搭一个完整的应用
讲这么多组件,不如拼一个完整的东西。我们用上面所有产品,搭一个AI 留言板,它覆盖了所有核心组件。
架构:
用户 → Pages(前端)
         ↓
       Pages Functions(后端 API)
         ↓
       D1(存留言)+ R2(存图片)+ KV(缓存)
         ↓
Workers AI(GLM-5.2 自动回复评论)全部免费额度内,每月成本:0 元。
Step 1:建项目 + 数据库
npm create cloudflare@latest my-app
cd my-app
npx wrangler d1 create mydb
配置 wrangler.toml,建表:
npx wrangler d1 execute mydb --command \
  "CREATE TABLE messages (id INTEGER PRIMARY KEY, content TEXT, ai_reply TEXT, created_at INTEGER)"
Step 2:写后端 + AI 自动回复
functions/api/messages.js:
export async function onRequestPost({ request, env }) {
  const { content } = await request.json();

  // 存到 D1
  await env.DB.prepare(
    "INSERT INTO messages (content, created_at) VALUES (?, ?)"
  ).bind(content, Date.now()).run();

  // 用免费的 GLM-5.2 生成 AI 回复
  const ai = await env.AI.run("@cf/zai-org/glm-5.2", {
    messages: [
      { role: "system", content: "你是一个友好的留言板管理员,用一句话温暖地回复用户。" },
      { role: "user", content }
    ]
  });

  // 更新回复 + 失效 KV 缓存
  await env.DB.prepare("UPDATE messages SET ai_reply = ? WHERE id = last_insert_rowid()")
    .bind(ai.result.response).run();
  await env.CACHE.delete("recent");

  return Response.json({ ok: true, reply: ai.result.response });
}

export async function onRequestGet({ request, env }) {
  const cached = await env.CACHE.get("recent");
  if (cached) return new Response(cached, { headers: {"content-type":"application/json"}});
  const { results } = await env.DB.prepare(
    "SELECT * FROM messages ORDER BY created_at DESC LIMIT 50"
  ).all();
  await env.CACHE.put("recent", JSON.stringify(results), { expirationTtl: 60 });
  return Response.json(results);
}
Step 3:部署
npx wrangler pages deploy .三步走完,你拥有一个:全球分布、自动扩缩容、带数据库和缓存、AI 自动回复的留言板,0 元成本。
而这只是个开始:把 GLM-5.2 的回复换成"自动分析留言情绪"、"自动生成摘要"、"自动翻译多语言",都是改几行 prompt 的事。
11 / Cloudflare 的边界:什么时候不该用它
讲了这么多好处,也得诚实说边界。Cloudflare 不是万能的。
不适合的场景:
- 重计算、长 CPU 任务:视频转码、模型训练、大数据 ETL:Workers 的 CPU 限制挡住了。这些还是得传统云 GPU 实例。
- 深度依赖特定云:架构绑死 AWS(Lambda + DynamoDB + SQS 那种),迁移成本高。
- 数据驻留严格合规:金融、医疗要求数据不出境,需单独评估。
- 超大规模数据库:D1 是 SQLite 内核,对超高并发写入、复杂事务不如 Postgres。
最适合的场景:个人项目、独立开发者产品、MVP、读多写少的内容站/API/Bot、想零成本验证想法、面向全球用户。
对 GLM-5.2 这个"入口"来说:个人 coding agent、工具站、原型开发、玩具项目:完美;生产环境高并发推理:免费额度撑不住,得评估付费档。
12 / 赛博菩萨的真正野心
回到那句话:赛博菩萨的恩赐。
Cloudflare 在做的事,本质是用"边缘"重写云计算。
传统云计算(AWS、GCP、Azure)的模型是"中心化大区":代码和数据放在几个巨型数据中心,用户从全球连过来。这套模型统治了过去十五年,但它的瓶颈是延迟和出口费。
Cloudflare 提出的替代方案是"边缘优先":代码和数据下沉到离用户最近的地方。而它用免费额度作为获客手段,让开发者在第一天就默认在 Cloudflare 上构建,等业务长大了自然留在生态里。
这个策略很奏效。越来越多的独立开发者、小团队,整个技术栈就是 Cloudflare 一家:DNS、CDN、Workers、R2、D1、Pages、AI,全免费起步,长大了才按量付费。这是对 AWS 模式的正面挑战。
GLM-5.2 的免费,是这个战略的最新一步。它不是孤立的"福利",是整个"免费边缘云"拼图的一块,把"免费推理"加进来,让开发者连 AI 这一层都不必离开 Cloudflare。
当一个平台给你:免费 CDN + 免费计算 + 免费存储 + 免费数据库 + 免费静态托管 + 免费大模型推理:你不是它的客户,你是它"对抗 AWS"叙事的一部分。而它换你的方式,是让你用得舒服到舍不得走。
13 / 怎么开始:五天行动清单
看完想动手?这是建议路径:
第 1 天:免费 GLM-5.2
- 注册 Cloudflare 账号
- 用一行 curl 调用 GLM-5.2(见第 03 节)
- 接到 Cursor / Claude Code 里,体验 $0 的 coding agent
第 2 天:感受边缘计算
- 用
npm create cloudflare@latest创建第一个 Worker - 部署一个返回"Hello from {city}"的 Worker
- 感受全球分发的速度
第 3 天:加存储
- 创建 D1 数据库,建张表
- 在 Worker 里读写
- 创建 R2 桶,上传文件,在 Worker 里读
第 4 天:全栈
- 创建 Pages 项目,连 Git
- 加 Pages Functions 写 API
- 接 D1 + KV,搭一个最小全栈应用
第 5 天:玩自动化
- 给 Worker 加 Cron Trigger,每天定时跑
- 装 cloudflared,体验内网穿透
- 用 AI Gateway 代理你对其他 LLM 的调用
五天走完,你对 Cloudflare 的开发程度,就超过 95% 的人了。
写在最后
"赛博菩萨"这个梗,半是调侃,半是真心。
调侃在于:免费的午餐通常有代价(数据被卖、服务被关、配额被砍)。真心在于:Cloudflare 这套免费额度,是行业里少见的、真正能用起来的、官方授权的福利。它不是钩子,是战略:Cloudflare 用它换开发者生态,开发者用它换零成本起步。双赢。
GLM-5.2 的免费,是这条逻辑的最新礼物。它让"用最强编码模型"这件事,第一次和"花钱"解绑。
但真正值得花时间理解的,是 GLM-5.2 背后那整个 Cloudflare 平台:从计算到存储,从网络到 AI,从自动化到边缘有状态。人类对它的开发程度还不到 5%。
剩下那 95%,等你去开垦。
本文提到的免费额度基于 2026 年 6 月 Cloudflare 官方文档。Workers AI 每日 1 万 neurons、Workers 每日 10 万请求、R2 10GB 存储、D1 5GB、KV 1GB、Pages 无限带宽。具体限制以官网实时为准。
参考来源:
- Cloudflare Changelog – GLM-5.2 上线 Workers AI(2026-06-16)
- Cloudflare Workers AI – GLM-5.2 模型文档
- Cloudflare Workers 限制
- Cloudflare R2 定价
- Cloudflare Pages 限制
- Cloudflare Workers AI 定价(neurons)
- painn 推文(@_0xpainn, 2026-06-26)关于免费 GLM-5.2 的配置教程