字节笔记本
2026年11月3日 · 约 3 分钟读完
20tok/s 不是本地的锅:DeepSeek 4.1 Flash 本地部署的真实门槛
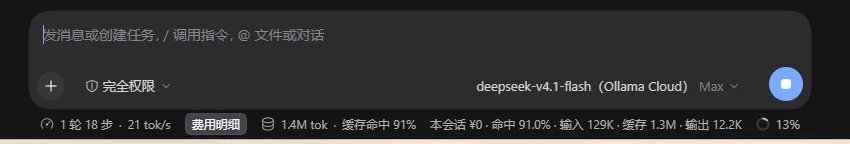
V2EX 网友 11 月 3 日发帖:「我这 4.1 flash 已经都 20tok/s 了,人快疯」。但仔细看原帖回复就会发现,这不是本地部署的速度,而是 Ollama 客户端连了某个第三方 DeepSeek 4.1 Flash 中转服务,「应该是节点问题,过了一会儿就好了,我这个是显示名,内部是1017」。20tok/s 是中转节点的临时波动,和本地部署无关。这篇把它当引子,拆一拆 DeepSeek 4.1 Flash 本地部署的真实门槛。
一、模型本体:763B 的 MoE
DeepSeek V4.1 Flash,763B 参数 MoE(骨干 552B 加约 196B Engram 查表),MIT 协议开源,1017 版本 10 月 17 日放出。GGUF 权重体积:2-bit 约 264.5GB、4-bit 约 444.7GB、8-bit 约 508GB;4-bit 最低显存(8K 上下文)约 446GB。这个量级直接把消费级硬件的门槛抬到了 512GB 统一内存的 M3 Ultra Mac Studio,这是目前唯一现实的消费级路径;或者 4 张 96GB RTX PRO 6000 加 vLLM 官方权重。
二、实测速度:第三方数据
社区开发者 IngeniousIdiocy 在 512GB M3 Ultra 上的实测:串行解码 8,192 token 前缀,优化版 31.25 t/s(上游未修改版 16.56);300,000 token 前缀,优化版 28.27 t/s;DSpark 投机解码在真实 agent 轮次做到 41.29 t/s。另一条路径是 4 张 96GB RTX PRO 6000 加 vLLM 官方权重,4-bit 约 68 t/s。人类阅读速度参考值约 15 到 20 tok/s,所以本地跑 4.1 Flash 的速度在「能用」和「舒适」之间。
三、甜蜜与痛苦
甜蜜的一面:隐私(数据不出本地)、无 per-token 账单、1M 上下文本地随便用、MIT 协议。痛苦的一面:硬件门槛极高(446GB 量级);架构特殊,Engram 查表导致主线 llama.cpp 不支持,要用 ik_llama.cpp;16 到 40 t/s 的速度只是「能用」级别;Ollama 官方模型库可能还没上架,只能自己写 Modelfile 导入 GGUF。
四、「显示名 vs 内部模型」的迷雾
原帖暴露的不只是速度问题,还有一个更普遍的困惑:很多人分不清自己用的到底是本地模型还是 API 网关的别名。Ollama 的「显示名」可以指向任何后端,本地 GGUF、远程 API 中转,甚至混着配。排查速度问题,第一步是确认你到底连的是哪:本地模型的速度取决于硬件,远程 API 的速度取决于中转节点,两者完全不可比。
五、判断
本地跑 4.1 Flash 的真正问题不是速度够不够快,而是「能不能跑起来」。446GB 显存的门槛意味着绝大多数人只能通过中转服务来用这个模型,而中转服务的速度波动,和本地部署无关。如果你真有一台 512GB 的 Mac Studio,31 t/s 已经比中转稳定得多;如果没有,那 20tok/s 的中转波动不值得焦虑。
来源:LINUX DO 原帖 linux.do/t/topic/3113123/1(第一手,2026-11-03);jxxy.net(512GB M3 Ultra 实测);vramglass 模型页;mobdome 本地部署教程。