字节笔记本
2026年10月6日 · 约 9 分钟读完
给 DeepSeek Harness 写一个模型工具
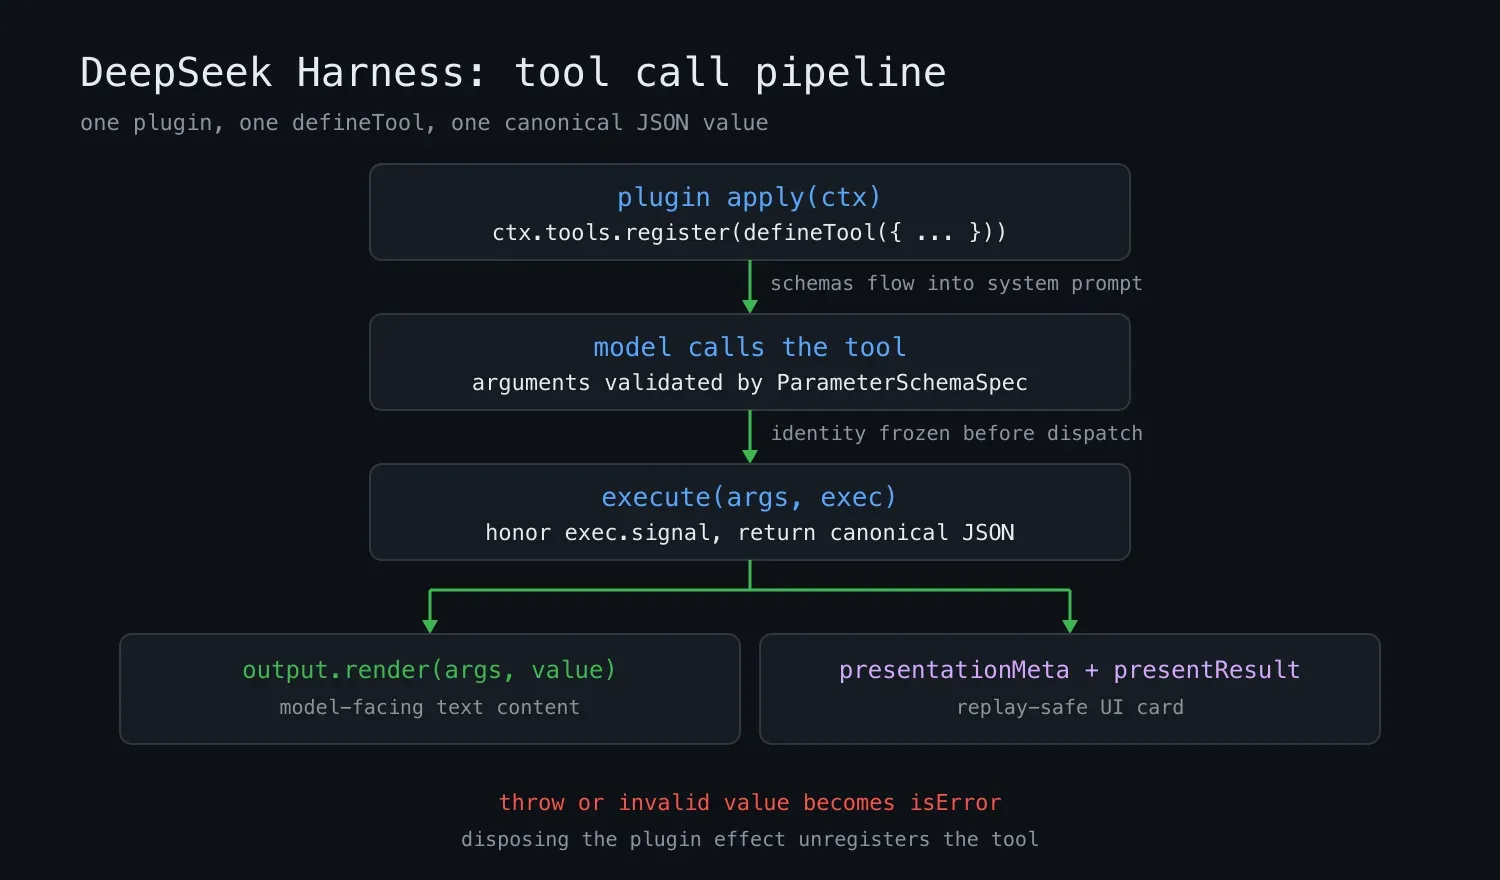
在 DeepSeek 开源的智能体框架 DeepSeek Harness 里,插件体系负责把能力装进 agent,而模型真正能动手干活的部分,几乎都通过工具完成。读文件、跑命令、搜索网页,对模型来说都是一次工具调用。工具写得好不好,直接决定模型用得顺不顺:参数说明含糊,模型就会传错参;返回值没有结构,调用方就得去解析自然语言。框架仓库的 cookbook 里有一篇工具编写参考,把模型可见的工具必须满足的契约写得相当细,本文把它整理成中文导读。
最小形态:一个插件注册一个工具
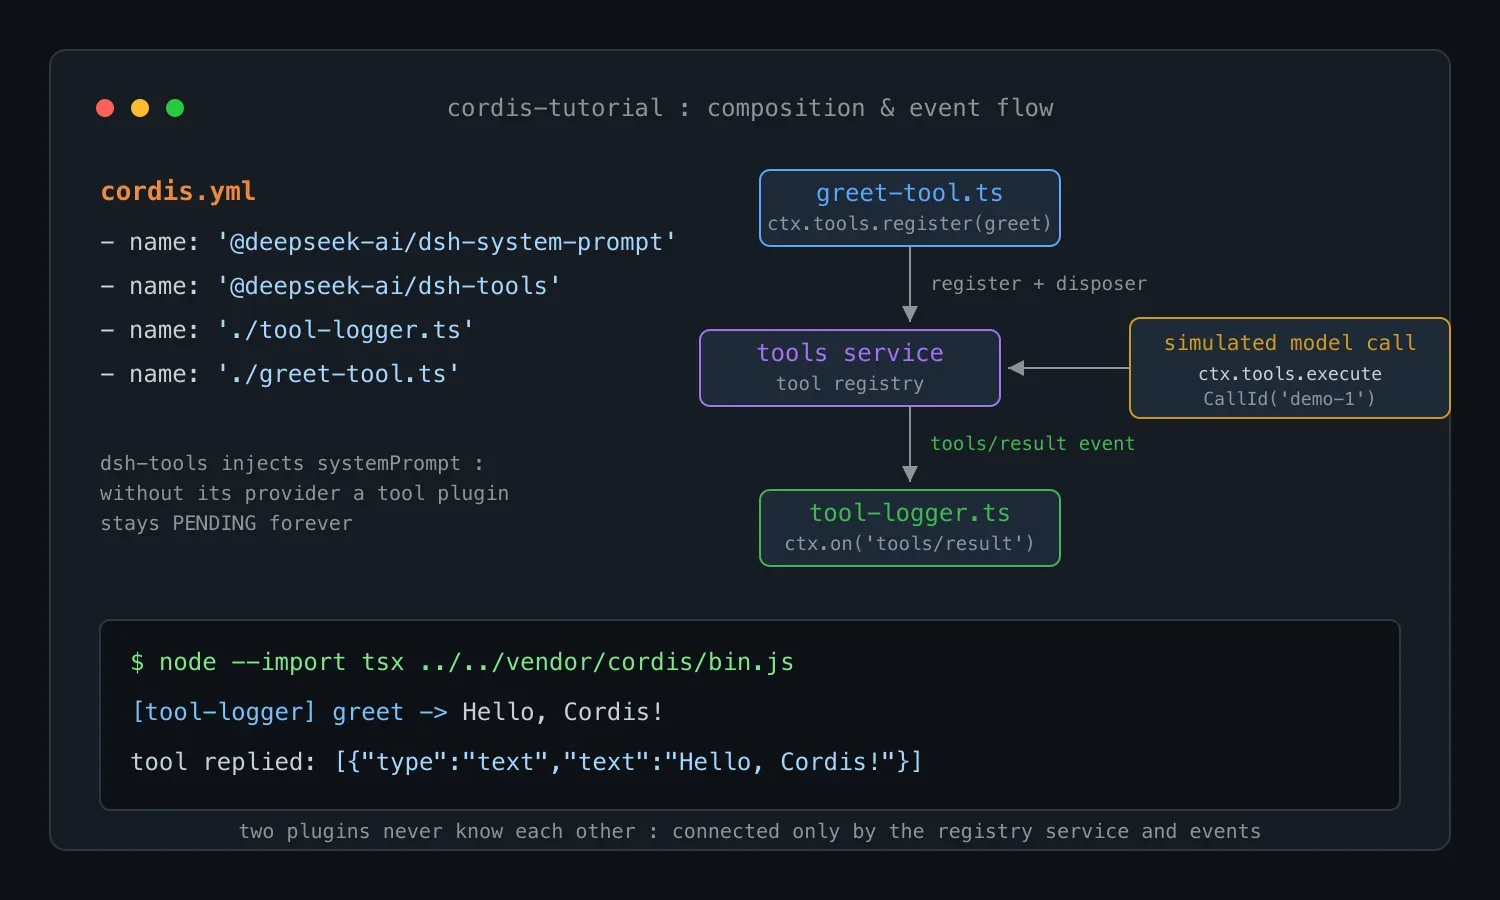
工具本质上是普通插件。插件声明注入 tools 服务,再用 defineTool 把定义注册进去:
import { readFile } from 'node:fs/promises'
import { defineTool } from '@deepseek-ai/dsh-tools'

export const name = 'my-tool'
export const inject = ['tools']

export function apply(ctx: Context) {
  ctx.tools.register(defineTool({
    name: 'read_file',
    description: 'Read a file from disk.',
    parameters: {
      path: { type: 'string', required: true },
      limit: { type: 'number' },
    },
    output: {
      schema: { type: 'string' },
      render: (_args, value) => [{ type: 'text', text: value }],
    },
    async execute(args, exec) {
      return readFile(args.path, { encoding: 'utf8', signal: exec.signal })
    },
  }))
}
几处细节值得划线:description 是模型唯一能读到的说明书,写清楚比写漂亮重要;parameters 里不加 required 就默认可选;execute 拿到的 args 会按 schema 推导出静态类型。注册基于副作用模型,插件被销毁时工具随之注销,不需要手工清理。所有 schema 会自动汇入系统提示词的组装,同样不用手工拼接。
执行函数的八条契约
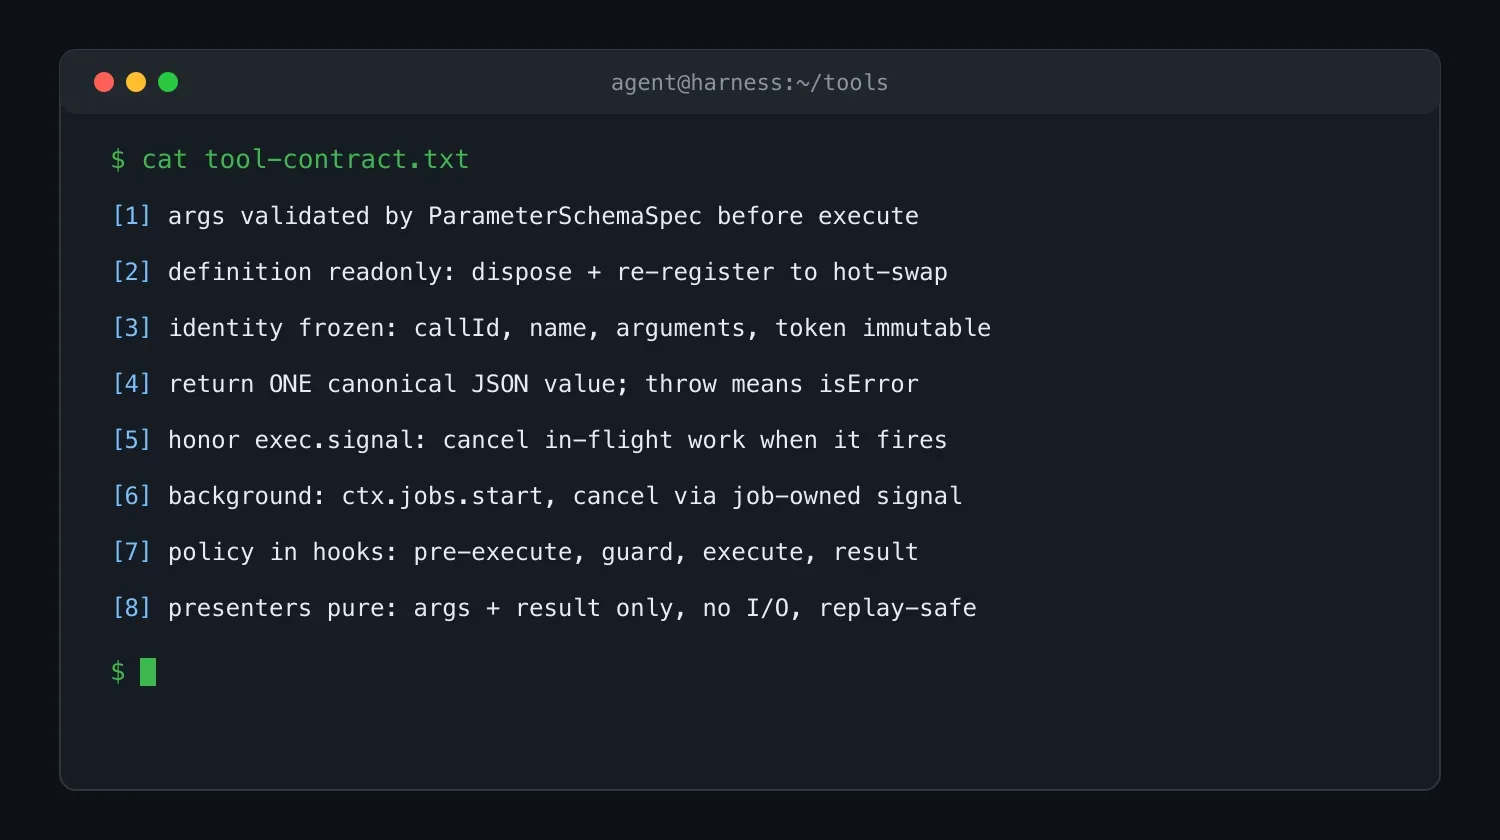
参考文档给 execute 立了八条规则,逐条都值得当真。
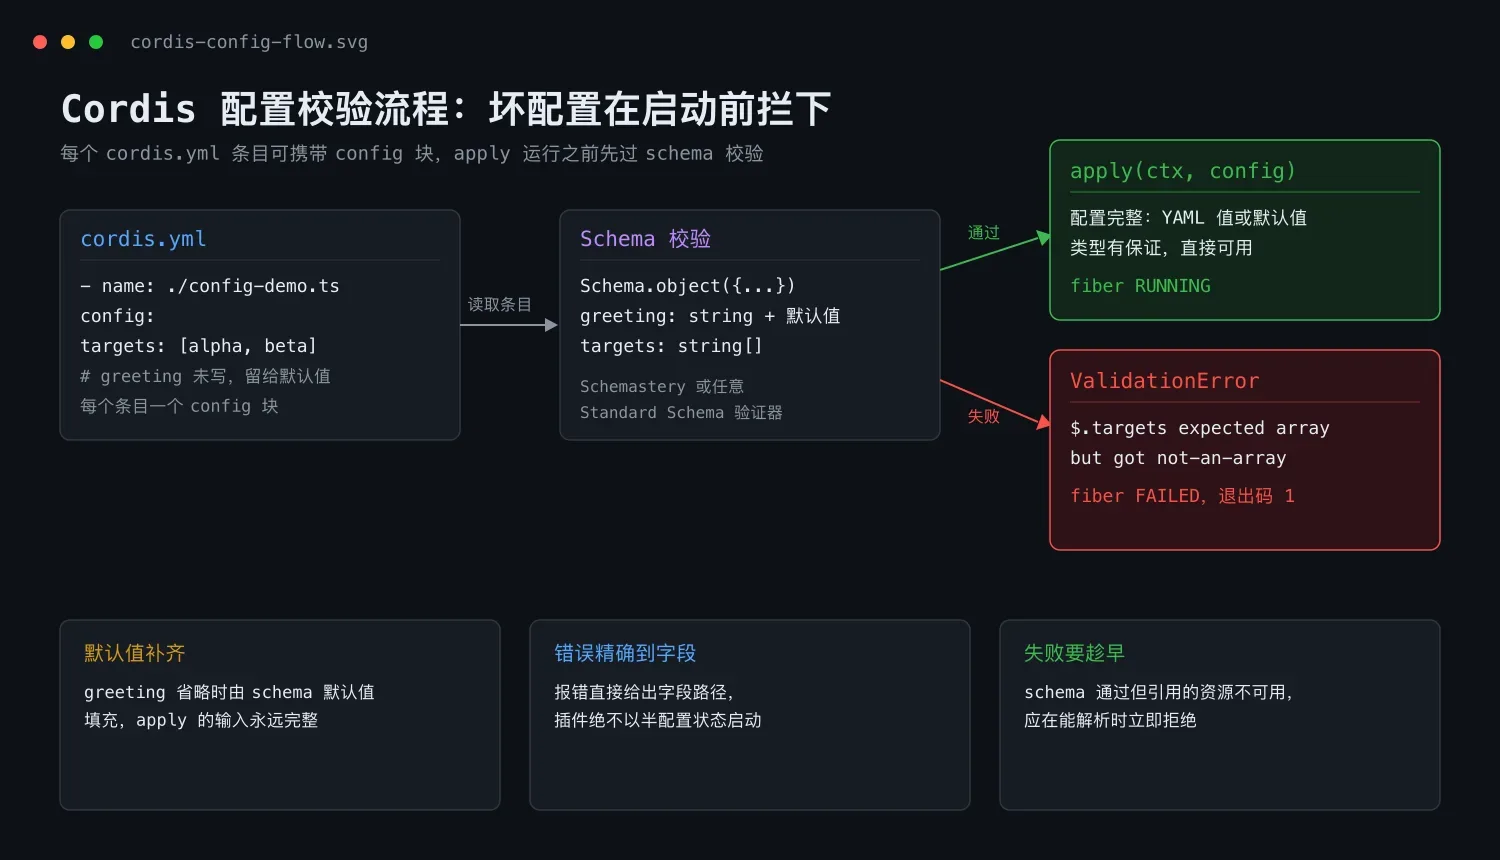
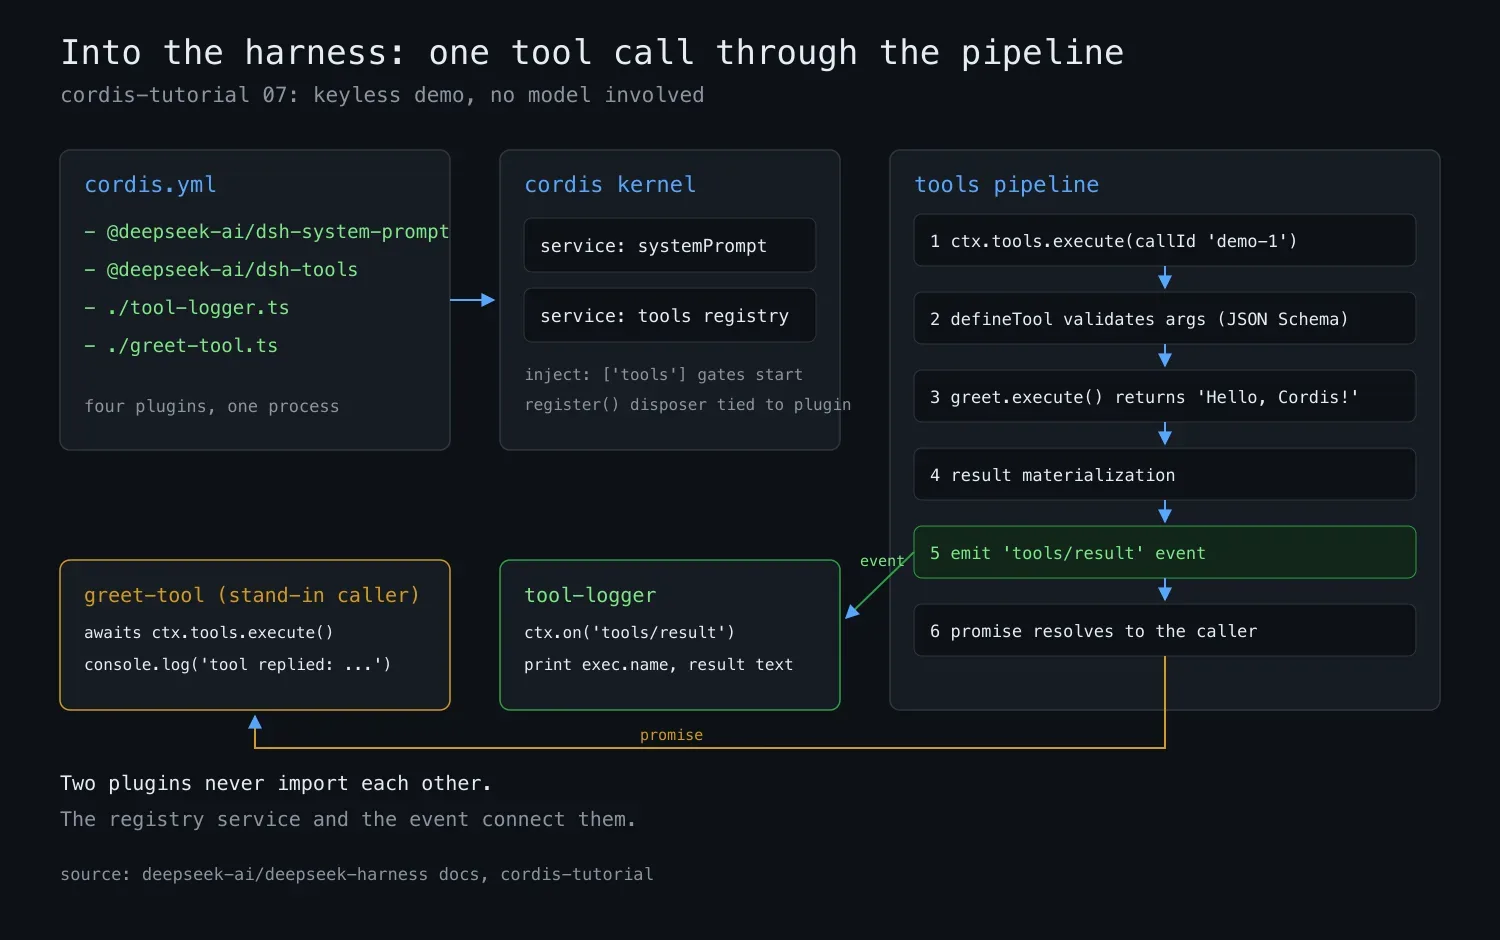
第一,参数已经替你校验。defineTool 会在 execute 运行前,用统一的参数 schema 校验模型生成的 arguments,类型、必填键、字面量约束、联合类型和嵌套值都覆盖在内。但 DSL 表达不了的约束,比如非空字符串、正数、跨字段规则,仍然要自己检查;绕过封装直接注册的原始 JSON Schema 工具,输入校验完全自理。
第二,注册借用的是只读定义。同进程的类型化注册不是序列化边界,注册之后不要改 schema,也不要替换回调;想热替换工具,正确做法是销毁原副作用再注册新工具,回调闭包里的可变状态仍是普通插件状态。
第三,执行身份受保护。调用 id、工具名、参数、令牌在分发全程保持不可变,参数按只读输入对待;只有 around 包装器能拿到可变视图,它可以替换并恢复 exec.signal 来施加截止时间,但无法移除信号本身。
第四,声明并返回唯一的规范 JSON 值。输出 schema 的根可以是对象、数组、标量或 null,注册表负责快照、校验、冻结,再交给渲染函数。不要从函数体里直接返回内容块,更不要逼调用方从自然语言里抠 id 和字段。
第五,抛异常或返回非法值,结果就是 isError。注册表会兜住 schema、渲染、元数据投影各类失败,再交给观察者。基础设施故障才抛异常;业务上不理想但成功的结果,比如进程非零退出,应该写进规范值,由渲染层解释状态。
第六,遵守 exec.signal,信号触发时取消进行中的工作。
第七,需要结果期事实的卡片数据,用可选的 presentationMeta 从同一个规范值派生可回放的 JSON,核心会把它持久化在结果事件上并转交给结果卡片,回放时无需保留原始值。
第八,异步通知走 exec.agent 注入。追加的上下文下一次模型请求可见,但它不是唤醒,空闲的 agent 不会被吵醒;注入时要防备目标已销毁的情况。
长任务:后台作业有自己的生命周期
可能跑很久的工作,用 producer 配置放行 run_in_background,再通过 ctx.jobs.start 注册任务,运行时会先校验所有者和任务控制器可用,再提供任务 id、会话围栏、通用控制工具和清理钩子。注册成功后返回类型化句柄,例如 { kind: 'background', jobId },面向人的文案可以保留「已启动后台任务」这类描述,但程序化调用绝不能靠解析这段文字拿 id。
一个关键细节:任务发布之后,取消要改用任务自有的信号,而不是 exec.signal。外层调用取消只代表不再等待这次调用,不会终止已经发布的工作;后者的生命周期归任务终止工具、所有者销毁和服务卸载所有。前台工作仍然与 exec.signal 耦合。
策略与观测:别把部署策略焊死在工具里
权限和沙箱尽量做成策略,而不是写进工具本体。框架提供了一排扩展点:pre-execute 做可扩展的允许、拒绝、询问策略,扩展手册里有权限门禁的现成示例;guard 设置最终的单调拒绝,后续监听器无法撤销;execute 包装器可以给分发加截止时间、重试或指标采集;post-execute 能替换展示内容或返回值、拦截结果、附加模型可见上下文;result 只读观测归一化后的不可变结果。注意内容替换不会影响程序侧取值,保密策略则直接屏蔽或替换值本身。
Code Mode:程序化调用是白送的
在 Code Mode 里,每个可见的已注册工具都能以 await tools.工具名(参数) 的方式直接调用,无需额外集成。参数与返回类型由同一组 schema 派生,调用重新进入正常执行流水线:成功解析为策略处理后的最终规范值,失败则以真实的 ToolCallError 拒绝,程序只能看到名称和可读消息,拿不到内部错误码。因此输出 schema 要按程序化接口来设计,直接返回句柄和字段,面向人类的解释全部留给渲染层。中间值只在执行期存在,不持久化也不设字节上限,工具自己仍要如实声明采集边界。
UI 卡片:展示是独立的关注点
工具的呈现分两层。output.render 面向模型;界面卡片由 presentCall 与 presentResult 两个纯展示方法声明,返回带 card 标签的渲染意图,generic、terminal、diff、search、web 五种,各端运行时自行映射成自己的视图。没有声明展示方法的工具会回退到通用卡片。比如文件写入用 diff 卡片,shell 命令用 terminal 卡片,检索类工具用 search 卡片并携带截断标记,界面永远不会把被截断的结果当成完整结果展示。
硬规则有三条。其一,两个展示方法在实时流和会话回放时都会运行,必须是参数与结果的纯函数:不做 IO、不读会话状态、不碰时钟和随机数,diff 一律从参数派生,会话上下文由界面适配器提供。其二,UI 专用格式,比如终端代码块或相对化路径,不允许为了界面好看混进模型结果,模型看到的自然语言归渲染层,可回放的界面状态归投影器。其三,defineTool 对展示路径做软校验,日志里的参数损坏时返回通用回退而不是抛异常,展示永远不能弄崩回放。
写完之后
文档最后强调验证:面向模型或界面的改动,要按仓库测试策略补齐组装覆盖。仓库里的 tool-bash 是生产级三包参考实现,generic 与 diff 卡片看文件工具,终端卡片看 shell 工具,照着参考实现抄结构最省事。工具是模型与世界之间的合同,合同写得越清楚,agent 干活越可靠。