
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
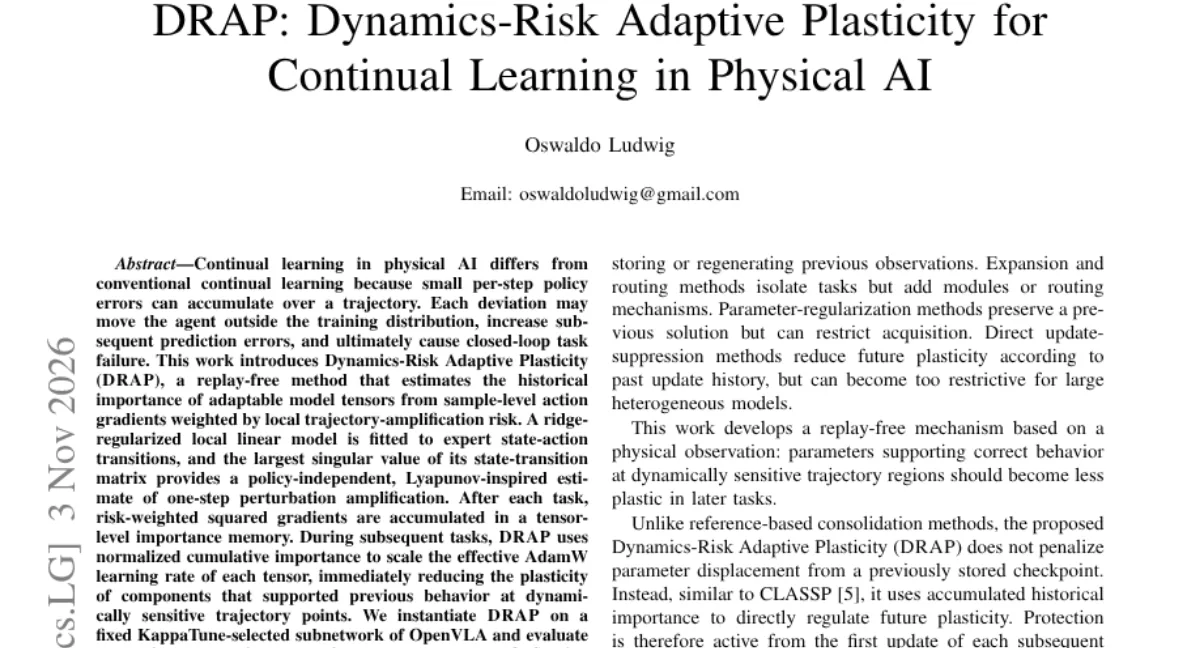
物理 AI 的持续学习怎么防遗忘,DRAP 免回放作答
API中转
¥120
机器人策略的持续学习有个独特难点:微小的单步误差会在闭环轨迹里累积,动作错了状态就偏,状态偏了策略就离开训练分布,任务直接失败。常见的两条路各有短板:replay 要存历史数据,正则化方法像 EWC 又限制新任务学习。DRAP(arXiv 2611.05029)给出了一条免回放的中间道路。
三个组件环环相扣。KappaTune 用矩阵条件数作为预训练信息的代理,固定选出低条件数张量作为可训练集合,其余冻结;局部动力学风险估计对专家状态动作转移做滑窗回归,取转移矩阵的最大奇异值当作一步扰动放大风险,中位数归一化后作为样本权重(作者明说这是敏感性指标,不是稳定性证书);最后把这些风险加权的重要性直接换算成张量级的 AdamW 学习率乘子,抑制的是优化器步长本身,保护从下一任务的第一次更新就生效,且不需要存参考参数副本。
实验按论文口径:单个 OpenVLA 7B 检查点按 LIBERO Spatial、Object、Goal 顺序训练,标准顺序微调呈强烈的「学新忘旧」,早期套件性能趋近零;KappaTune 加 EWC 只能保护首个转换;KappaTune 加 DRAP 拿到最强的稳定性与可塑性平衡,平均成功率最高、平均遗忘最低。消融显示重要性驱动的可塑性控制贡献了大部分收益,动力学风险加权则额外改善了最早套件的保留。
要标注的状态:页面未列作者机构(代码仓库指向同一作者的系列工作),具体成功率表格未在摘要页呈现,细节以论文原文为准。对做具身持续学习的团队,「免回放」这三个字本身就值得点进去看。
相关文章

分享: