
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
agent 能力比听音频更重要:SleuthVLM 只靠转录夺魁
API中转
¥120
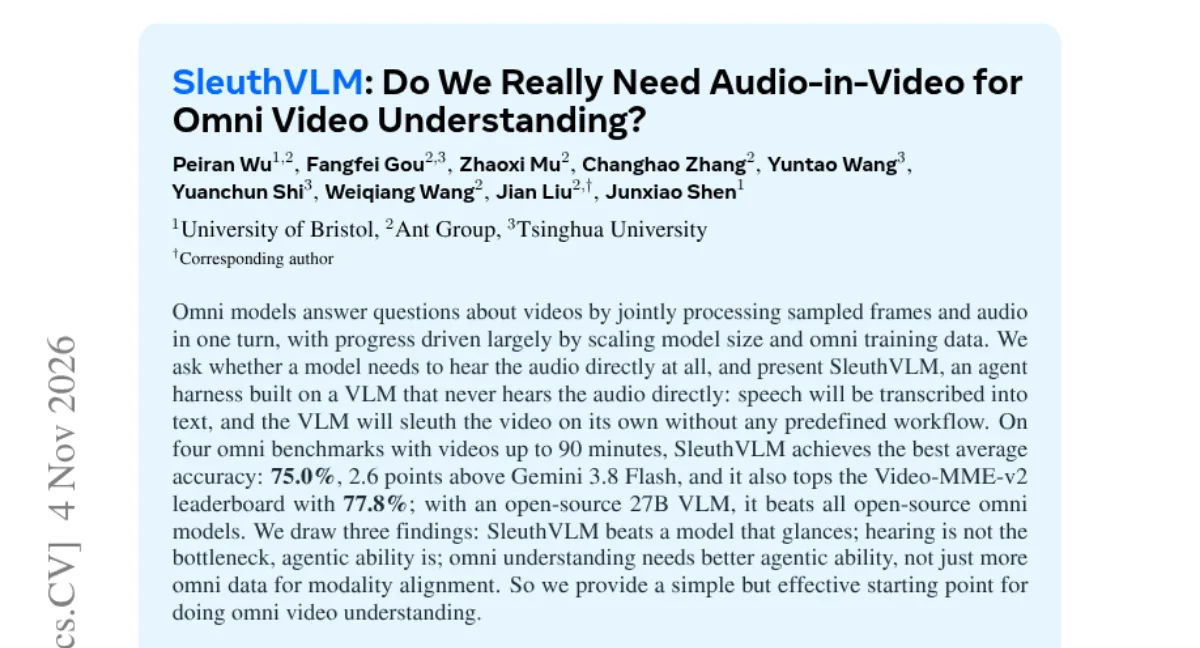
全模态视频理解模型都在拼命塞音频输入,但音频真是必需的吗?布里斯托大学、蚂蚁集团与清华大学合作的 SleuthVLM(arXiv 2611.06083)做了一个反直觉的设计:模型从不直接接收音频,而是用 ASR 加强制对齐器一次性生成词级时间戳转录,转录文本充当时间索引,非语音区间保留为空档。剩下的交给一个沙箱化 agent:模型自己决定看哪里、看多细、何时停。
成绩按论文口径:Opus 5.5 版在四个全模态基准上平均 75%,高于 Gemini 3.8 Flash 2.6 个点;开源路线更亮眼,Qwen3.8-27B 单卡部署拿到平均 66.8%,超最强开源全模态模型 13.8 个点,也超过 Qwen3-Omni-30B-A3B 16.8 个点。消融数据说明了转录的价值:拿掉转录文本准确率掉约 17 个点,词级时间戳再贡献 1.3 个点;音乐类问题则由可选的音频描述工具补位,在 448 个音乐问题上提升 9.8 个点。
三大发现的中间那条最锋利:agent 能力比直接听音频更重要。案例里 Gemini 3.8 Flash 用了 27 轮、约 21 倍 token 仍答错,而 Opus 5.5 五轮答对;同一全模态模型改成主动搜索后最多提升 10.3 个点。论文对 6,383 道题、71,132 次工具调用的轨迹审计确认无答案泄漏。
这对做视频理解的团队是个方向性的提示:与其堆多模态对齐训练数据,不如先给模型配一个会自己翻时间戳、会主动拉帧的 agent 框架。75.2% 的视频问题涉及语音,而语音几乎都能转化成带时间戳的文本,这条「转录当索引」的捷径,成本比端到端音频低得多。
相关文章

分享: