
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
GaussianRenderFormer 证明 Transformer 能学会渲染高斯
API中转
¥120
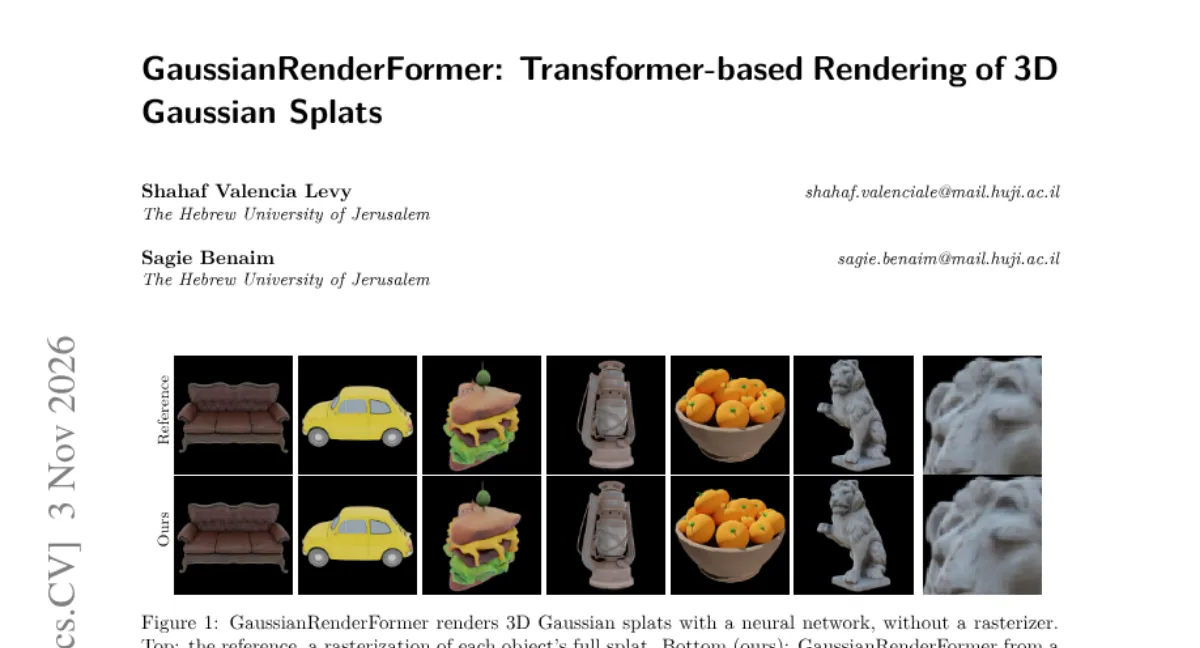
3D 高斯泼溅(3DGS)的渲染从来都靠手写光栅化器:投影、深度排序、alpha 混合,一步不能少。希伯来大学耶路撒冷分校的两位研究者问了一个有点异端的问题:能不能让神经网络自己学会渲染高斯?他们的 GaussianRenderFormer(arXiv 2611.05593)是据作者所知首个无光栅化器的高斯前馈神经渲染器。
架构是双阶段的:视角无关编码器把每个高斯(中心、尺度、四元数、颜色、不透明度共 14 个参数)编码成一个 token,12 层自注意力配 3D 旋转位置编码;视角相关解码器拿图像小块的相机光线当查询 token,交叉注意力到场景 token,经 DPT 头输出像素。针对高斯的三项改动是性能关键:投影中心位置的 2D 旋转位置编码、把高斯的投影足迹显式告知解码器的注意力键、patch 从 8×8 缩到 4×4 像素。消融数据印证了每一项的分量:去掉 2D 编码损失 5.2 dB,用 8×8 patch 损失 3.0 dB。
要冷静看待的是绝对水平:300 个未见物体上拿到 38.08 dB PSNR(对照未剪枝 splat 的光栅化渲染为 44.02 dB),且训练集物体上也只高 0.17 dB,说明这是能力差距而非泛化差距;单视图 275 毫秒(L40S)对光栅化的不足 1 毫秒,195M 参数的模型目前无法渲染视角相关效果。
那这篇的意义在哪?它证明了「渲染」这个被认为必须手写物理管线的任务,可以被序列建模完全学到。就像当年的神经辐射场一样,先有能跑的,再有能用的。做神经渲染的研究者值得读它的消融表,工程应用暂时还请留在光栅化器。
相关文章

分享: