字节笔记本
2026年10月7日 · 约 2 分钟读完
改了八版的设计稿 agent 还记不住:新基准专治状态失忆
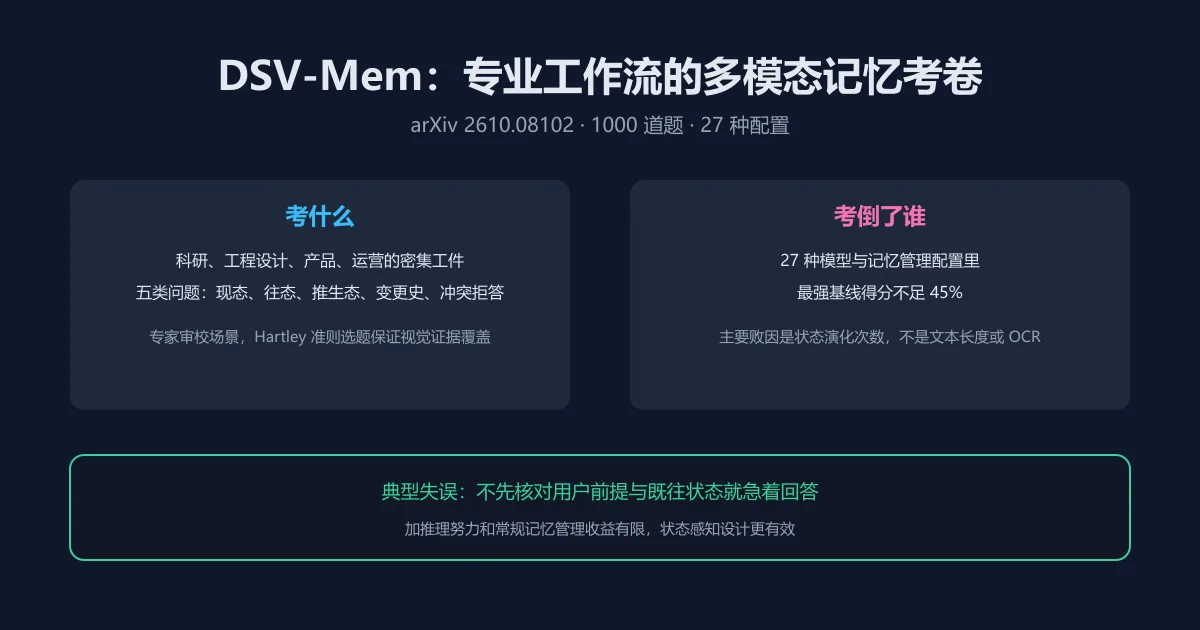
多模态 agent 的演示总是很顺滑:读一张图、答一句话。真实专业工作流的形态完全不同:一份设计稿改到第八版、一份实验记录被三个协作者轮番修订,agent 要回答的问题往往是现在到底什么状态、哪一版说了什么、两处记录为什么矛盾。10 月 6 日放榜的 DSV-Mem(arXiv 2610.08102,作者 Jike Zhong 等)就为这类场景造了一份考卷:密集有状态视觉记忆的专业基准。
考卷怎么出
基准覆盖 AI 科研、工程设计、产品管理、商业运营四类专业工作流,工件信息密集、频繁修订,题目分五类:现态查询、往态查询、推生态查询、变更史、冲突与拒答,共 1000 道,全部经专家审校。五类的分工有讲究:现态考此刻以哪个版本为准,往态考历史可回溯,推生态考跨版本推理,变更史考完整审计,冲突与拒答考的是用户前提可能已被历史版本推翻时,正确的回答不是顺从而是指出矛盾。选题用 Hartley 准则筛过,保证每题都需要广泛的视觉证据检视;生成管线把状态迁移的合成与对话填充分开,评测套件可以复现地重建,这个拆分也让新增场景不用重写整套出题逻辑。
考倒了谁
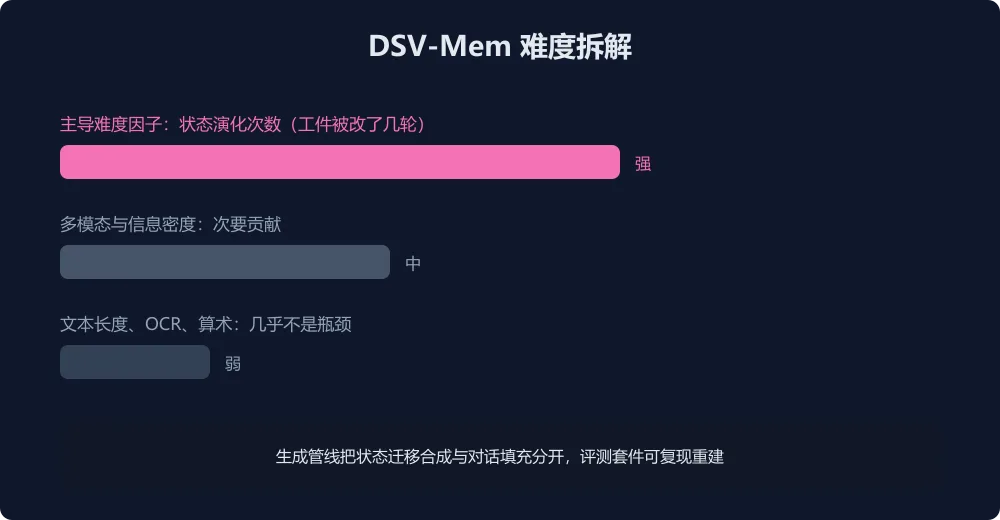
27 种前沿与开源模型加记忆管理方法的配置里,最强基线得分不足 45%。难度拆解是全文最有价值的发现:主导因子是状态演化次数,也就是工件被改了几轮,而不是常见猜测的大海捞针文本长度、OCR 或算术;多模态与信息密度只是次要贡献。典型失误模式被点名:模型经常不先核对用户前提与既往状态更新就急着回答,用户问的是一个已过时的状态,模型顺着错误前提一本正经地作答。更扎心的是,堆推理努力和常规记忆管理方法都只有有限收益,状态感知的设计才有明显效果。
给工程团队的镜子
这份基准直接照出了多模态记忆系统的两个设计误区:一是把力气花在检索更长上下文或更准 OCR 上,而真正的瓶颈是版本状态的追踪;二是记忆管理只在存取侧做文章,缺少对前提一致性的显式校验。做协作工具、设计平台、实验管理系统的团队可以把冲突与拒答这类目当验收标准:agent 敢于说这份需求文档第三版已经改掉了你说的字段,才算真正记住了工作流。论文 CC BY 4.0,基准与代码官方声明将公开发布,落地页暂未给出,需要持续跟踪。