字节笔记本
2026年10月7日 · 约 3 分钟读完
存整段还是记要点?agent 经验管理有了基准答案
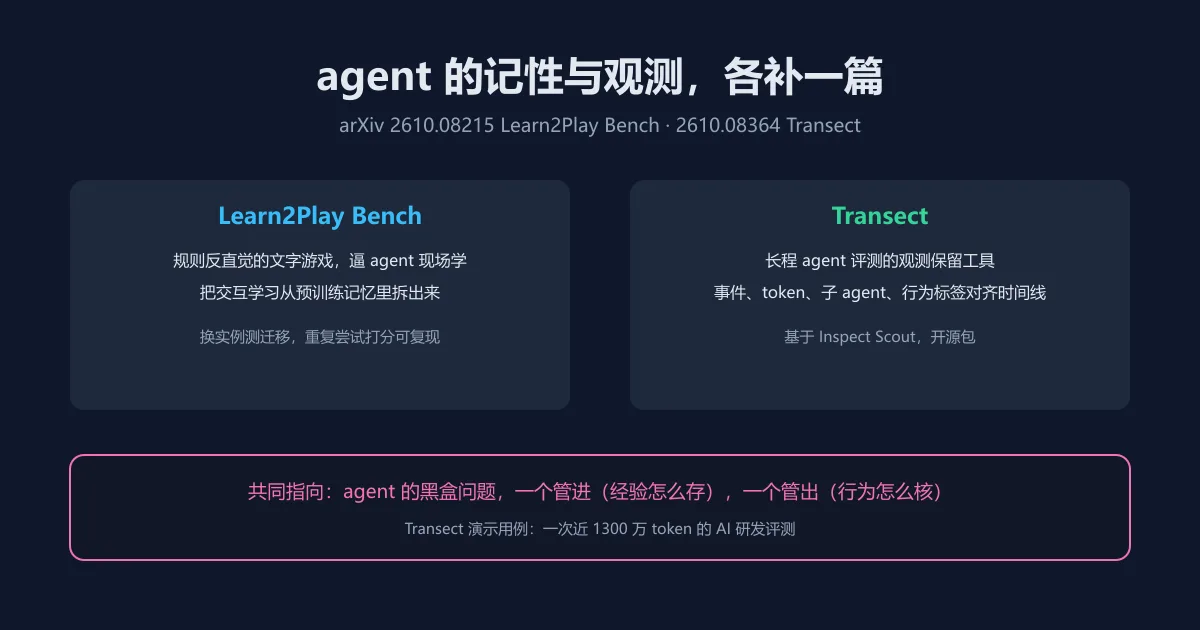
agent 圈对经验记忆的主流想象是蒸馏:把交互历史提炼成规则和策略,省 token 又显得聪明。10 月 6 日放榜的 Learn2Play Bench(arXiv 2610.08215,作者 Yibo Li、Bryan Hooi 等)用一套设计干净的基准对这个想象做了检验,答案出人意料;同日的 Transect(2610.08364)则从另一头补上了 agent 长跑评测的观测工具。两篇论文一个管经验的进,一个管行为的出,凑成 agent 黑盒问题的两条新证据。
Learn2Play:先把学习拆出来
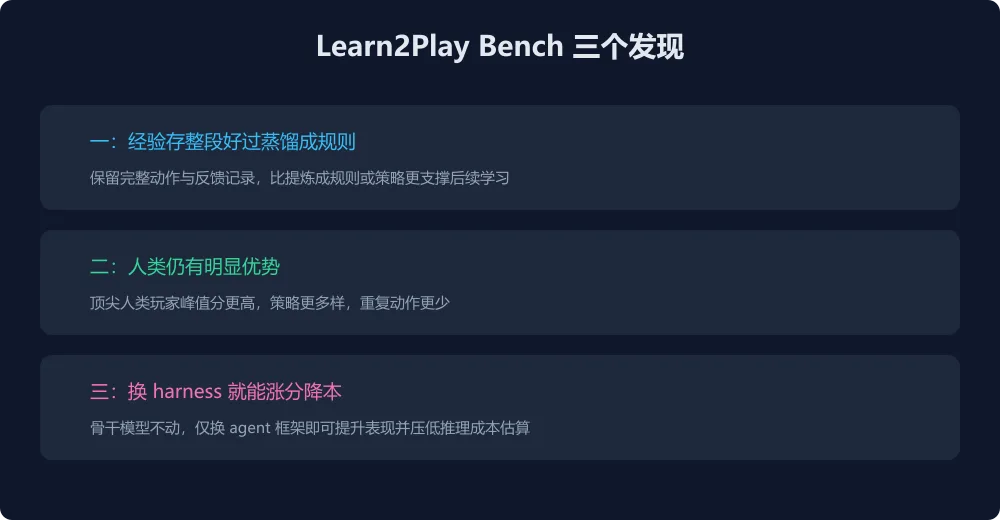
现有基准的通病是任务规则写在说明里、或早就出现在预训练语料中,agent 答得好分不清是真会现场学习,还是背过答案。Learn2Play Bench 的解法是设计规则全新或反直觉的文字游戏:agent 必须通过交互试错才能摸清机制,反馈可复现、打分全自动,换个游戏实例还能测迁移。在骨干模型、自进化方法、agent 框架三个维度上做控制变量后,三个发现值得记住:其一,完整保留动作与反馈记录(存整段)比蒸馏成规则或策略(记要点)更支撑后续学习,主流的蒸馏直觉在这套设置下不占优;其二,顶尖人类玩家的峰值分数仍高于受测 agent,策略更多样、重复动作更少,人机差距真实存在;其三,骨干模型不动、仅更换 agent 框架就能提升表现并压低推理成本估算,harness 的选择是被低估的杠杆。
Transect:把长跑摊开看
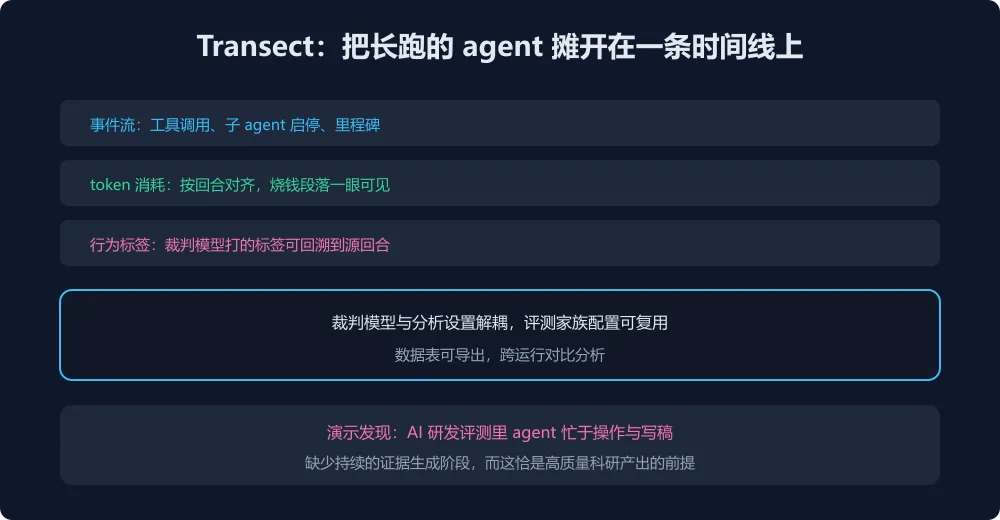
另一篇针对的是评测侧的失明。前沿评测越来越用开放式 agent 任务,一次运行产生数百页 transcript、近千万 token 的记录,评估者实际上看不过来;引入 LLM 辅助归类行为又引入新的自由度,可复现性和可审计性受威胁。Transect 是基于 Inspect Scout 的开源包:评测家族配置里定义任务上下文和行为词汇表,裁判模型与分析设置解耦;报告把事件流、token 消耗、子 agent 活动和行为标签对齐到同一回合制时间线,任何标签都能回溯到源回合,底层数据表可导出做跨运行对比。演示用例是一次近 1300 万 token 的 AI 研发评测:组合视图显示 agent 忙于操作型工作和论文生产,缺少持续的证据生成阶段,而作者认为那恰是高质量科研产出的前提。这类发现没有观测工具根本看不见。
两篇合起来读
对做 agent 平台的团队,两条可执行结论:记忆策略先别急着上蒸馏管线,完整轨迹加检索的笨办法值得先做基线,Learn2Play 的结果说明它可能更强;评测基础设施里时间线对齐和标签回溯不是锦上添花,是发现系统性缺陷的前提,Transect 的思路可以用 Inspect 生态直接落地。两篇论文均为 CC BY 4.0,Learn2Play 有项目网站,Transect 自述以开源包形式发布,仓库链接以论文页后续更新为准。