字节笔记本
2026年10月7日 · 约 2 分钟读完
给 agent 上护栏反而更笨?POLAR 的正反两面
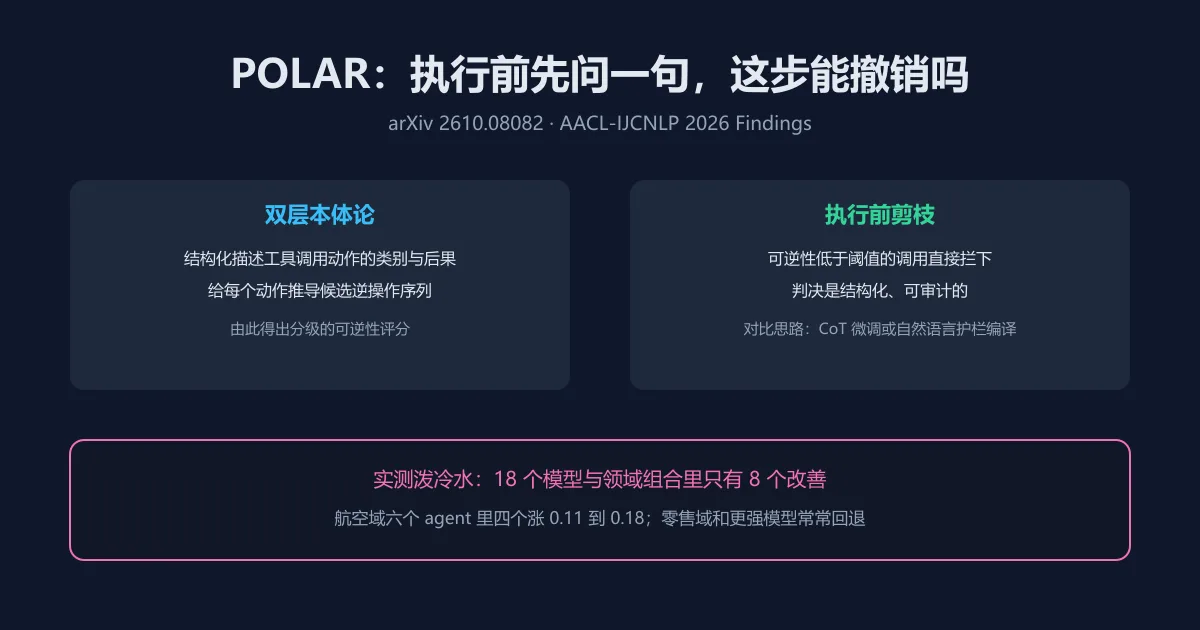
给工具调用的 agent 加护栏,直觉上只会更安全不会更糟:拦下误删的文件、拦下发错的支付,听起来稳赚不赔。AACL-IJCNLP 2026 Findings 论文 POLAR(arXiv 2610.08082,作者 Yunju Kang 等)用一套设计干净的护栏框架测了这个问题,结果比结论更有价值:护栏不是免费午餐,装错地方会实实在在拖慢 agent。
框架本身值得看
POLAR 的思路是执行前预防而不是事后补救。核心是双层本体论:用结构化方式描述工具调用动作的类别与后果,再为每个动作推导候选的逆操作序列,由此得出一个分级的可逆性评分。删除文件、发起支付这类难以逆转的动作分数低,查询类动作分数高;低于阈值的调用在执行前就被剪枝。与常见的思维链微调或自然语言护栏编译相比,它的判决是结构化、可审计的:为什么拦这一步,本体论里能翻到依据,出问题能回溯。对合规要求高的场景,这个性质比拦截率本身更稀缺。
实测是一盆冷水
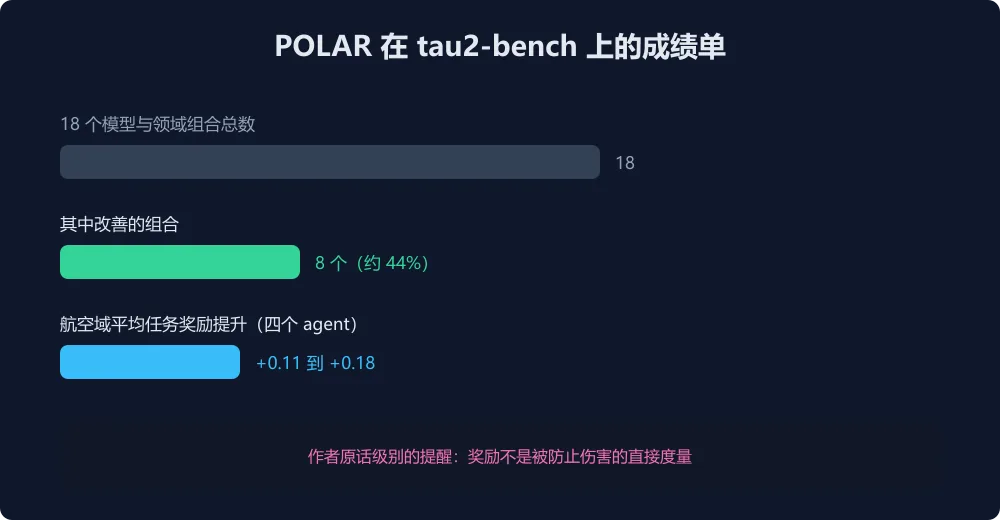
评测在 tau2-bench 上跑六个 agent 模型,成绩单必须完整看:18 个模型与领域组合里只有 8 个改善。航空域六个 agent 中四个拿到 0.11 到 0.18 的平均任务奖励提升,这是框架的高光区间;但零售域整体回退,能力更强的模型也常被拖慢。一个说得通的解读是:强模型本来就更少做危险动作,护栏拦下的更多是它们的合理操作,收益自然被误伤吃掉。作者的提醒也写得很坦率:奖励分数不是被防止伤害的直接度量,一个被拦下的危险动作在奖励表上可能只是少了一笔完成任务的收入。换句话说,护栏的价值要用安全事件来算,而基准考的是任务完成度,两把尺子量不出同一个东西。
负结果的三条启发
这份工作的可取之处恰恰是没把混杂结果藏起来。对工程团队有三条直接启发:其一,可审计性是护栏的第一属性,结构化判决比黑箱拦截更经得起审计与回归;其二,护栏收益强依赖领域,上线前必须分域灰度,拿单域结果外推会翻车;其三,评估口径要分开设计,任务奖励与风险防止是两套指标,混在一个分数里既看不出安全也没看出效率。论文未附代码仓库,复现要自己动手,适合当方法论参考而非现成轮子。