字节笔记本
2026年10月7日 · 约 3 分钟读完
一道题讲三遍还不懂:Sherpa 教会 AI 老师换讲法
让 AI 当老师,最容易被忽略的失败模式不是讲错,而是讲不懂:同一道题换个讲法学生就通了,模型却只会用一种腔调重复。10 月 6 日放榜的 Sherpa(arXiv 2610.08778,作者 Weixian Xu、Diyi Yang 等,代码开源于 SALT-NLP/Sherpa)把这个问题拆开看:现有 LLM 教师的教学法来自示范数据、偏好排序或人工设定的教学规则,没有一条接地气到学生的真实学习结果,于是他们换了个训练目标,直接拿学生学会没有来优化老师。
拿模拟学生当陪练
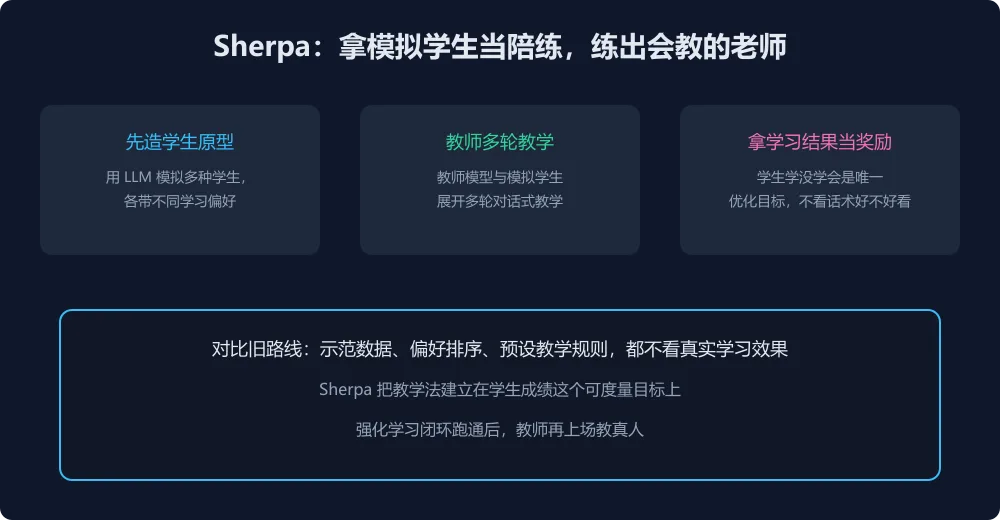
真实学生不可能大规模参与训练循环,Sherpa 的解法是让 LLM 扮演学生:先构造多个学生原型,每个原型设定不同的学习偏好,有的要例子先行,有的要先看公式推导,有的依赖反问式引导。教师模型与这些模拟学生展开多轮对话式教学,学生原型答得好坏直接构成奖励信号,教师据此做强化学习。这个设计的妙处在于把教学法从玄学变成可优化目标:话术好不好看不重要,学生做对了题才算数。对比之下,旧的训练路线要么靠老师示 范(好老师的话术学个皮毛),要么靠偏好排序(人类觉得哪种回复更像好老师),要么靠人工规则(先共情再提问之类的教条),全都绕开了学习效果这个硬指标。
三组数字
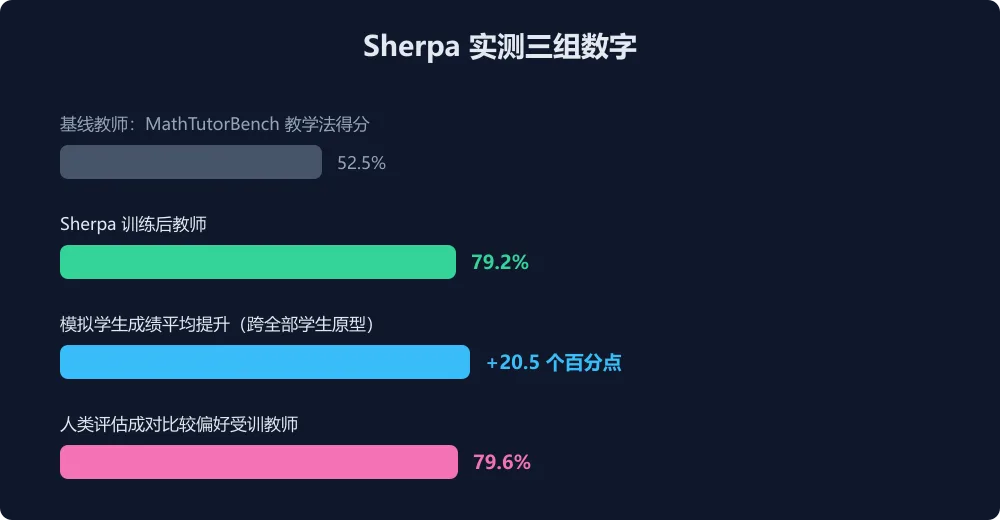
结果分三层验证。第一层,全部学生原型的成绩平均提升 20.5 个百分点,说明不是只对某种偏好有效。第二层,MathTutorBench 基准上的教学法得分从 52.5% 提到 79.2%,这个基准专门考教学行为质量,涨幅说明方法论层面的真实改进。第三层最硬:真人评估者做成对比较,79.6% 的场景里更偏好受训后的教师,模拟学生练出来的本事迁移到了真人身上。论文连同附录 32 页,训练与评测代码全部开源。
对做教育产品和内部培训系统的团队,这套方法的可迁移点有两个:其一,用模拟用户代替真人陪练的思路适用于一切需要多轮交互优化的场景,客服、销售陪练、面试教练都可以套;其二,把优化目标锚定在可度量的结果上而不是回复质量上,这是所有 tutor 类 agent 都该抄的验收标准。真上生产前仍要过真人验证这一关,模拟学生的分布偏窄时教师可能过拟合,论文的 79.6% 偏好数据就是这个关口的参考答案。