
字
字节笔记本
2026年11月5日 · 约 1 分钟读完
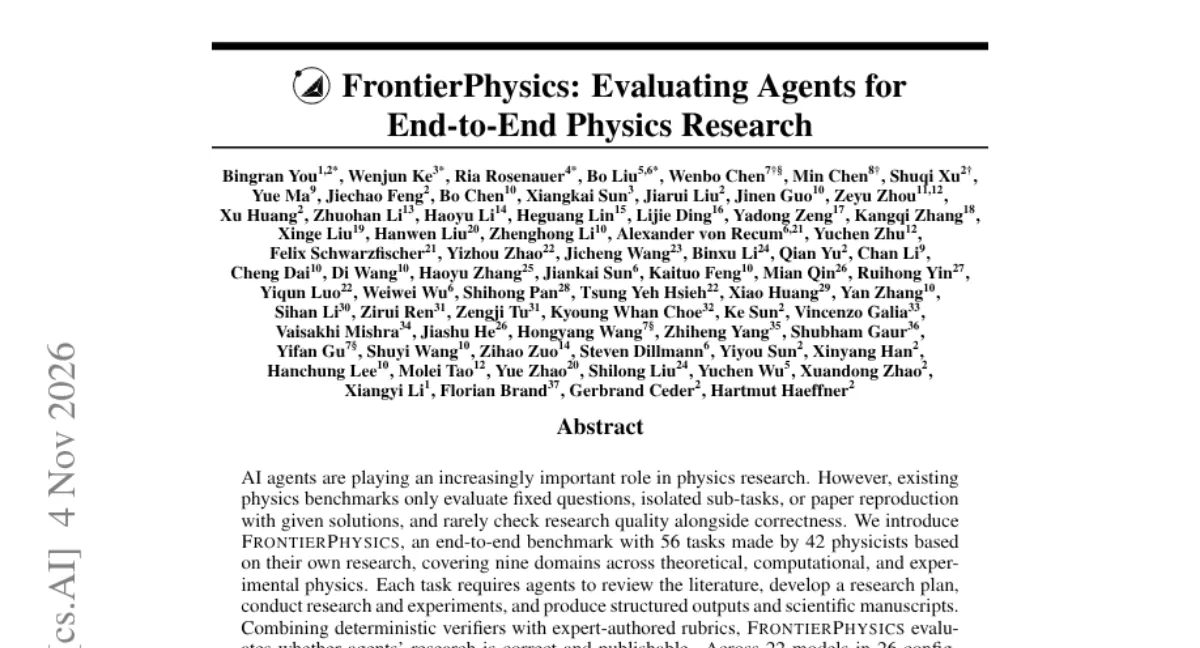
42 位物理学家出卷,前沿 agent 168 次投递无人满分
API中转
¥120
AI 能不能独立做物理科研?今天登上 Hugging Face Daily Papers 的 FrontierPhysics 基准给出了目前最系统的回答:还不能。这份由 72 位作者完成的工作(arXiv 2611.06910)把「科研」整条流程拆成了考卷。
试卷本身很有分量:56 个端到端任务,全部由 42 位物理学家基于自己的真实研究设计,覆盖理论、计算与实验三大方向共九个领域。每个任务要求 agent 走完整科研流程:文献综述、制定研究计划、开展研究与实验、产出结构化结果和科学手稿。评分也是双轨制,既有确定性验证器查对错,也有专家撰写的评分细则衡量「可发表性」,后者才是科研的真实门槛。
成绩单相当不留情面:22 个模型、26 种配置上考场,没有一种配置能在自己的 168 次 rollout 里通过超过 46 次。也就是说,即便是最强的前沿配置,通过率也卡在三成以下。
更有价值的是失败原因分析。对 agent 轨迹的人工审查显示,主要短板不是物理知识缺失,也不是工具执行出错,而是「推理不够严谨」和「专家直觉有限」:步骤看着像科研,但缺乏真实研究者那种对哪些假设值得怀疑、哪条路走不通的嗅觉。这个结论把「科研自动化」的难点从知识工程挪到了品味工程,后者恰好是当前训练范式最难白给的部分。
对关注 agent 评测的读者,这份基准还有方法论意义:端到端任务加专家 rubric 的组合,比单点问答更能暴露模型的真实差距。想在物理或类似深水域用 agent 的团队,可以先拿这套任务的公开版本摸摸自己工具链的底。
相关文章

分享: