字节笔记本
2026年11月7日 · 约 4 分钟读完
把分词换成 SIMD:GigaToken 跑出 24.5 GB/s
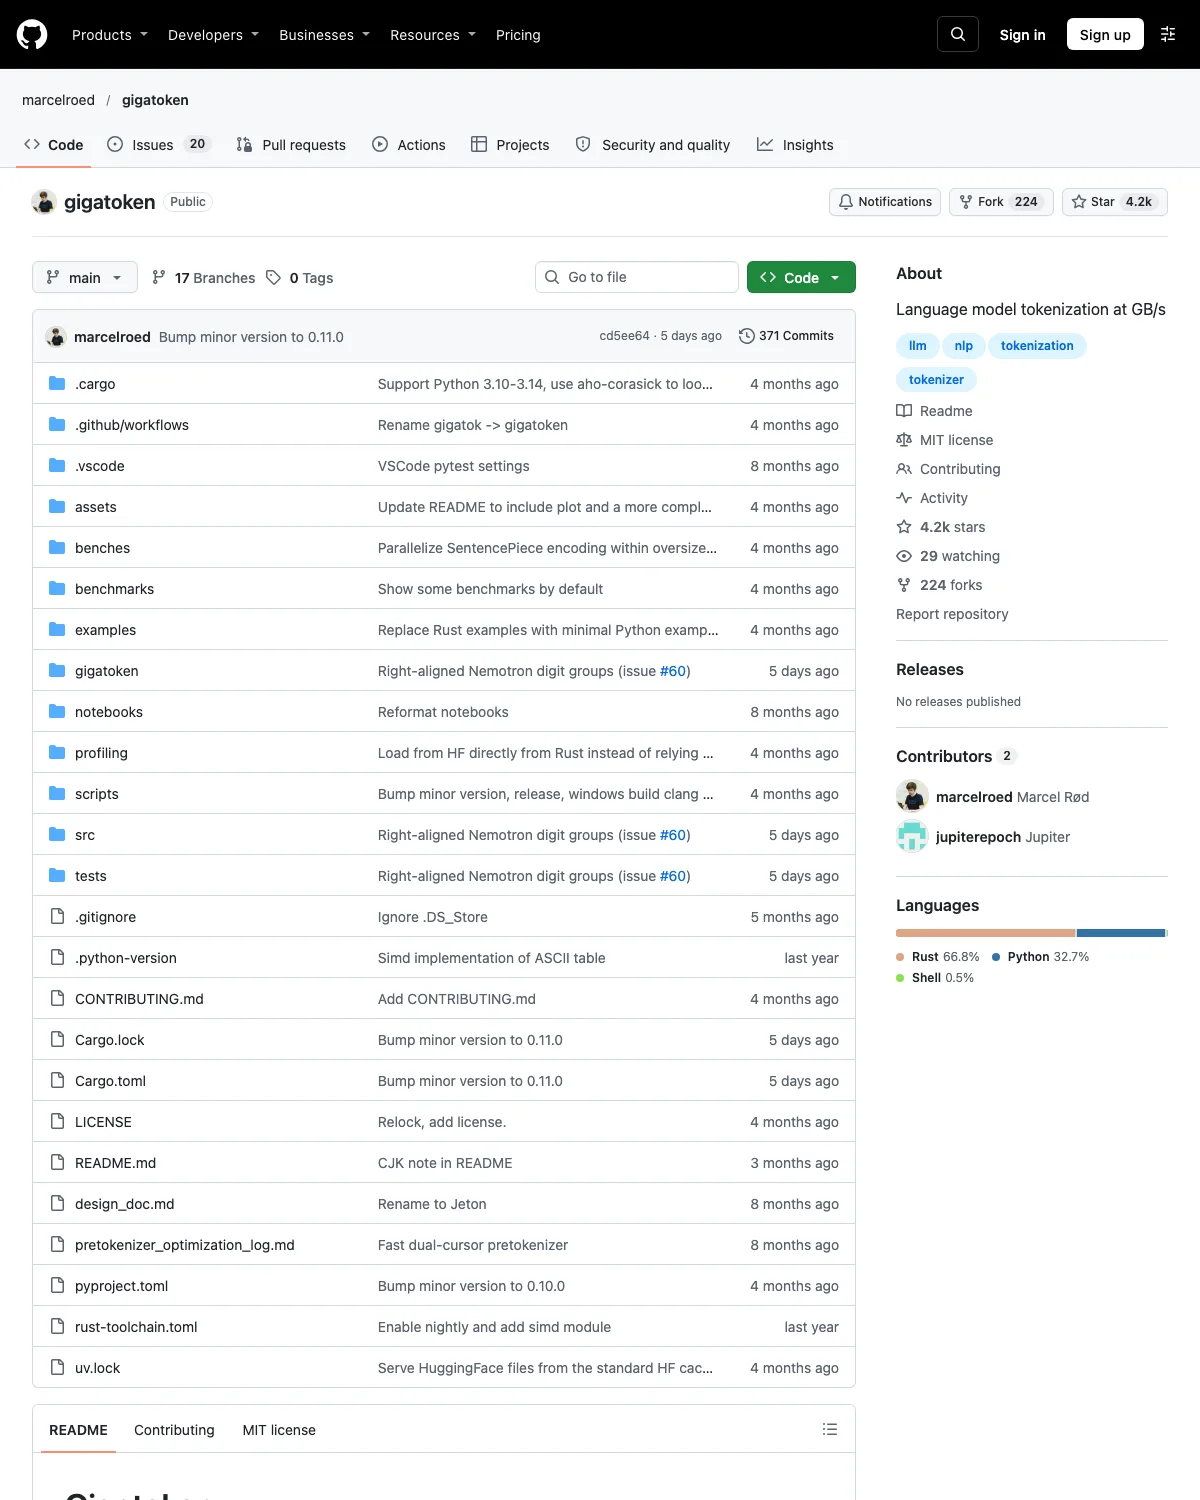
GigaToken(marcelroed/gigatoken,Rust、MIT、Python 绑定;快照 2026-11-07:4,152 星、224 fork,创建于 2025 年 11 月 10 日、最近推送 11 月 2 日——仍在维护;作者 Marcel Røed,斯坦福博士生)把分词这件事里最慢的一环重写了:把预分词的正则换成手写 SIMD 状态机(x86 AVX-512/AVX2、ARM NEON 分开调优)+ 分层缓存(高频 pretoken 查缓存、长尾走慢速存储),多数 token 从缓存纳秒级命中,不再每次跑正则 + BPE 合并。
先把一个常见误读拆掉:这不是"推理快 1000 倍"。分词只是数据预处理/推理链路里的一小步,HN 上的主要质疑就是"分词在推理耗时里不到 0.1%,快 1000 倍的几乎零仍是几乎零"——这个质疑必须写进去。它的真实价值在训练数据预处理:11.9 GB 语料几秒分完、Common Crawl 单机约 7 小时。
速度数字(全部为作者自测口径)
- 双路 AMD EPYC 9565(144 核):GPT-2 分词 24.53 GB/s,对照 Hugging Face 24.8 MB/s(约 989 倍)、tiktoken 36.0 MB/s(约 681 倍);
- Apple M4 Max(16 核):8.79 GB/s,对照 Hugging Face 6.9 MB/s(约 1,268 倍);
- AMD Ryzen 7 9800X3D(16 核):6.27 GB/s,对照 59.0 MB/s(约 106 倍);
- 一致性:11.9 GB OpenWebText 语料上 20,401 篇文档与 Hugging Face 输出逐 token 一致。
倍数随机器变化极大(106 倍到 1,268 倍),所以读这篇的正确方式是看 GB/s 的绝对吞吐,倍数只作对照;全部数字来自作者自己跑的基准。
定位与局限
定位:Hugging Face tokenizers 与 OpenAI tiktoken 的 drop-in 替代品,pip install gigatoken 即用;兼容模式下输出与 Hugging Face 逐 token 一致;支持 30 多个分词器家族(GPT-2、Llama 3、Phi-4、Qwen、DeepSeek 等)。局限(README 与第三方梳理均提到):SentencePiece 系(Gemma、Mistral 等)只快 7–22 倍(未做同等优化);WordPiece(BERT 系)不支持;Windows 未测试(建议 WSL);兼容模式为保证输出一致会损失一部分吞吐,最大速度要用原生 API 直接读原始文本文件;上线时无文件落盘(file sink 在路线图上)。
独立复核与判断
外界复核:独立小规模复现(KrabArena)在普通多核虚拟机上也测出数十倍于 tiktoken 与 Hugging Face 的速度——方向与作者数据一致,绝对吞吐随 CPU 与语料变化。判断:这是"基础设施里一个被忽视的环节被 SIMD 重写"的样本——慢的不是模型,是正则。对要处理海量训练语料的团队,值得一试;对只做推理服务的,先把 HN 那条质疑想明白再动手。
参考来源
- 仓库:https://github.com/marcelroed/gigatoken
- 第三方实测表与做法梳理:dev.to(2026-07-23);局限梳理:aibacon.net