字节笔记本
2026年11月7日 · 约 6 分钟读完
663 名开发者晒出自己的 agent 配置:Claude Code 断层第一
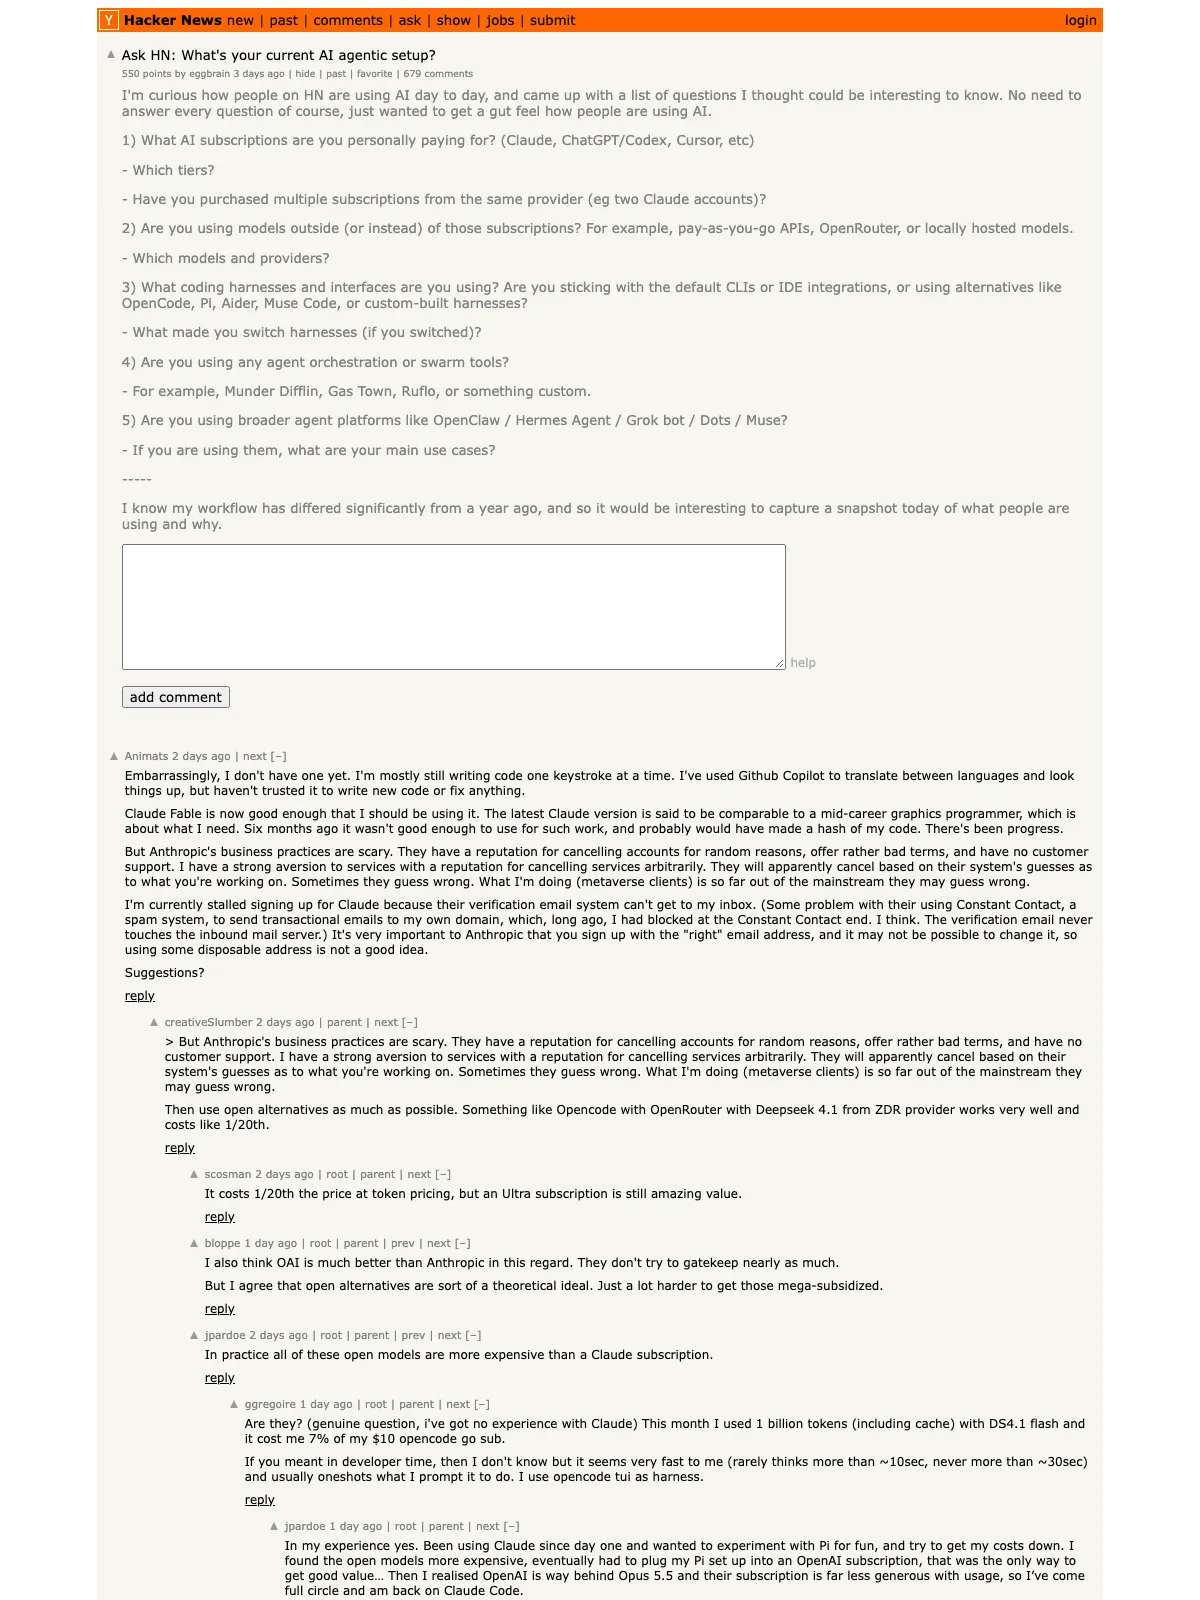
11 月 4 日,HN 用户 eggbrain 发了个 Ask HN 帖《What's your current AI agentic setup?》,问五个问题:付费方案、用的模型、coding harness(跑 agent 的程序)、是否用多 agent 工具、是否用常驻 agent 平台。帖子拿到 534 分、663 条评论,其中 392 条是直接回答。随后 RD Intelligence 发文把评论逐条读完并计数(11 月 6 日抓取;三名读者各读全部评论、按人计数,一人多次发帖只计一次):424 人至少提了一个工具。
先框定口径:这些数字是三名读者的手工计数,不是官方统计。样本是自愿回答的 HN 用户,爱调工具的人被过度代表;三名读者逐条笔记而非关键词搜索,但抽查发现仍有 1/10 的评论把"顺便提到 Claude"也算成了使用(关键词搜索只找到 141 人直接点名 Claude Code/CLI,该文计为 180 人,因为把 coding 语境下的"Claude"也算作 Claude Code)。别把 180、103 这类数字当成"Hacker News 用户的真实使用率"——当一张自报的图谱读。
工具榜(424 人中提及人数,一人可提多个)
Claude Code 180、Claude 订阅(Pro/Max/Team)145、Codex 103、ChatGPT 订阅/应用 92、Claude Opus 模型 80、DeepSeek 78、OpenCode 69、Pi 67、OpenRouter 55、Qwen 46、GLM(Z.ai)44、Gemini 36、Herdr 28、GPT 模型(API)26、VS Code 26、GitHub Copilot 22、Claude Sonnet 19、Grok 17、tmux 17、Antigravity 17、Cursor 16。
结构性发现(该文统计口径)
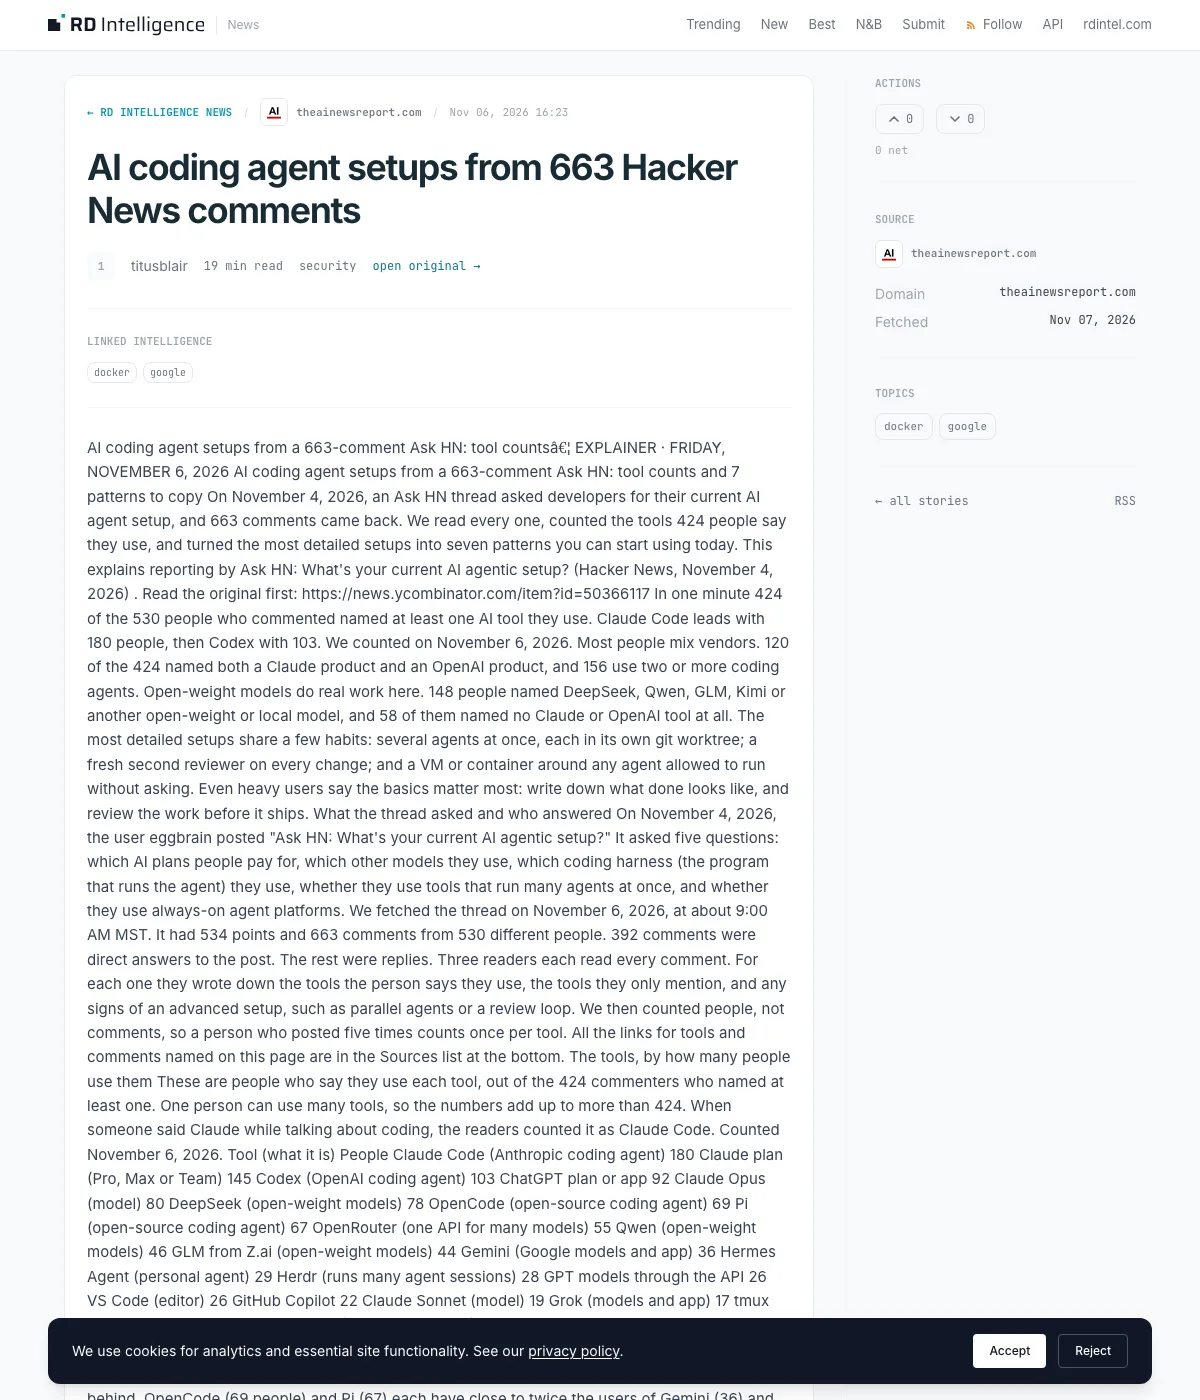
- Claude Code 断层第一,但没人只用它:180 名用户中只有 73 人不提其他 coding agent,67 人同时用 Claude Code 与 Codex;120 人同时用 Claude 系与 OpenAI 系产品,156 人用两个以上 coding agent;
- 开源 agent 并不落后:OpenCode(69)与 Pi(67)各接近 Gemini(36)的两倍、是 GitHub Copilot(22)与 Cursor(16)的三到四倍;
- 148 人提到 DeepSeek、Qwen、GLM、Kimi 等开源/本地模型,其中 58 人完全不提 Claude 或 OpenAI 的工具。
进阶做法的规模(读者打标签统计)
105 人并行跑多个 agent、75 人按模型价格路由任务、67 人把 agent 关进沙箱/VM/容器、56 人有"新 reviewer 复核每处改动"的循环、60 人用手机远程指挥、40 人跑 headless/CI agent、33 人先写 spec、31 人用记忆文件(AGENTS.md / CLAUDE.md)。
七个可复制的模式(该文提炼,附评论者原做法)
① 每任务一个 git worktree 并行跑多个 agent;② 每个改动都让一个"全新 reviewer"复核(KronisLV 循环复核到无严重问题、gregwebs 让 Codex 当 reviewer、glennfiedler 多模型互审);③ 强模型写计划、便宜模型照计划 build(gregwebs 三模型月均 100 美元以内;glennfiedler 四档分级、失败升档);④ 只在隔离的盒子里放开权限(Docker Sandbox / Lima VM,不放密钥);⑤ 先写 spec 与完成标准(AGENTS.md / CLAUDE.md);⑥ 工单变 PR 的 headless 流程(sudhirj 的 issue→一次运行→PR);⑦ 手机上指挥(Claude Code Remote Control、Tailscale + mosh)。
代表性个案(该文逐条复核原文):paustint——8 个 Claude Code agent 并行跑在常驻 worktree 里,Herdr 标出完成/待确认的窗格;skwee357——每项目一个 Lima microVM、5–7 个 worktree 并行、密钥隔离;gregwebs——Claude(20 美元)规划、Codex(20 美元)复核、DeepSeek(每天 1–3 美元)build 与协调,自述比单次提问慢约 3 倍但"缺陷事后更贵"(此为评论者自述估算,该文未实测);glennfiedler——约 200 张任务卡同时跑在 20 台 Tailscale 联网的机器上。
判断
这批数据的价值不在排名,在结构:并行、复核、路由、沙箱、手机指挥五件事同时出现在普通开发者的配置里——"多 agent"已经从炫技变成默认工作方式。两点校准:① 样本偏差照实说;② 与此前写的 advisor 三层分工篇对照:那篇是单一工具内的分工配方,这篇是几百人自报的全景——两条线都在说同一件事:单 agent 单会话的时代正在过去。
参考来源
- RD Intelligence 全文:https://static.rdintel.com/news/item/hn/50394444
- HN 原帖:https://news.ycombinator.com/item?id=50366117