字节笔记本
2026年10月5日 · 约 6 分钟读完
GLM-5.2 找洞 39% F1:开源模型垂直追赶提速
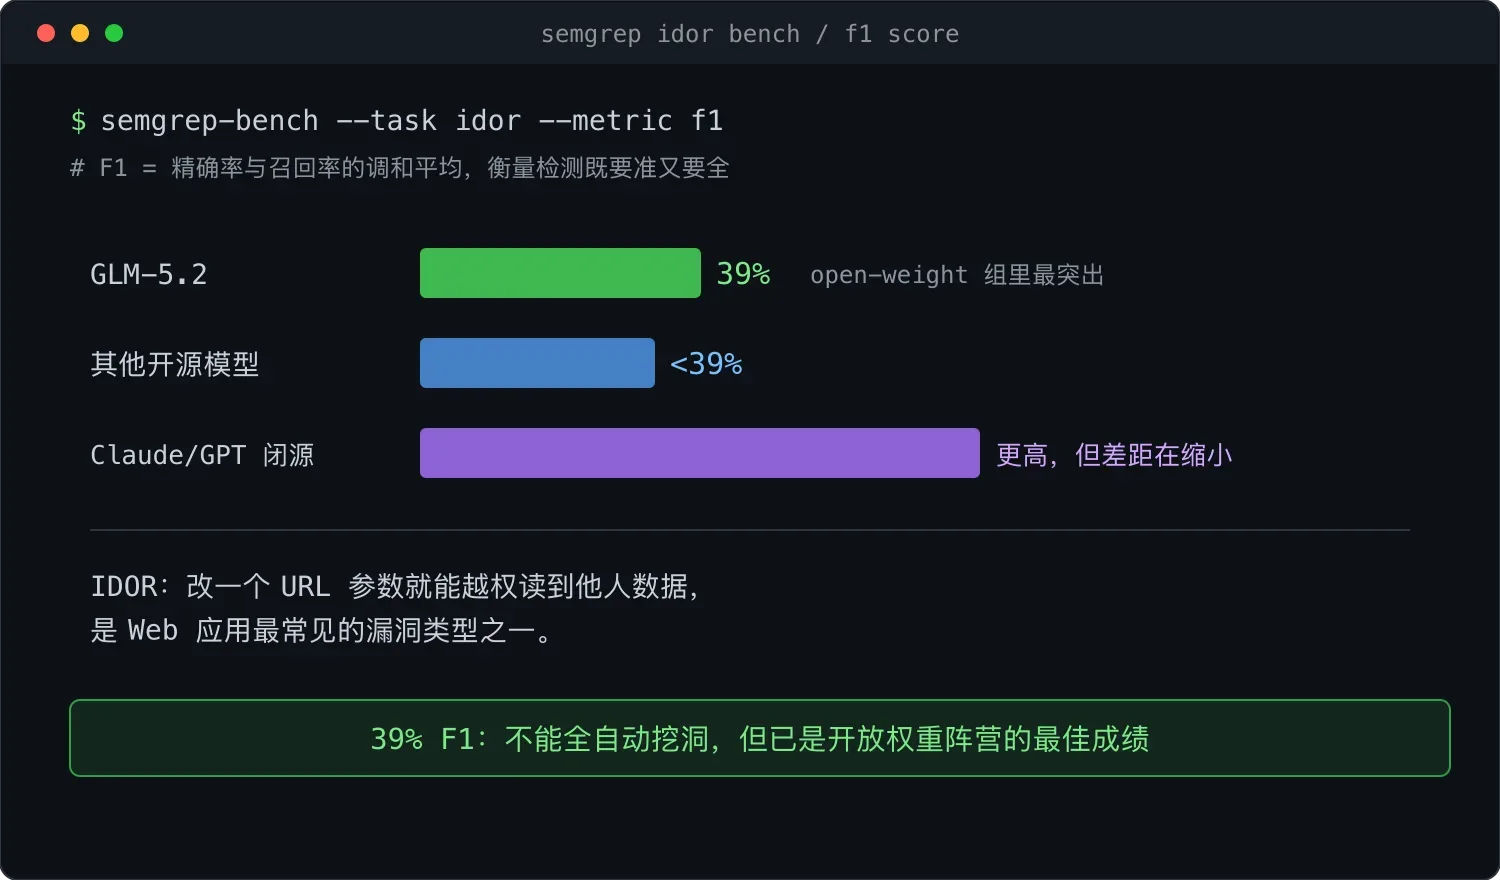
据 The Verge 报道,智谱的 GLM-5.2 在通用能力上还没有全面追上 Anthropic 与 OpenAI 的旗舰模型,但在网络安全找洞这类垂直任务上,差距已经明显缩小。更值得注意的是代码安全公司 Semgrep 的测试:GLM-5.2 在 IDOR 漏洞检测任务中拿到 39% F1,是同组模型里表现最突出的开放权重(open-weight)模型。
对一个以代码安全为核心场景的评测来说,这个数字背后的信号,比"谁又赢了一个榜单"更值得琢磨。
一、Semgrep 测了什么:IDOR 与 F1
IDOR(Insecure Direct Object Reference,不安全的直接对象引用)是 Web 应用最常见的漏洞类型之一。它的原理并不复杂:接口直接用可猜测的参数(比如自增 ID)定位对象,又没有校验当前用户是否有权访问,攻击者只要改一下 URL 里的编号,就能读到别人的订单、简历或聊天记录。这类问题在业内归入失效的访问控制范畴,多年来一直排在 Web 安全风险清单的前列。
Semgrep 是知名的代码安全扫描工具,它测试了多个 AI 模型在自动检测 IDOR 漏洞上的表现,以 F1 分数(精确率与召回率的调和平均,衡量检测既要准又要全)作为指标:
| 模型 | IDOR 检测 F1 | 类型 |
|---|---|---|
| GLM-5.2 | 39% | 开放权重(open-weight) |
| 其他开源模型 | 低于 39% | 开源 |
| Claude、GPT 等闭源模型 | 更高,但差距在缩小 | 闭源 |
需要说明,39% 不是一个可以照单全收的分数,离全自动挖洞还有明显距离。它的意义在于排序:在开放权重阵营内部,GLM-5.2 是目前最突出的一个,而且与闭源模型的差距正在收窄。
二、为什么开源模型在安全场景有天然优势
真正值得关注的不是某个榜单的输赢,而是当模型权重开放、成本更低、可自部署,并且能被安全团队嵌进自己的工作流时,AI 能力的扩散速度会比封闭模型时代快得多。有三个趋势在同时发生。
趋势一:开放权重,可以自己部署。 GLM-5.2 是开放权重的,安全团队可以把它部署在自己的内网里,代码资产不出公司。这对安全场景极其重要:待审计的源码本身就是敏感资产,而使用闭源模型意味着要把代码发到第三方云端,很多企业的安全合规部门不会放行。
趋势二:成本足够低。 据报道,GLM-5.2 的推理成本约为 GPT-5.5 的十分之一。扫描一个大型代码库可能要跑几万次推理,这个量级下成本差距会被急剧放大:闭源模型的账单让人望而却步,开源模型则可以放开了跑。
趋势三:垂直任务的追赶速度快于通用任务。 在聊天、通用编码等能力上,开源与闭源模型仍有差距;但在找漏洞、做安全审计这类垂直任务上,追赶速度明显更快。原因不难理解:垂直任务更聚焦、更结构化,判断标准清晰,天然适合用 benchmark 度量,模型的每一点进步都会直接反映在分数上。
三、传统扫描和 AI 扫描差在哪
传统扫描工具基于规则和正则匹配,擅长发现已知模式,但对 IDOR 这类问题几乎无能为力,因为判断"这个对象属于谁、这次请求有没有权限"靠的不是模式匹配,而是对代码语义和业务逻辑的理解,这正是大模型擅长的事情。
| 对比维度 | 传统扫描(规则/正则) | AI 扫描(GLM-5.2) |
|---|---|---|
| 发现方式 | 匹配已知模式 | 理解代码语义 |
| 误报率 | 高,规则宽泛 | 相对低,能结合上下文 |
| 漏报率 | 高,只能找已知模式 | 相对低,可发现新型漏洞 |
| IDOR 检测 | 几乎做不到 | 39% F1 |
| 成本 | 低 | 开源模型同样低 |
| 私密性 | 完全本地 | 开源模型可本地部署 |
AI 安全扫描的瓶颈,一直是闭源模型太贵而且不能自部署,GLM-5.2 这类模型把两个问题一起解决了。落到工程上,一个典型的内网工作流是这样的:
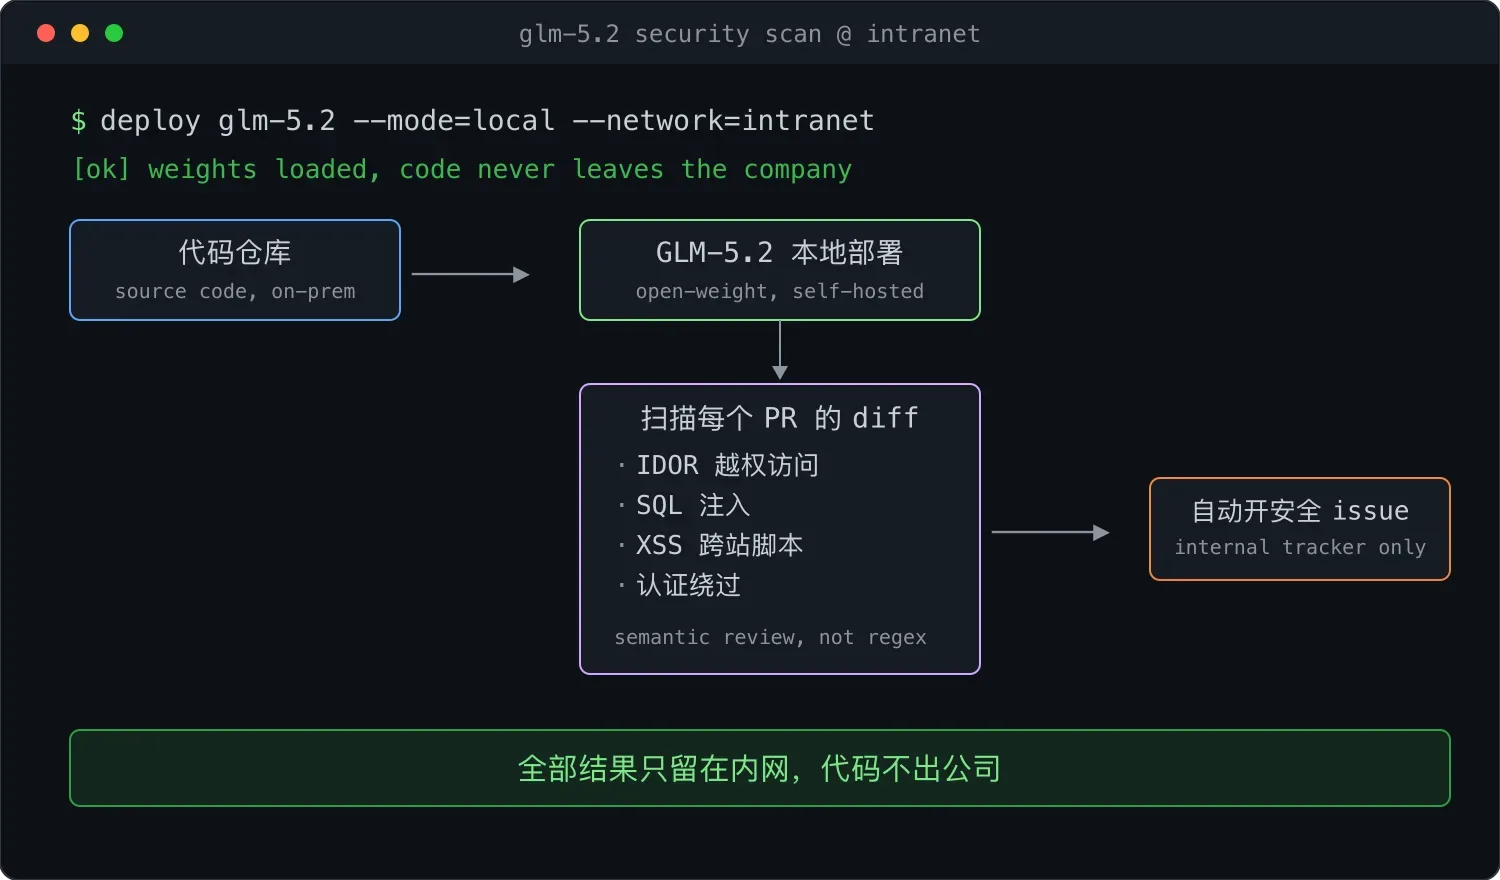
代码仓库留在内网,本地部署的 GLM-5.2 扫描每个 PR 的 diff,检测 IDOR、SQL 注入、XSS、认证绕过等常见漏洞,自动开出安全 issue,全部结果只留在内网。
四、落地之前,先认清 39% F1 的含义
对打算把这类模型接进流程的团队,有三点务实的提醒。
第一,39% F1 意味着模型目前更适合当初审助理,而不是终审法官。它能把安全工程师从海量代码里解放出来,把可疑的访问控制问题圈出来,但每个报告的漏洞仍需人工确认,误报和漏报都真实存在。
第二,AI 扫描应该与现有工具链叠加,而不是替换。规则引擎负责已知模式的高效拦截,AI 负责语义层的深挖,两者互补,比单用任何一边都更稳。
第三,选型时把部署方式放在第一位。对安全场景来说,能不能自部署、数据出不出内网,比榜单分数更能决定一个模型能不能真正用起来,这也是开放权重模型在这个领域被看好的根本原因。
五、小结
GLM-5.2 在 IDOR 漏洞检测上拿到 39% F1,不是全面反超,而是证明了一件事:垂直领域的 benchmark 追赶速度,比通用能力更快。当开放权重、低成本、可自部署三个条件同时成立,AI 安全能力的扩散速度会比封闭模型时代快得多。对安全团队来说,现在值得认真评估的,是把自己工作流里的哪一段先交给模型来跑。
本文基于 The Verge 对 GLM-5.2 的报道与 Semgrep 的安全模型测试结果整理,具体数据以原始报道为准。