字节笔记本
2026年11月5日 · 约 2 分钟读完
看人干活就能学:KAIST 桥接人类视频与机器人动作
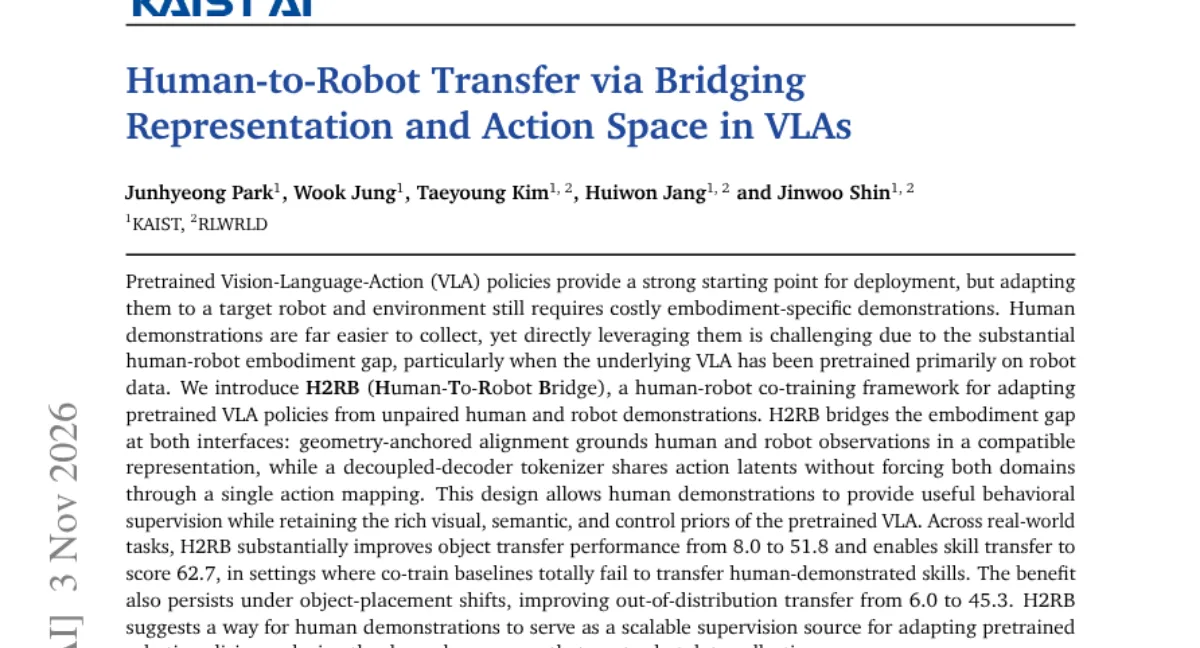
机器人学习最尴尬的现实:人类演示遍地都是,机器人演示贵如黄金,但两者之间隔着具身差异,人手和机械手的运动方式对不上。KAIST 与 RLWRLD 的 H2RB(arXiv 2611.04391)给出了一套桥接方案,让预训练 VLA 直接从无配对的人类和机器人演示中共同学习。
桥有两段。第一段是几何锚定对齐:用腕部姿态加五个指尖位置作为人与机器人的共同几何目标,通过残差适配器把 VLM 条件特征锚定到手部几何上,每个观测自带监督目标,因此不需要配对数据,也不用做观测合成。第二段是解耦解码器 latent tokenizer:在共享的腕手参数化之上,用变分自编码器学出共享 latent 动作空间,人和机器人各用独立解码器,避免两种运动动态被硬压进一个动作映射;配合质心匹配与方差正则,人机 latent 差距从 3.81 降到 1.53,缩小 59.8%。
数据规模扎实:OpenArm 语料约 908 段、20.86 万帧,异构多本体训练集含 14,548 段、约 501 万帧(含 EgoDex 一万段)。结果按论文口径:物体迁移任务加权分从 8.0 提到 51.8(共训基线只有 8.0),分布外迁移 6.0 到 45.3;空气炸锅开关这类技能迁移,共训基线是 0.0,H2RB 拿到 62.7,加指令条件化后 83.3;在 RB-Y1 双臂平台上的包裹翻面任务,纯机器人 64%、人机混合训练 72%、几何锚定混合训练 78%。
一个反直觉的数据值得单独说:用人类数据迁移训练出的策略,执行速度 7.36 厘米每秒,比纯机器人数据的 2.52 厘米每秒快了近三倍,而成功率相当。人类演示不但能用,还自带效率先验。
对具身团队,这篇和前几天写的 PyRUA-DataFarm 是互补的两条数据路线:一个用仿真加渲染造数据,一个把现成的人类视频接进来。共同指向的结论是,机器人数据的瓶颈正在被工程手段逐个拆掉。