字节笔记本
2026年11月8日 · 约 4 分钟读完
7 万字、80 万 GPU 小时:Hugging Face 把训 MoE 的坑都写进了手册
7 万字、80 万 GPU 小时:Hugging Face 把训 MoE 的坑都写进了手册
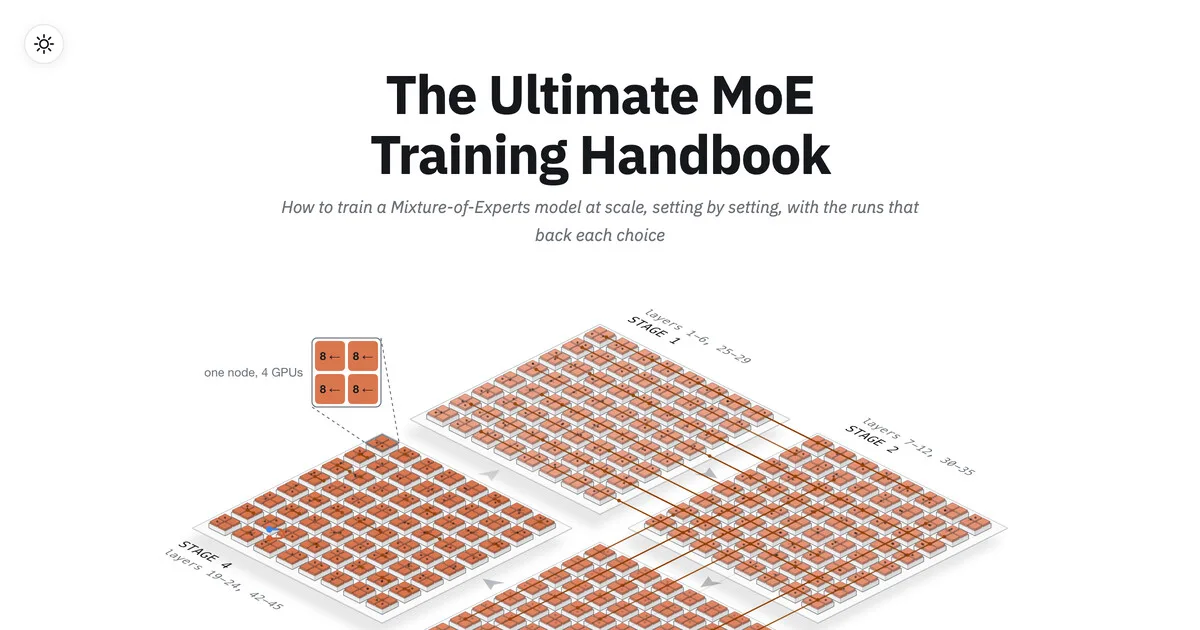
Hugging Face 11 月 5 日发布《The Ultimate MoE Training Handbook》(Thomas Wolf 与 HF 团队):约 7 万字、55 张交互图、可运行代码,官方建议阅读时间 1–2 天。先定性:这是技术手册,不是模型发布,也不是理论综述——定位是“操作手册”。经验来源按二次报道口径(dev.to / opcnew 转述手册表述):约 80 万 GH200 GPU 小时,在 Alps 集群上跑出(此数字本篇未能从手册页面直读核对,引用时保持转述口径);实验环境为 AWS P5 节点(8×H100 80GB、EFA 互联)+ Megatron-LM(commit d6316eb45)+ Slurm/Enroot/Pyxis。
开篇数据:前沿是稀疏的
手册直读口径:Artificial Analysis 指数上得分最高的 20 个开源权重模型里 18 个是 MoE(例外是第 12、13 名的 Nanbeige4.3-33B 与 Qwen3.8 27B,均为稠密);五家领先实验室的头名模型——DeepSeek V4.1 Flash 1017、GLM-5.3、MiMo-V2.6-Pro、Ling 3.1 Flash 1019、MiniMax-M3.1-Flash——全是 MoE。前作《Smol Training Playbook》讲训稠密模型、MoE 只沾一点,本手册是续篇。
结构与教学模型
第 2 章搭环境 + 在单节点训一个小 MoE(6.86B 总参、每 token 激活 1.22B——注意这是教学用小模型,不是 80 万 GPU 小时实验的主模型,别张冠李戴);第 3 章拆解 MoE 训练的解剖结构(路由器、负载均衡、跨 GPU 的 all-to-all 通信);第 4 章把选择带进部署与强化学习。手册区分三类证据:自家集群实验结果、前沿模型的公开信息、小规模模拟。
关键发现(手册直读部分)
- 一次带注解的运行追踪里,all-to-all 占了该训练步的一半时间——追问“这一半里网络真正在搬多少数据”是第 3 章的主线;
- NCCL 回退到 TCP socket 时,EP16 代理慢约 25 倍(1.7 对 42.0 TFLOP/s),而日志一切正常——“看着都对、就是慢”的典型故障,要用
NCCL_DEBUG=INFO查 "Using network"; - all-to-all 带宽随节点数下降:2 节点 77.14 GB/s、4 节点 39.25、8 节点 30.91——基线必须按节点数分别设;
- 强制均匀路由一次测量提速约 40%(此条为 dev.to 摘要口径)。
判断
三点校准:① 与第四十四批 MaxxBench 区分:那篇讲“基准分数可以被猜题与骗分操纵”,这篇讲“训 MoE 时哪里会悄悄变慢、怎么查”——一个是评测可信度,一个是训练工程,别混写;② 与《Smol Training Playbook》是稠密与稀疏的续篇关系,引用时别当成同一本;③ 手册的价值排序值得记住:先教你怎么“看见”问题(跟踪器、nccl-tests、按节点数设基线),再教你怎么修——二次报道的原话说得好:它是工程地图,不是成功的保证,照抄并不能保证训出好模型。