字节笔记本
2026年10月5日 · 约 4 分钟读完
Claude Code 也能当 RL 训练场了,Hugging Face 实测四种 harness
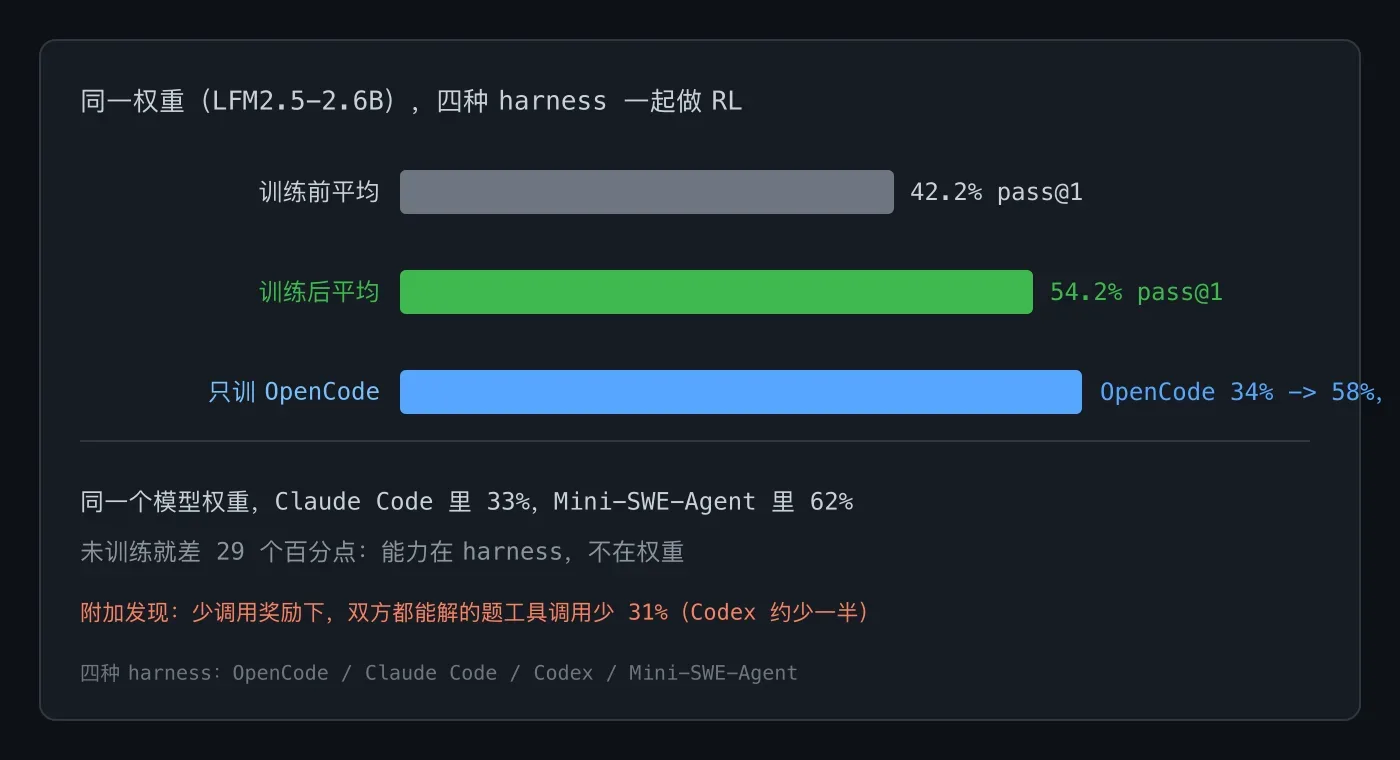
Hugging Face CEO Clem Delangue 几天前发的那条推文值得单独写一篇:同一个大模型权重,放进四种 coding agent harness 里一起做强化学习,平均成绩从 42.2% 提到 54.2% pass@1。这组数字背后是一个正在成型的生态:coding agent 正在从「可用的工具」变成「可训练的环境」。
实验说了什么
用的模型是 LFM2.5-2.6B,训练前后都是同一份权重。四种 harness(OpenCode、Claude Code、Codex、Mini-SWE-Agent)一起做 RL,平均分从 42.2% 涨到 54.2%;对照组只训 OpenCode 一种,OpenCode 自己从 34% 涨到 58%,但增益基本留在了被训的那个 harness 里。这个对照说明了一件事:RL 练出来的很大一部分是「怎么配合这个 harness 用工具」,不是普适的推理能力。想跨 harness 迁移,就得像官方指南这样把四个环境一起训。
更有说服力的是一个基线数字:未训练的同一权重,在 Mini-SWE-Agent 里 62%,在 Claude Code 里只有 33%,差着 29 个百分点。也就是说 harness 本身就是能力的一部分,这正是「把 harness 做成 RL 环境」这个方向的立论基础。附带的发现也很实际:加了少调用工具的奖励后,双方都能解对的题目上工具调用次数少了 31%(Codex 上大约少一半),省钱又变强。
生态怎么拼
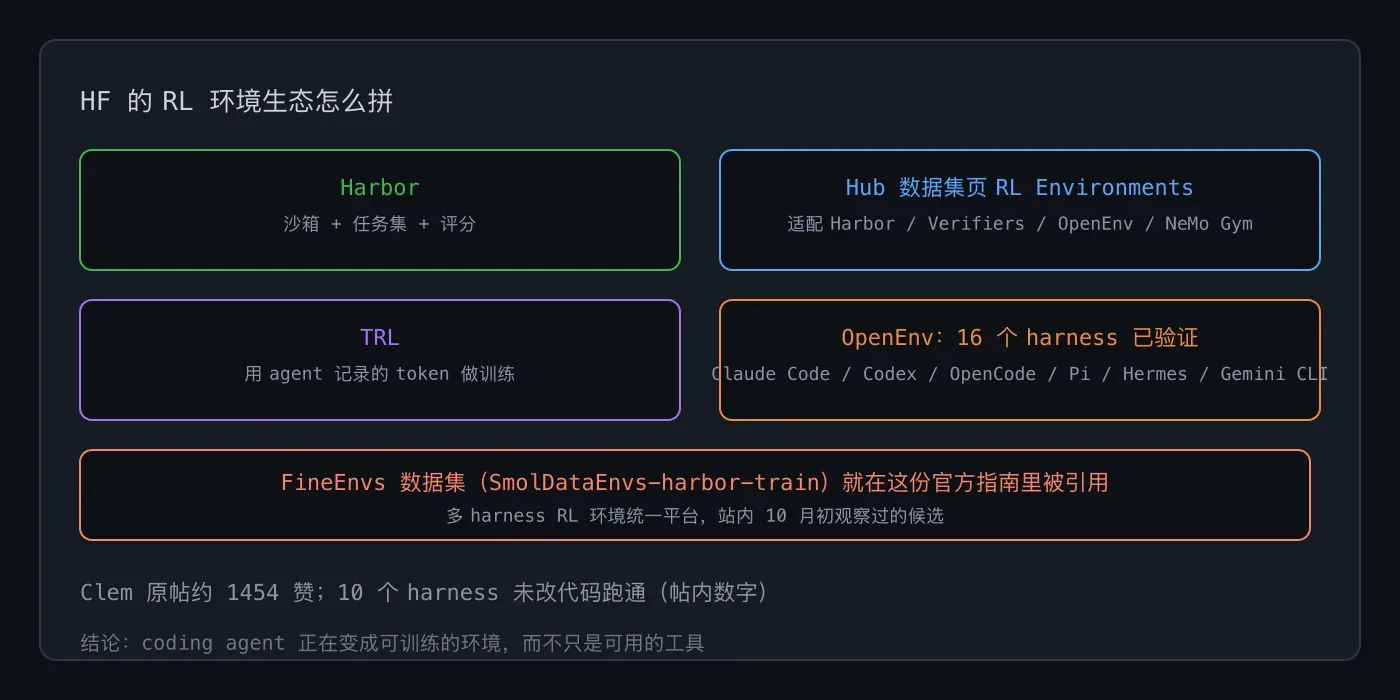
Hugging Face 把这条链路拆成了四块:Harbor 承担沙箱、任务集和评分;Hub 上线了 RL Environments 数据集类型页,标注适配 Harbor、Verifiers、OpenEnv 和 NeMo Gym 四套框架;TRL 负责用 agent 记录下来的 token 做训练;OpenEnv 侧已有 16 个 harness 端到端验证跑通,Claude Code、Codex、OpenCode、Pi、Hermes、Gemini CLI 都在列。Clem 帖子里说当时已有 10 个 harness 未改代码跑通。
怎么跟进
路径已经全部公开:Hub 的数据集页按 rl-environment 标签聚合了现成环境,挑一个适配你所用框架的任务集,照官方指南跑 TRL 训练即可;有自己的任务想变成环境,按 Harbor 的任务格式封装成数据集上传,就能进入这条链路被别人复用。对个人开发者,最划算的切入点是先拿小模型(实验里的 LFM2.5-2.6B 量级)复现一次流程,训练成本可控,跑通后再换大模型或自定义环境。
值得注意的两个点
一是数据集页里出现了 FineEnvs 的名字:这份多 harness RL 环境统一平台的数据集(SmolDataEnvs-harbor-train)就在官方指南的引用列表里,说明社区项目已经开始被收进官方链路。二是这条线的门槛比想象中低:环境数据集是 Hub 上的公开数据集,框架全是开源的,剩下需要的只是训练预算。
对做 agent 产品的人来说,这套方法论的潜台词是:你的 harness 不只是产品体验,还是别人模型的成绩单和训练场,harness 的工具设计会直接决定接入它的模型能被训成什么样。coding agent 的下一轮竞争,可能从「谁的体验好」变成「谁的环境更容易被训」。