字节笔记本
2026年11月5日 · 约 2 分钟读完
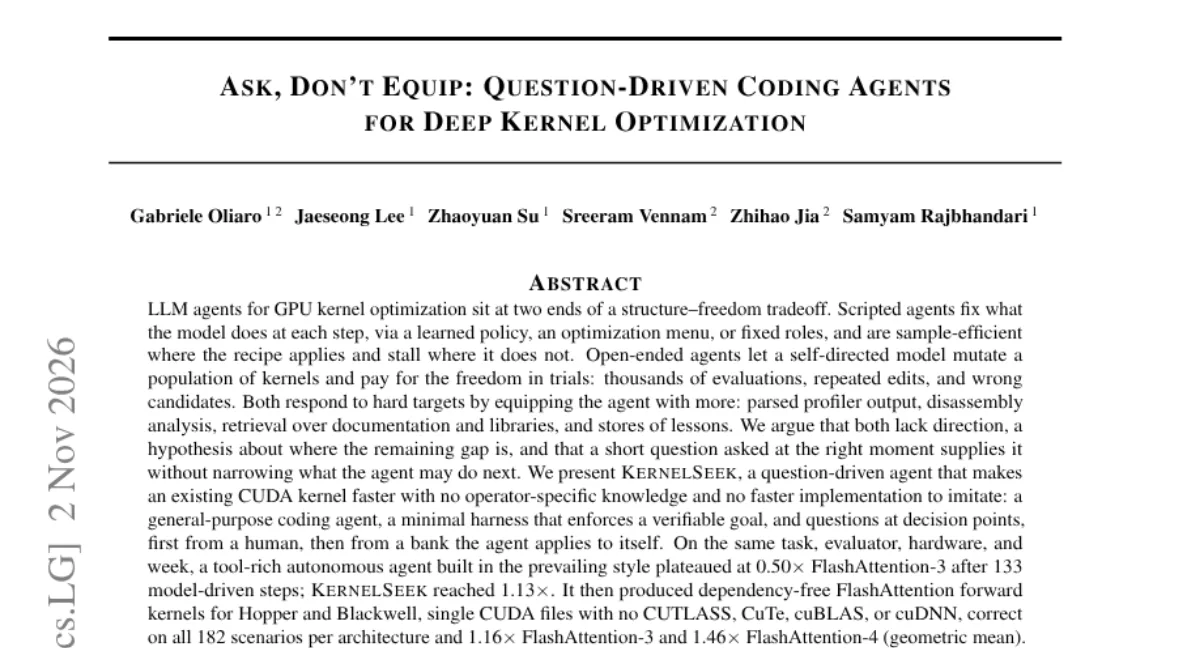
少装工具多提问:Snowflake 的 agent 写出了超 FA3 的内核
GPU 内核优化的 agent 化,业内一直卡在两头:脚本化 agent 高效但只会套预设配方,开放式 agent 自由发挥却慢、错得多(三到五成候选根本不正确)。Snowflake AI Research 与卡内基梅隆大学的 KernelSeek 给出的诊断很妙:缺的不是更多信息,而是方向,也就是「性能差距到底在哪」的假设。补方向的方式,是提问。
KernelSeek 的结构有三件套:一个最小评估 harness,用 Stop hook 强制可验证目标(校验正确性、计时);一个不预消化工具的通用编码 agent;以及一套在决策点抛出的问题库,101 条核心问题分十组,覆盖 Ampere、Hopper、Blackwell 清单和注意力插件。提问的时机被严格定义:攻坚开始、进展停滞、agent 宣称到达极限、出现可疑的大幅提升、正确性异常。前期由人提问,后期 agent 用题库自我提问。
任务设定足够硬核:为 Hopper 和 Blackwell 写无依赖的单文件 FlashAttention 前向内核,不碰 CUTLASS、CuTe、cuBLAS、cuDNN,覆盖 vLLM 场景面,每个架构 182 个场景(fp8、paged、GQA、因果掩码等),以 FA3 和 FA4 为参照。
对照实验把方法的价值拍在了桌上:装备齐全的自主 agent(133 步、约 62 个模型小时、660 美元 API 费)在 26 个配置上止步于 FA3 的 0.48 到 0.50 倍;KernelSeek 同硬件同周期做到 1.13 倍,26 个配置里 22 个达到或超过 parity。最终内核 fa3_hopper.cu 约 3,600 行,达 FA3 的 1.16 倍;fa4_blackwell.cu 约 10,200 行,达 FA4 的 1.46 倍(几何平均),对比含 cuDNN、FlashInfer 在内的最快可用实现也有 1.10 倍和 1.07 倍。全部代码由 agent 经 Claude Code 和 Cursor 写成(Claude Opus 驱动),16 个会话、162 条人类消息、11,532 次工具调用。
最有启发的是复盘发现:每一次大的性能跃升,背后都是一个改变思考层面或质疑其宣称极限的问题,而不是提供新信息。内核、harness、题库和全部 trace 以 Apache 2.0 开源,做 agent 工作流的团队,题库本身可能比内核更值得抄。