
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
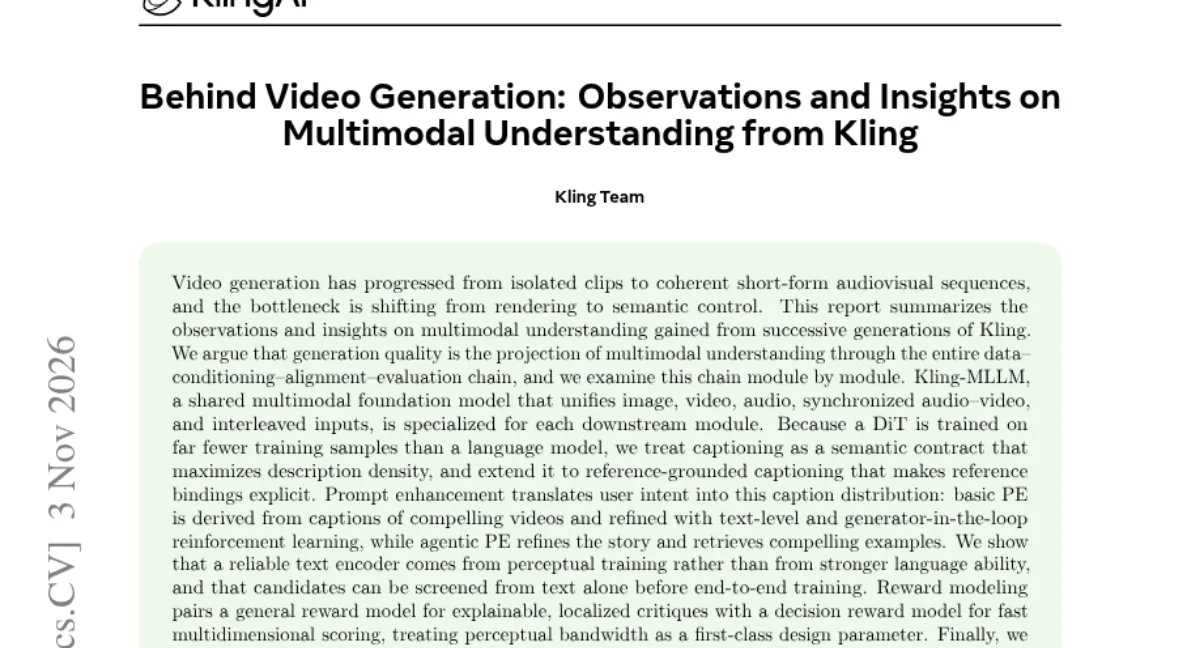
可灵把视频生成的理解账本摊开给你看
API中转
¥120
视频生成模型的文章大多是发布稿,可灵团队这篇(arXiv 2611.04916)却是账本:把 Kling 1.0 到 4.0(含数字人与运动控制)背后「多模态理解」技术栈的经验,按数据、条件化、对齐、评估全链条摊开,每个模块都按「观测、机制、工程含义」三段写。核心论点一句话:视频生成的质量,是多模态理解穿过整条链路的投影。
几条观测对从业者很值钱。瓶颈正在从渲染转向语义控制:视觉保真度再涨,也不会自动带来正确的动作、镜头语言和叙事连贯。数据效率取决于描述密度:DiT 训练样本远少于语言模型,单位视频时长的文本描述密度成了核心指标。字幕被定义为「语义契约」,须包含主体动作、空间、镜头与光、时间切分、可见文字与声音、美学六类信息;配套的 Kling-Captioner 在多个基准上超过了 Gemini 与豆包的对应模型。
还有几条反直觉的:文本编码器靠感知训练提升,而不是靠更强的语言能力;候选方案可以在昂贵的端到端训练之前用纯文本筛选;奖励模型要双轨设计,通用奖励给可定位的批评、决策奖励做快速打分。评估则应跟随任务分解,单一聚合分数根本定位不了失败源头。
这篇对业界的最大启示是归因方式:生成失败不能直接怪生成器,可能是字幕漏了、条件化丢了时序、奖励模型偏爱静止画面。把理解当成全链路属性,才可能一路向上游追溯。做视频生成或任何「生成类产品」的团队,这份工程纪律都值得抄走。另一个隐含的开放信号是 Kling-MLLM 基座阵容(27B 稠密到 397B MoE)与参考锚定字幕的「关系式监督」:用任意相似视频对构造训练数据,不再依赖真实编辑对,训练供给的天花板被自己掀掉了。报告页与 arXiv 均可查,引用作者名单前建议先核对原文署名。
相关文章

分享: