
字
字节笔记本
2026年11月6日 · 约 2 分钟读完
7.8 万个工具调用节点,人大把 MCP 环境搬进训练数据
API中转
¥120
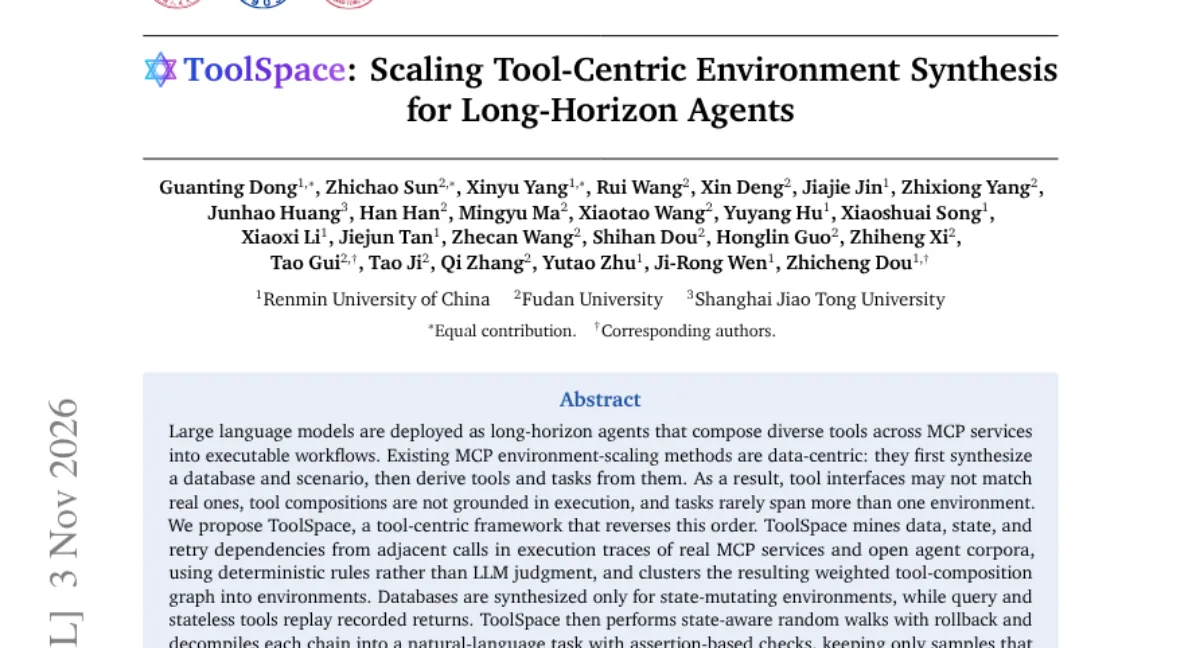
训练长程 agent 最缺的不是模型,是能练手的环境。现有 MCP 环境的合成方法是「数据中心」的:先造数据库和场景,再倒推工具与任务,结果是工具接口和真实接口对不上、工具组合缺乏执行依据。人民大学联合复旦、上海交大的 ToolSpace(arXiv 2611.05036)把方向反过来:以工具为中心,从真实 MCP 服务和开放智能体语料的执行轨迹出发重建工具空间。
规模数据足够扎实:77,760 个工具调用节点、来自 2,042 个真实工具、804 个环境,原始素材超过 20 万条智能体与工具的交互轨迹;产出的训练集含 34,376 条 SFT 轨迹,其中含至少 5 次调用的轨迹平均 18.86 次工具调用、最多跨 22 个环境。方法上有两个「笨功夫」的坚持:边不用 LLM 判断,而是用确定性规则从相邻调用中挖数据依赖、状态依赖、重试依赖三类边;环境只在含状态修改操作时才合成数据库,无状态工具直接回放缓存的返回。
成绩按论文口径:Pro 基准上七个前沿模型最多下降 38.2 分,说明这环境真的难;Qwen3.6-35B-A3B 平均分从 23.0 练到 41.0(RL 后 43.2),ToolSpace-744B-A40B 拿到 56.6,与 Claude Opus 5 持平、超过 GPT 5.6 Sol。消融显示「执行见证」的边明显优于 LLM 判断的边,合成成本比对照方案省了约 55.3%。
对做 agent 训练的团队,这篇的启示是方法论级的:环境合成的可信度,来自从真实执行轨迹出发而不是从想象出发。代码、模型与环境已经开在 GitHub 与 Hugging Face,练手环境直接开箱。
相关文章

分享: