字节笔记本
2026年10月9日 · 约 6 分钟读完
一次前向不吐字,凭什么只要三十三毫秒
边缘侧只要一个是或否、一个路由、一个分数时,再开一轮生成再解析,既慢又容易编。Laya 把这件事收成一次前向:状态加类型化问题进去,选项概率出来,不吐自由文本。权重在 Hugging Face,许可证 Apache-2.0。模型卡写上个月下载四万一千四百六十八次。产品页写自托管标价为零,对照已发表的 Jev 托管是每百万输入 0.042 美元。配套源码仓库本轮核到三万一千九百三十九星、两千八百四十一次派生,创建于 2026-09-18,最近推送 2026-10-08。
它不是又一个聊天模型。问题类型只有 choice、score、noul 三种,和 Jev、SystemOne 对齐。路由器按请求挑检查点,脚本和语言识别开销写在 0.09 到 0.73 毫秒。装好就能跑:
python -m pip install layaPython 要 3.10 及以上。服务端是 laya-serve,走 POST /v1/systemone。可选包包括服务、MCP、LangChain、LlamaIndex、CrewAI、ONNX、加速和结构化输出。浏览器侧可装 TypeScript 包,用 ONNX 在页面里跑,或对着 Python 服务当客户端。设备顺序是 CUDA、苹果芯片、英特尔 XPU,最后才是 CPU。英特尔 Mac 要钉住 NumPy 小于 2、torch 2.2.2、transformers 4.57.6。
三套权重,一个路由器
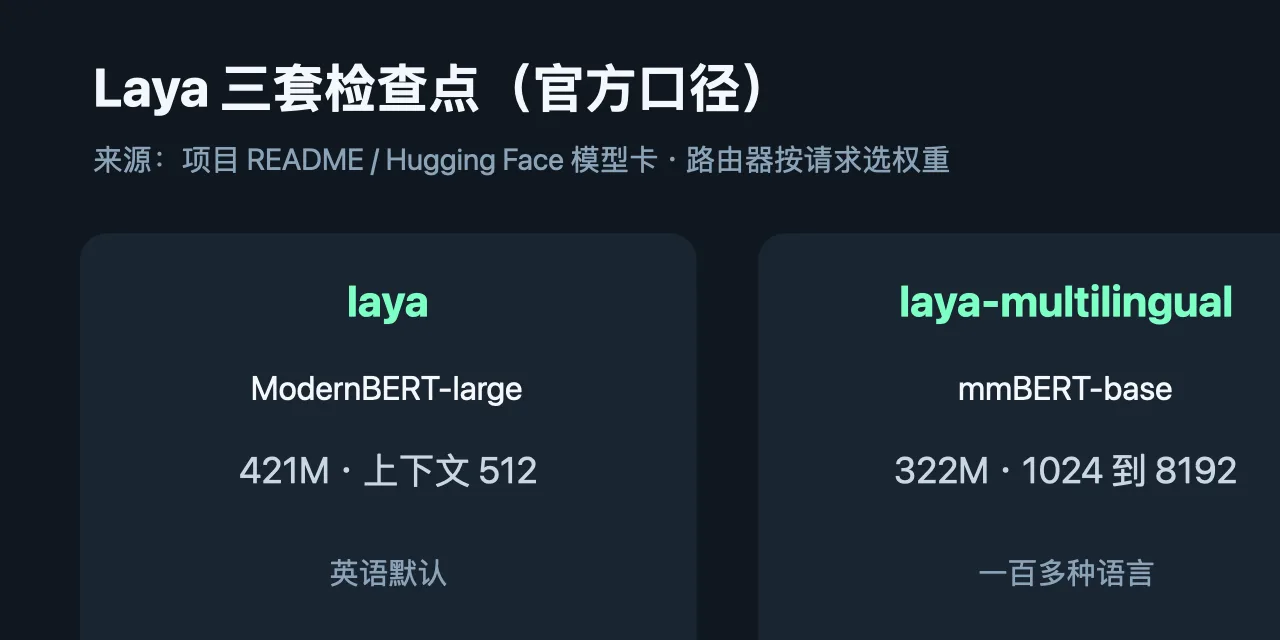
README 列了三套检查点。laya 用 ModernBERT-large,四亿两千一百万参数,上下文 512,英语默认。laya-multilingual 用 mmBERT-base,三亿两千二百万参数,默认 1024,可拉到 8192,覆盖一百多种语言。laya-typed-decisions 还是 ModernBERT-large,上下文 1024,给工作流微调。本地三套大约 2.3 GB。懒加载默认最多同时留两套,服务端才适合 preload=True。命令行是 laya "文本" --preset triage,也可以指定模型、最低置信度和批处理。
调用很短:
from laya import Router
router = Router()
result = router.predict(state, questions)
返回值里能看到选中项、分数和这次用了哪套权重。长文档走 predict_long 开窗。选项特别多时要加大 head_max_len,或改用 predict_shortlist、predict_tournament。产品页写,超过大约 20 个选项会掉。每个标签大约吃三到四个 token,选项一多,默认头预算会先饿死。别把 true 和 false 当成 choice 的键。否定句可能翻车。英语检查点在非拉丁文上会很自信地错,高棉语原始分写成 0.000。
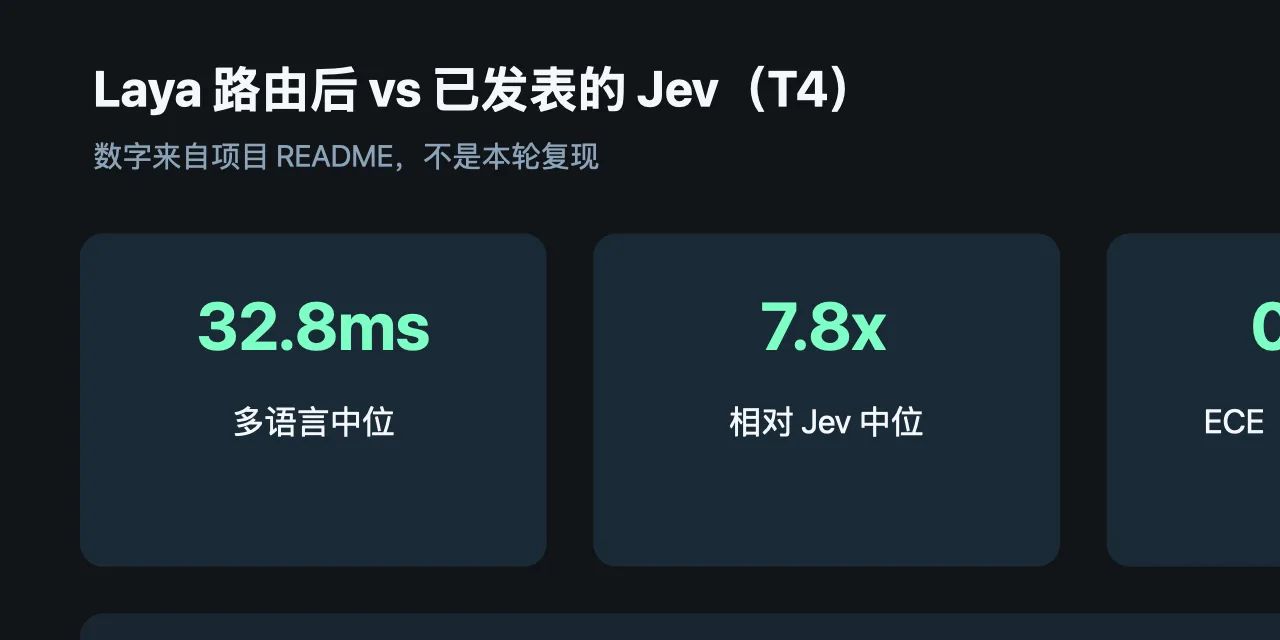
T4 上一道题,英语中位 39.5 毫秒,多语言 32.8 毫秒;十道题一共 72.3 毫秒,合每题 7.2 毫秒。和已发表的 Jev 比,类型化判定 0.766 对 0.727,AG News 0.950 对 0.910,DAIR Emotion 0.595,校准误差 0.081 对 0.246,中位大约快 7.8 倍。MASSIVE 英语 0.783,另外十三种语言多语言检查点 0.451。XNLI 英语 0.860。可用语言英语检查点 23 出 51,多语言 48 出 51。这些是官方口径,不是本轮复现。
零样本别直接当守门员
类型化判定零样本接近随机。微调后准确率从 0.362 到 0.766。Banking77 在默认选项预算里只有 0.425,Jev 是 0.870,高基数分类别硬上。温度没拟合以前会过自信,min_confidence 只是策略,不是保证。快路径和混合精度会让概率轻微漂移。训练写的是对着恰当评分规则做强化学习,仓库里有类型化判定的微调笔记本。MCP 额外包会挂出预测、批处理、路由、决定、短名单和预设这些工具。钩子和额外模型只在服务端的超文本接口上生效。
接口兼容意味着边缘已经在跑 Clef 或 Jev 的服务,可以先换客户端试。同周还有一篇针对类型化判定模型的选项通道攻击预印本:只改一个放行选项的名字,有的模型会直接打开门。值班台若拿它挡生产动作,仍要把选项名和字段解析写死在代码里,不要只信分数。仓库提交超过一千七百,模型卡上还有上百个微调和量化版本,不是空壳。但热度不等于已经替你在业务集上调好。先在自己的路由、分诊、是否题上微调,再谈替换托管判定接口。
仓库本轮还能核到一千七百八十七次提交、九十七个未关闭议题。模型卡另外写了十九个适配器、一百五十五个微调、六十五个量化版本,以及六十五个演示空间。演示空间可以直接试一轮打分,不必先搭服务。路由器默认可只常驻两套权重,内存紧的机器先别三套一起预加载。
若已经有一份 JSON Schema 或数据模型,仓库提供从结构直接生成判定题的入口,不必手写每道 choice。批处理接口适合离线回放日志:把历史工单状态和当时的选项表喂回去,看分数是否和线上一致。这比拿聊天模型复盘更便宜,也更容易对表。英语检查点在五十一项语言评测里只有二十三项明显高于随机,非拉丁文务必走多语言检查点,不要图省事。
和本站刚写过的 Clef-omni 不是一条产品线。Clef 吃音视频,参数在三十亿专家这一档,托管按百万 token 收费。Laya 是四亿级编码器,只吃文本和 JSON,延迟按几十毫秒谈,适合先在本机或边缘盒子上挡一层。两者接口都朝 SystemOne 靠,客户端可以共用同一份问题表,再按模态和预算分流。先把是否题和三到五个选项的路由跑通,再考虑七十七类那种细分类。