字节笔记本
2026年10月5日 · 约 2 分钟读完
3B 模型怎么赢 72B?把奖励换成认图
调结构比堆参数划算,这个道理本周已经反复出现,10 月初的两篇论文又添了两个干净利落的案例:一个换了奖励的问法,一个补了一条辅助损失,各自撬动了一个数量级。
LineupRL:奖励改成认图,3B 反超 72B
时序字幕是信号与自然语言之间的桥。SFT 路线受限于教师模型的质量天花板,RL 路线的奖励又难以覆盖开放生成。Haochen Zhang 等人的 LineupRL(arXiv:2610.01800)想了个巧招:奖励就是认图。冻结的 LLM 评审员读生成的字幕和一组候选时间序列的原始数值,任务是从中挑出被描述的那条。
这个设计妙在难度匹配:从若干干扰项里认出正确答案,比出题容易、比主观判卷可靠,现成 LLM 无需微调就能当奖励模型。效果硬核:3B 的 VLM 用这个管线训练后,在字幕、预测与重构任务上全面胜过 SFT 与 RL 基线,而它只有被蒸馏的那个 72B 教师二十四分之一的参数。案例分析还显示它抗奖励黑客,生成的字幕会追踪趋势并点出关键数值。页面未见代码链接。
SLIM:一条损失救活世界模型
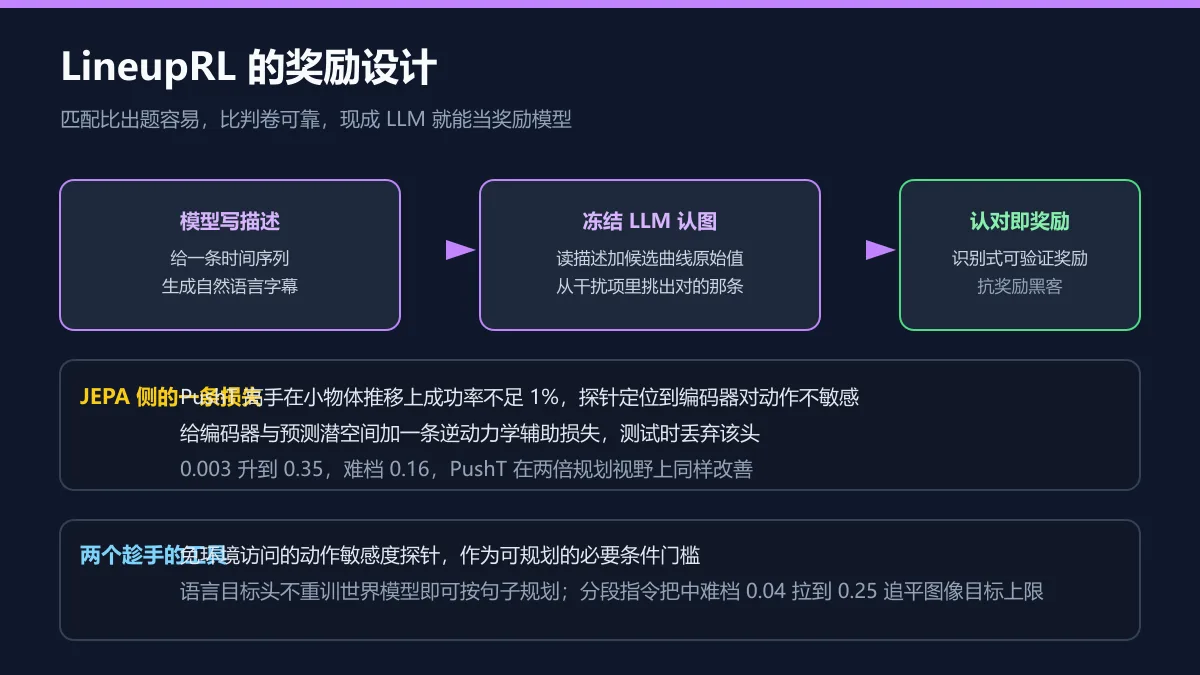
Florian Strohm 等人的工作(arXiv:2610.03137)建了个 SLIM 推移基准:同场景下多个小物体,配视觉与语言双目标。结果令人清醒:在 PushT 上表现优异的 LeWM 世界模型,在这里成功率不足 1%。探针把病灶定位到编码器:它的潜表征几乎对动作不敏感,规划器自然无从规划。
药方只有一条:给编码器与预测潜空间加一个逆动力学辅助损失头,测试时直接丢弃。成功率从 0.003 拉到 0.35,难档 0.16,原 PushT 在两倍规划视野上也跟着改善。对照实验确认疗效来自梯度抵达编码器。附带两个实用工具:一个免环境访问的动作敏感度探针,可作为可规划性的必要条件门槛;一个小语言目标头,不重训世界模型就能按句子规划,分段指令把中难档从 0.04 拉到 0.25,追平图像目标上限。同样未见代码链接。
放在一起读
一篇证明奖励的问法决定上限,一篇证明表征的盲区可以一条损失修复。两篇的改动都小到可以在一个下午实验验证,这大概是它们对工程侧最大的鼓舞:在动架构之前,先找这种单点杠杆。