
字
字节笔记本
2026年11月5日 · 约 1 分钟读完
视频出画声音跟上,LiveFoley 把配音延迟压到 156 毫秒
API中转
¥120
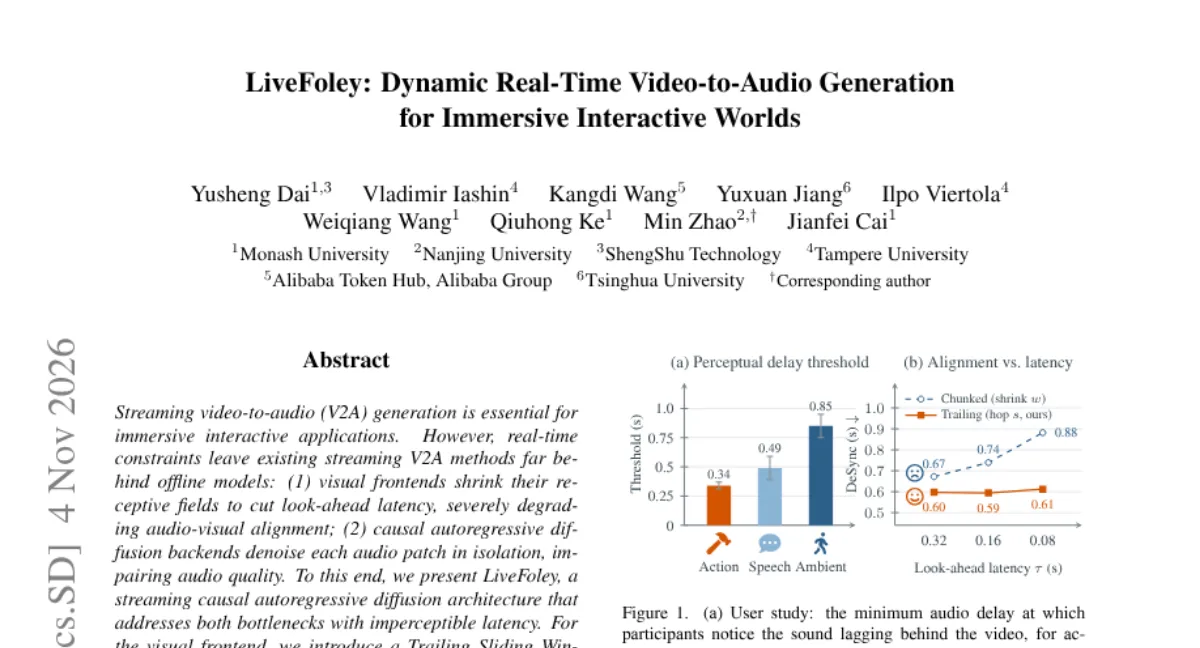
看无声视频时大脑会自动脑补音效,但机器一直做不好这件事的实时版:视频转音频(V2A)的流式生成落后离线模型一大截。论文 LiveFoley(arXiv 2611.05988)把落后归因于两个具体瓶颈,并各自给了修法,端到端延迟做到 156 毫秒,落在交互感知的 250 毫秒预算之内。
第一个瓶颈在视觉前端:为了压低前瞻延迟,感受野被缩得太小,音画对齐跟着遭殃。修法是尾随滑窗,把非因果的分段级编码器直接改成流式模块,不用重训练,靠窗口重对齐保住精确对齐。第二个瓶颈在音频后端:因果自回归扩散模型对每个音频片段孤立去噪,音质因此掉档。修法是统一的 Varhop 框架加 LocDiT 扩展:可配置的 hop 大小适配不同延迟与算力预算;History LocDiT 利用过去上下文、零延迟成本作为默认方案,Future-Warmup LocDiT 则用近似未来条件打破自回归死锁。
作者口径称其时序对齐「追平离线模型」,这个说法留待第三方复现,但架构思路已经足够清晰。定位上也聪明:它把自己做成解耦的、源无关的即插即用声音引擎,不绑定某个视频生成器,可直接接进 3D 游戏引擎、AR/VR 和实时摄像头画面。项目页与论文都已公开,页面未标注作者机构。
对做实时内容生成的团队,这篇和之前写的 LiveCC、流式视频 RL 是同一趋势的三块拼图:视频理解、视频配音都在实时化,直播、虚拟世界、具身智能的声音反馈从此有了可以逐帧挂载的引擎。下一步该轮到的是延迟预算的标准化,让不同模型能按同一口径报「我的声音比画面慢几毫秒」。
相关文章

分享: