字节笔记本
2026年10月5日 · 约 3 分钟读完
llama.cpp v0.6.0 发布:决策模型有了专属 API
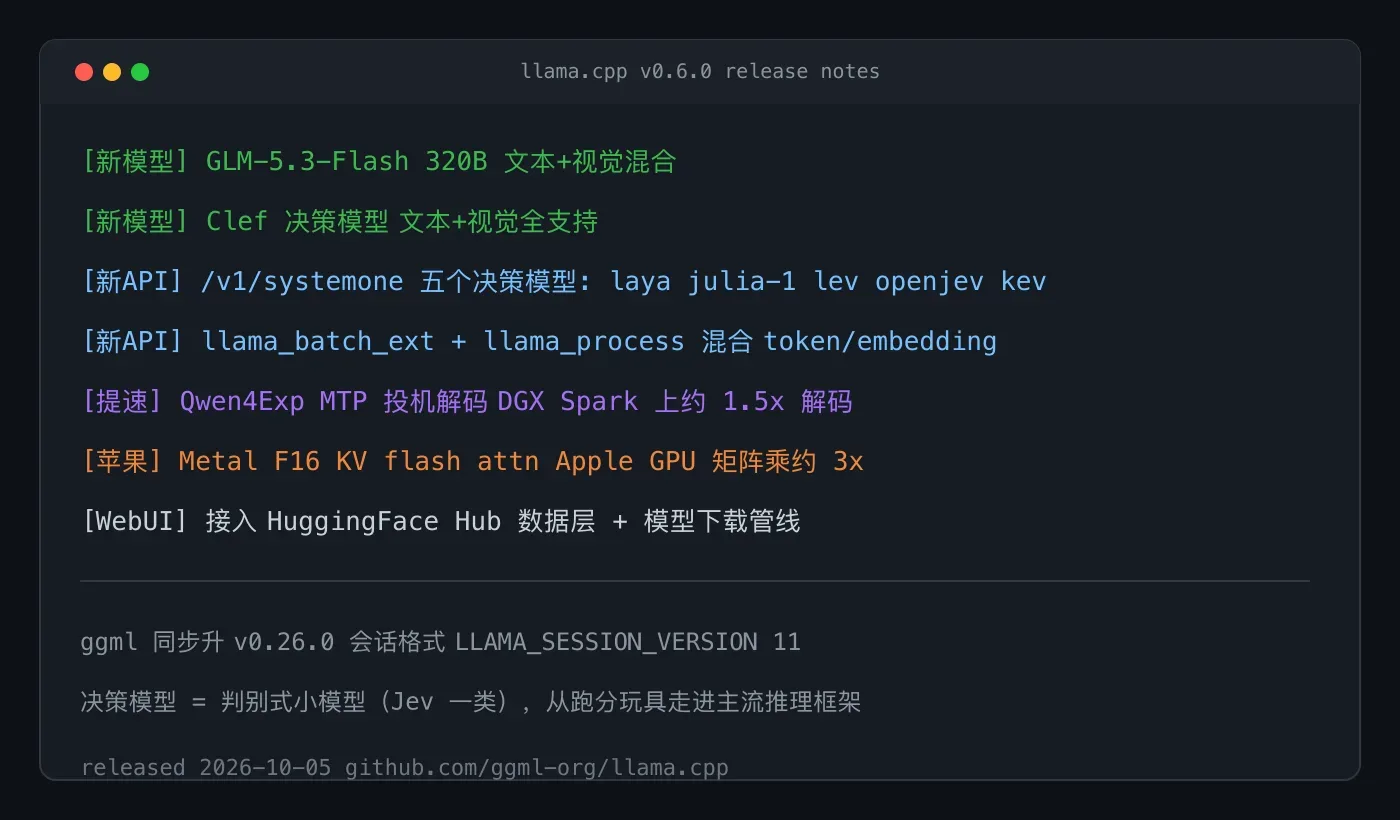
本地推理框架的每次大版本,都是本地部署玩家真实体感的更新。llama.cpp 昨天(10 月 5 日)发布 v0.6.0,一次塞进了新模型支持、新 API 形态和两条硬件路线的性能提升,其中最值得单独说的是:决策模型第一次在主流推理框架里有了自己的专属接口。
新模型:320B 混合模型上桌
**GLM-5.3-Flash(GLM5-Next)**获得支持,这是一个 320B 的文本加视觉混合模型,配合上一版引入的 MTP/deepstack 状态嵌入能力完整跑通;Clef 决策模型同样全支持,文本和视觉两条路都通。加上 Qwen4Exp 的高质量支持(MTP 投机解码在 DGX Spark 上实测约 1.5 倍解码提速,另有多个正确性修复),主流开源模型的跟进速度保持住了。
新 API:决策模型有了专属端点
/v1/systemone 是这版最有想象力的新增:一个专门服务决策模型的 server API,开箱支持 laya、julia-1、lev、openjev(带视觉)、kev 五个模型。
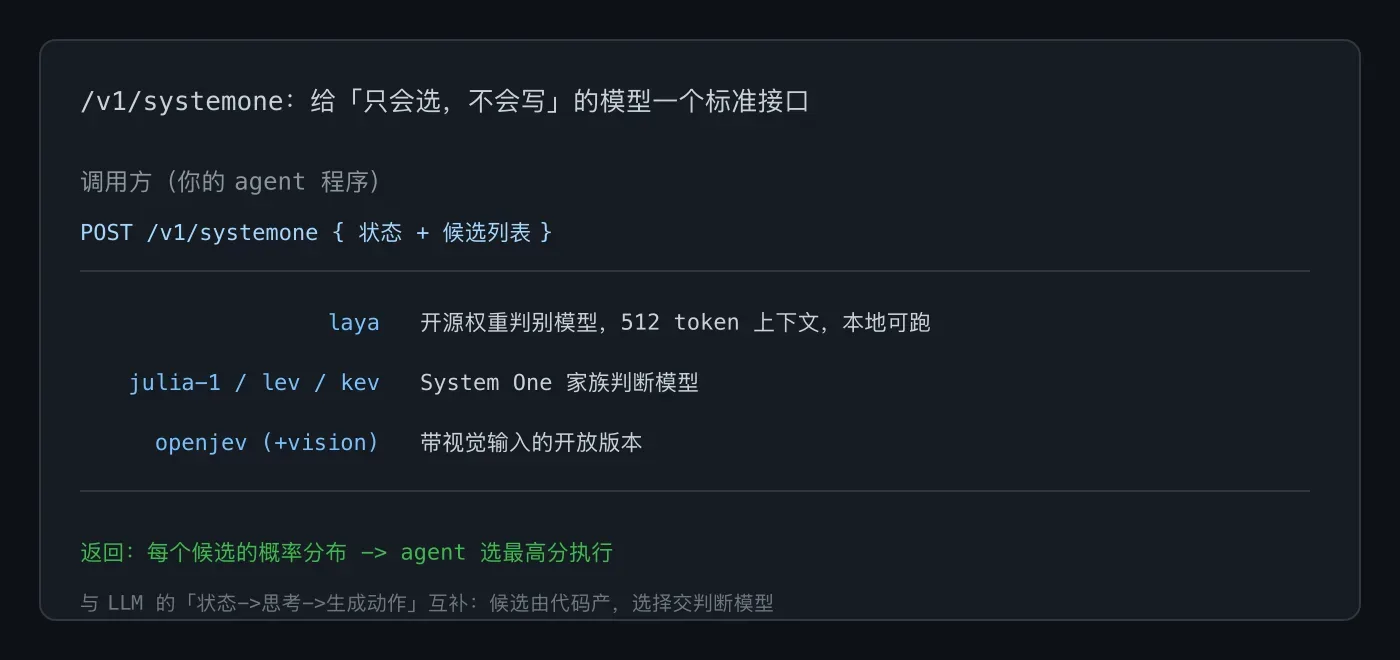
这类模型(System One 一族)不会生成文字,只会对给定的候选答案输出概率分布,此前要跑它们得自己搭环境拼协议。现在你的 agent 程序可以直接 POST 状态加候选列表,拿回每个候选的概率,选最高分执行。配合底层新增的 llama_batch_ext 扩展批量 API(支持 token 与 embedding 混合输入,正是为 MTP 和 deepstack 这类带状态嵌入的模型设计),「代码产候选、判断模型做排序、程序去执行」这套三段式架构,第一次在本地推理框架里有了一等公民的通路。
两条硬件线都在涨
Apple 路线:Metal 新增 F16 KV 的 tensor API flash attention 内核,投机与批量解码的矩阵乘内核让 Apple GPU 上最快有约 3 倍的 mat-mul 提升。Vulkan 路线:量化 K/V 的稀疏 flash attention 上线。底座 ggml 同步升到 v0.26.0,会话格式升到 LLAMA_SESSION_VERSION 11(老会话文件需要重建)。
Web UI 也大改了一轮:接入 Hugging Face Hub 数据层和模型下载管线,拉模型不再需要手动拷 gguf 文件。
升级注意
批量 API 是破坏性变更,直接调 C 接口的集成方需要迁移到 llama_batch_ext;会话格式升级意味着旧 session/state 文件不通用;新模型的显存门槛照旧按参数量算,320B 混合模型对消费级硬件依然是云端或多卡专属。
为什么值得盯
决策模型走进主流推理框架,是个信号:agent 架构里「LLM 产候选、小判断模型快速排序」的分工(此前我们写过 Jev 打俄罗斯方块的 demo)正在被基础设施层接纳。当你能在本地 llama.cpp 里直接挂一个判断模型给主 agent 做路由和审批,这类三段式管线就成了普通玩家也能搭的标准件。升级命令照旧:拉取最新源码重新编译即可,模型支持明细见仓库 release。