字节笔记本
2026年10月5日 · 约 2 分钟读完
递归才是外挂:RLM 作者谈 harness 的本质
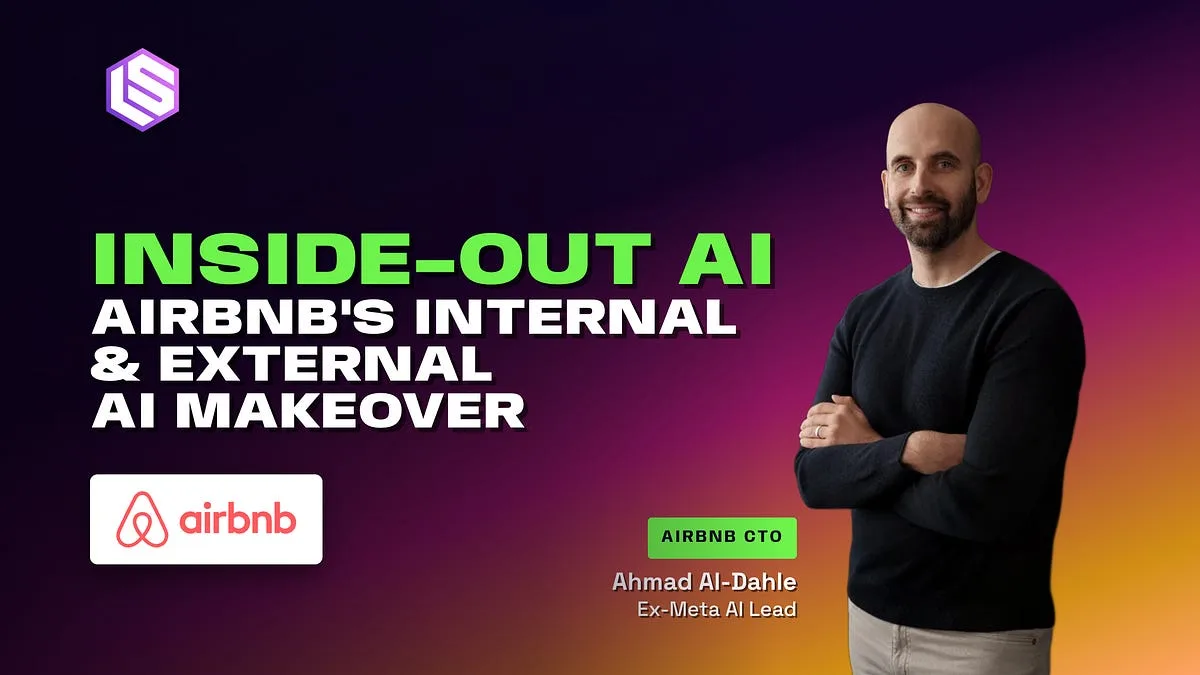
harness 到底是什么?递归语言模型 RLM 论文的第一作者、MIT 博士生 Alex Zhang 做客 Latent Space 播客,给出了一份难得的第一视角拆解。这篇访谈信息密度极高,值得做工程的同学细读。
RLM 的核心抽象
在 RLM 里,harness 中唯一的工具是代码。模型可以把自己当工具递归调用,上下文不再追加在提示词后面,而是存进代码环境里的记忆(比如文件系统)。Prime Agent 把这套抽象落在了 Pi Mono 上。
由此带来一个漂亮的性质,作者称之为组合泛化器:在短任务上训练的 RLM,直接泛化到八到三十倍长的任务。原因是高层解题策略可以迁移,子代理看到的问题各不相同,但整体程序结构是一样的,而且这个论证可以沿递归层级归纳上去。
harness 们其实长得一样
访谈里最扎眼的判断:Claude Code、Codex 与 Pi 在结构上几乎相同,本质都是轨迹当提示词的循环。对强模型而言差别只剩成本;更好的模型完全可以在一个简单前端后面藏一支蜂群或脚手架。
说到蜂群,他算了 OpenAI 那次万级 agent 实验的账:一万个 agent 跑八十八小时,一千三百亿输出 token,约合四千万美元。他的评价很直接,比想象中便宜,但其中约 95% 的 token 是无用功;真正难且令人佩服的是收敛到答案的过程,而 Kimi 的蜂群与动态工作流正是在收敛上掉了队。
几条工程与生态的注脚
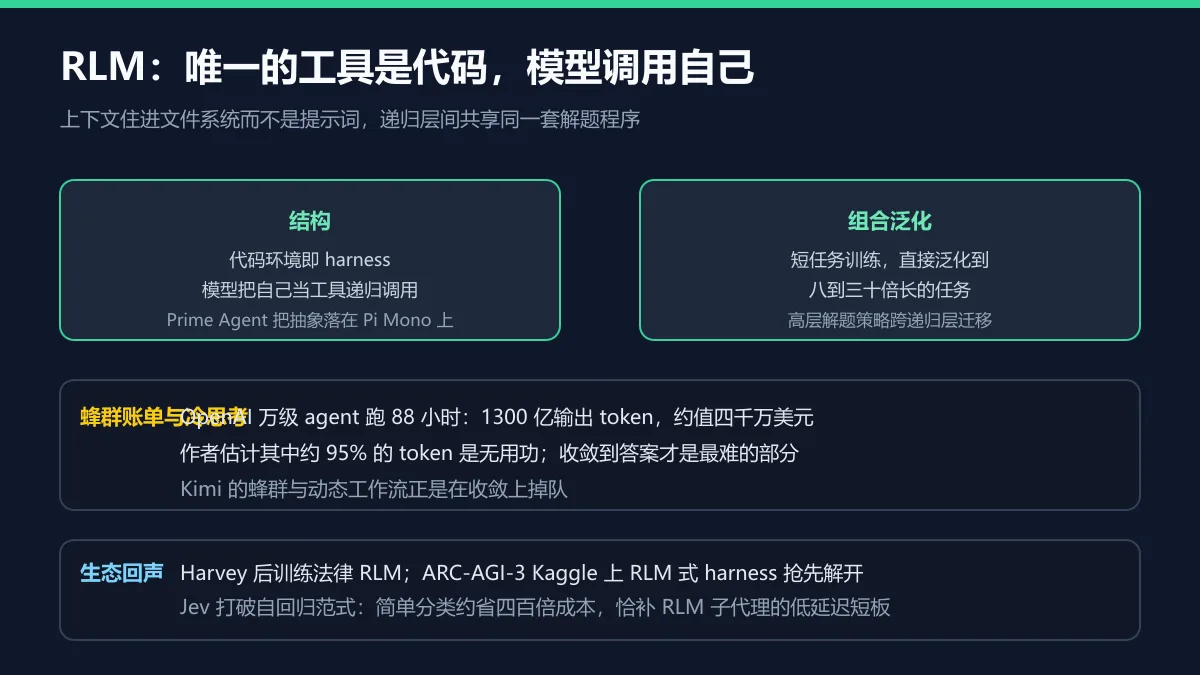
三条注脚都很实用。第一,GPU Mode 排行榜上几乎全部内核都由 AI 生成,但前十名里只有专家 Gauners 的方案在真实端到端系统里稳定,一个懂行的验证者能省掉海量暴力 token。第二,Jev 证明语言模型不必是自回归文本解码器,换掉输出空间后简单分类任务约省四百倍成本,恰好补上 RLM 子代理调用的低延迟短板,这与站内写过的 Cloudflare Clef 三件套互为印证。第三,生态已在跟进:Harvey 为法律工作后训练了 RLM,ARC-AGI-3 的 Kaggle 竞赛里 RLM 式 harness 抢在 OpenAI Astra 之前接近解开赛题。
访谈最后聊到研究品味:SWE-bench、ReAct、Quiet-STaR 与 RLM,当初都被认为琐碎、奇怪或无意义。学术界的价值恰在于可以下这种不必向算力交代的大注。