字节笔记本
2026年10月4日 · 约 4 分钟读完
美团把 13.6B 视频模型开源了:MIT 协议随便用
视频生成模型的开源阵营里又多了一个能打的选手,而且这次是国内公司。美团 LongCat 团队的 LongCat-Video 今天出现在 GitHub Trending 榜上,8.8k stars,代码和模型权重都按 MIT 协议开源,商用不设门槛。它是一个 13.6B 参数的视频生成基础模型,文生视频、图生视频、视频续帧三种模式统一在一个架构里,官方口径可以在几分钟内产出 720p、30fps 的视频。
项目简介
LongCat-Video 的产品线是一条时间线推进出来的:主模型 2025 年 10 月首发,2025 年 12 月追加音频驱动数字人分支 LongCat-Video-Avatar,2026 年 5 月升级到 Avatar-1.5 并发布了技术报告。权重同时托管在 Hugging Face 与 ModelScope,国内下载不用绕路。
技术上有两个值得记的点。一是生成策略采用由粗到细的两段式,先定大结构再补细节,配合 Block Sparse Attention 控制算力开销,这是它能声称分钟级出片的基础。二是训练后阶段用了多奖励 GRPO 的强化学习对齐,官方把它当作画质与指令遵循的保障。
核心功能
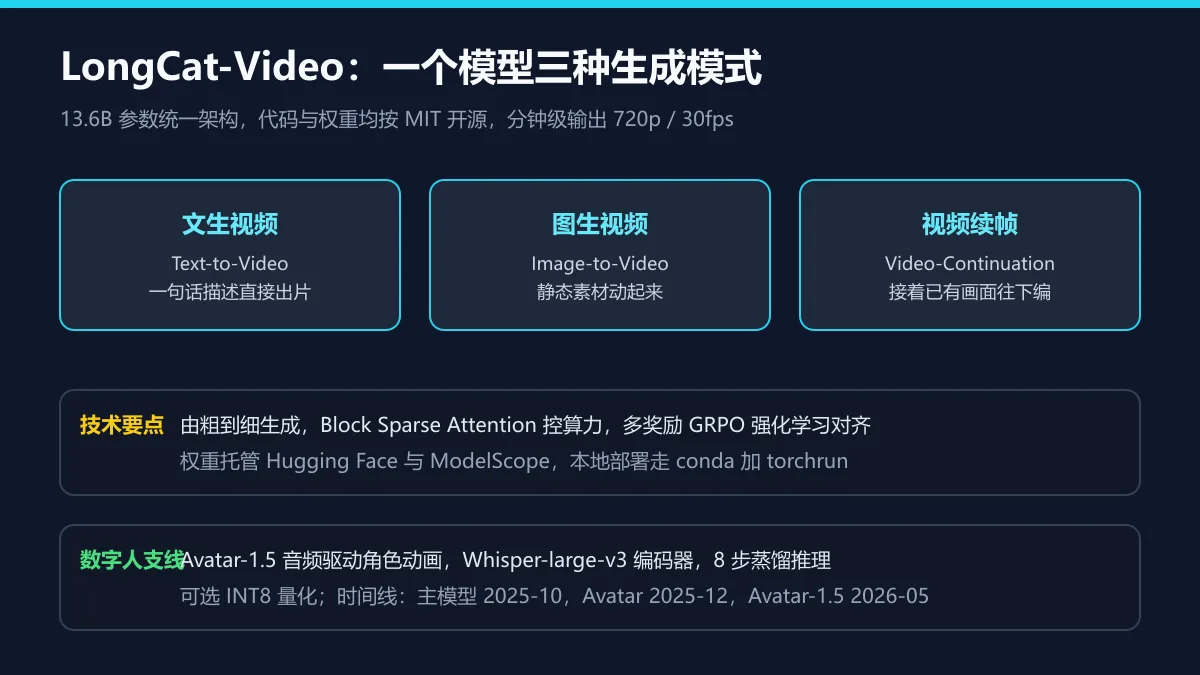
- 文生视频:一句话描述直接出片,适合从零起稿的创意场景。
- 图生视频:把静态素材动起来,产品图、插画、实拍照片都能喂。
- 视频续帧:接着已有画面往下编,做续集、延长镜头、补素材尾部都顺手。
- 数字人支线:Avatar 系列做音频驱动的角色动画,1.5 版换装 Whisper-large-v3 编码器,支持 8 步蒸馏推理与 INT8 量化,显存压力显著低于原始模型。
快速上手
本地部署走 conda 加 torchrun 的标准路线,依赖 Python 3.10、torch 2.6.0 与 flash_attn 2.7.4:
git clone --single-branch --branch main https://github.com/meituan-longcat/LongCat-Video
conda create -n longcat-video python=3.10
pip install -r requirements.txt

huggingface-cli download meituan-longcat/LongCat-Video --local-dir ./weights/LongCat-Video
torchrun run_demo_text_to_video.py --checkpoint_dir=./weights/LongCat-Video --enable_compile
跑数字人用 Avatar-1.5 的脚本,双卡加蒸馏与 INT8:
torchrun --nproc_per_node=2 run_demo_avatar_single_audio_to_video.py \
  --checkpoint_dir=./weights/LongCat-Video-Avatar-1.5 \
  --stage_1=at2v --use_distill --model_type avatar-v1.5 --use_int8
仓库还自带 Streamlit 界面,跑 run_streamlit.py 可以在浏览器里试模型,不想读命令行的同学有退路。
适合谁用
做短视频与营销物料的中小团队是第一受众:MIT 协议意味着可以自由商用、二改、蒸馏,不必谈授权。有本地算力的开发者可以拿它替代按次付费的闭源视频 API,13.6B 的参数量在单机多卡上属于够得着的档位。做数字人直播、播客视频化的团队则可以直接考察 Avatar-1.5 的蒸馏与量化配置。需要注意的是,主模型发布至今已一年,社区生态与第三方兼容工具的积累情况,建议先在 demo 里验证画质再决定是否迁移工作流。