字节笔记本
2026年10月5日 · 约 18 分钟读完
Loop Library:让 AI 自己发现你的重复劳动
你有没有过这种体会:用 AI 编程工具时,反复在做同样的事,修生产环境的报错、补文档、加测试、优化某个慢页面……每次都是临时起意,prompt 从头写,结论丢了又重来。
项目背后的 Forward Future 团队最近在 X 上重点介绍了它的新功能,专门解决这个问题。核心想法一句话能说清:把一次性的 prompt,升级成带反馈的"循环"(loop)。
更狠的是,新出的 Lazy Loops 功能会自动翻你的代码库和聊天记录,找出你重复在干的活,直接帮你设计成可复用的 loop。
这个项目叫 Loop Library,仓库 Forward-Future/loop-library。今天就来拆它。
一、先搞懂:什么是 loop?
很多人第一次接触这个概念会懵:loop 是循环?for 循环?事件循环?都不是。
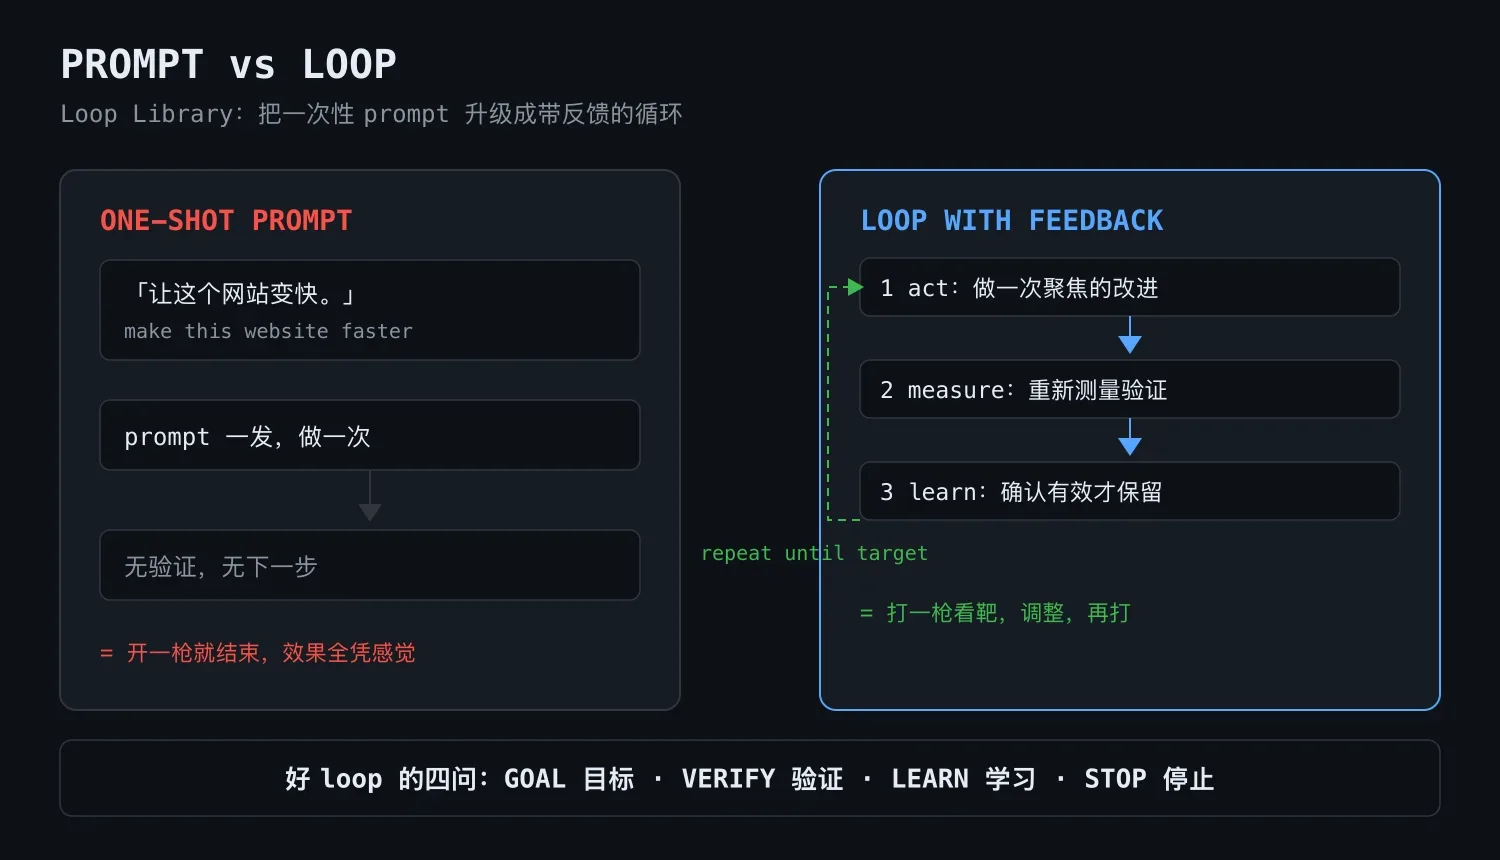
这里的 loop,指的是一种带反馈的 AI 工作剧本。普通的 prompt 让 agent 做一件事一次;loop 则让 agent 从结果里学习,再决定下一步。
举个 README 里的对比例子,一目了然:
普通 prompt(一次性):
让这个网站变快。
loop(带反馈):
找到最慢的页面,做一个聚焦的改进,然后重新测量。只有确认有帮助才保留这个改动。重复这个过程,直到每个页面都达标,或者再改一轮已经没有明显提升。
看出区别了吗?普通 prompt 是"开一枪",loop 是"打一枪看看靶,调整,再打"。
用作者的话说:
把 loop 想成一个内置了反馈的 playbook。当第一次尝试大概率不是最终答案时它才有用,比如修生产错误、提升测试覆盖率、做产品评审、让文档保持最新。
一个好的 loop 要回答四个问题
Loop Library 给的标准很简洁。一个好的 loop 必须说清:
- 目标:agent 想完成什么?
- 验证:它怎么知道最新一次尝试成功了?
- 学习:它该拿学到的怎么办?
- 停止:什么时候该结束,或者求助?
这四问是整个体系的灵魂。后面所有功能都围绕它们展开。
二、为什么 loop 比 prompt 强
AI agent 动得很快,但一个开放式指令("持续优化这个")给它留了太多猜测空间。loop 做的事,是给工作一条清晰的终点线和一致的判断标准。
这让工作变得更容易信任、也更容易重复:
- agent 可以对比结果,而不是靠"感觉对了"
- 保留真正有效的改进,而不只是"做了改动"
- 成功或停滞时主动停下
- 同一个 loop 可以被另一个人或另一个 agent 直接复用,不用从头搭工作流
但作者很清醒地强调了一句:
Loops 不是允许 agent 无限跑下去的许可。最好的 loop 是刻意设了边界的,包含真实的检查、清晰的停止点,以及需要判断或批准时把控制权交还给人的时刻。
这一点特别重要。很多 AI 自动化的翻车,就是因为没有"该停就停"的机制。
三、Loop Library 的两部分
仓库里其实有两样东西,别搞混:
| 部分 | 是什么 | 在哪 |
|---|---|---|
| Loop Library 网站 | 公开目录,任何人/任何 agent 都能浏览已发布的 loop、阅读、复制 prompt。无需安装。 | 在线网站 + site/、worker/ 目录 |
| Loopy skill | 可选的安装式向导,帮 AI agent 发现、查找、审计、修复、定制、运行、复盘、发布 loop。 | skills/loopy/ 目录 |
一句话:网站是图书馆,Loopy 是和图书馆打交道的引导员。 你可以只逛网站不装 Loopy;装了 Loopy 才有那套引导式工作流。
有意思的是,没装 Loopy 的 agent 也能直接用。Loop Library 提供了四种公开格式让任何 agent 接入:
- agent 指南页(网页)
- agent 指令文件(
llms.txt) - JSON 目录(
catalog.json) - 纯文本目录(
catalog.txt)
也就是说,这是个对机器友好的开放目录,不绑定特定工具。
四、Lazy Loops:让 AI 替你发现重复劳动
这是官方重点介绍的新功能,正式名叫 Discover(发现),俗称 Lazy Loops(懒惰循环)。
它的逻辑很直接:
Discover 会翻遍你的代码库和聊天记录,找出你潜在在重复做的事,然后直接帮你设计成 loop。
具体怎么做?从源码里的 discover.md 工作流能看到完整流程,分三步:
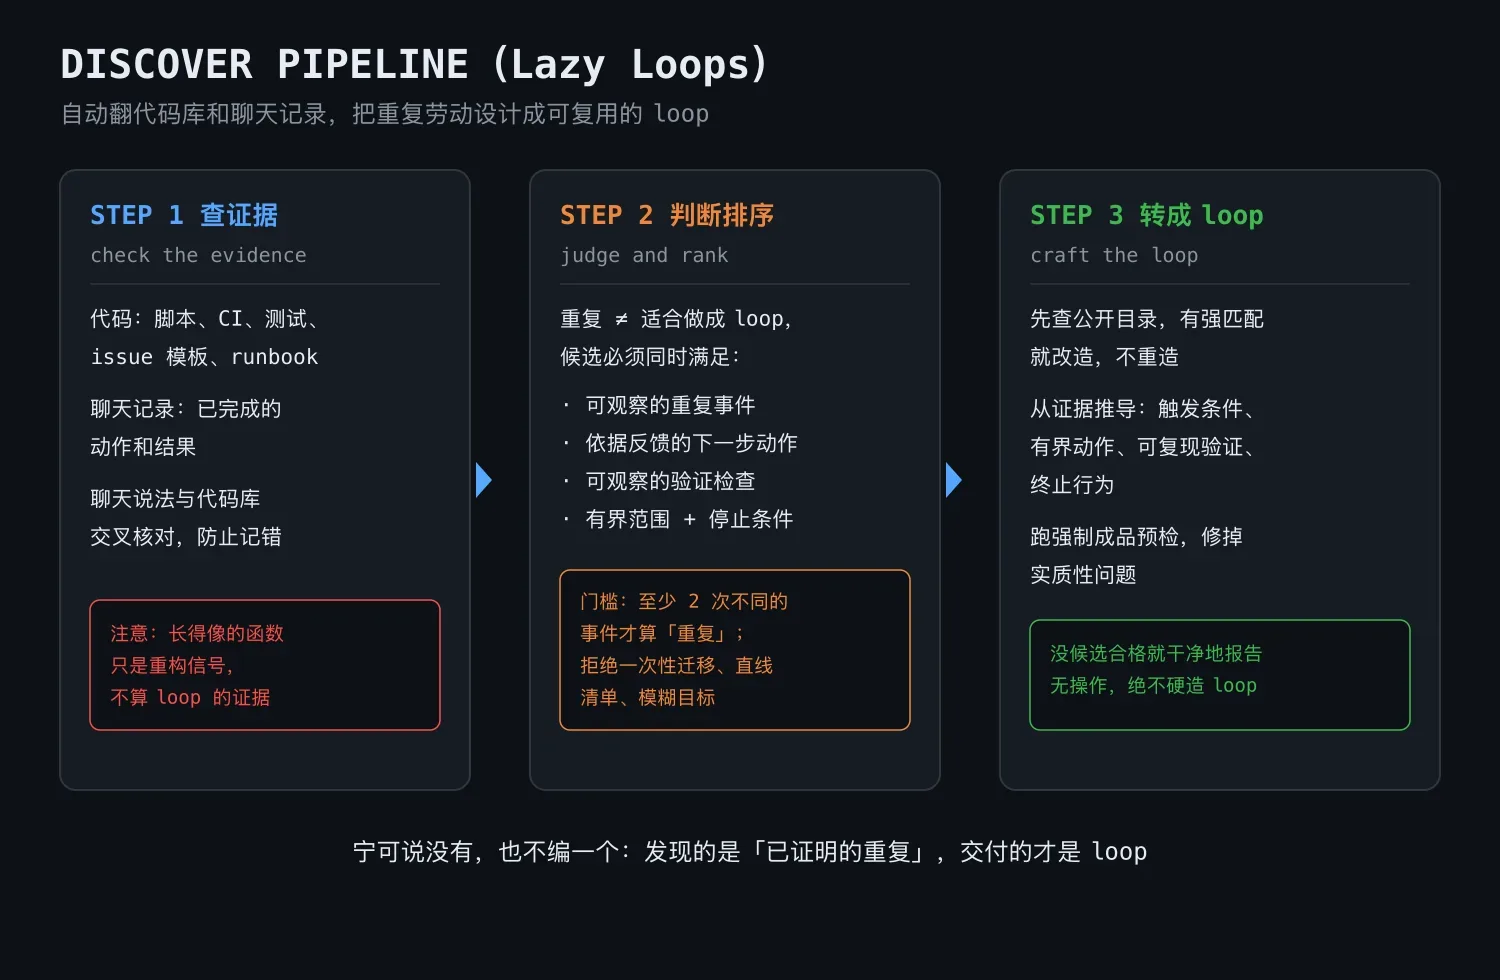
第 1 步:检查证据
它只看你授权范围内的东西:
- 代码里:脚本、CI/部署配置、维护命令、测试、issue 模板、runbook、重复的生命周期模式。注意,"长得像的函数"只是重构信号,不算 loop 的证据。
- 聊天记录里:找出已完成的动作和结果。即使措辞不同,语义等价的工作会被归成一类。数的是"不同的事件发生次数",而不是"同一个事件被讨论了几遍"。
- 交叉验证:聊天记录里的说法,会尽量和代码库/运行时核对,因为聊天记录可能过时、残缺或记错。
第 2 步:判断和排序候选
这是最讲究的一步。"重复"不等于"适合做成 loop"。一个候选要被认可为"loop 形状",必须同时满足:
- 有可观察的重复事件或状态
- 有能根据新反馈调整的下一步动作
- 有判断动作是否有效的可观察检查
- 有有界的范围和合适的停止条件(成功 / 无操作 / 受阻 / 需批准 / 无进展)
而且有严格的重复证据门槛:
聊天记录里,至少要有两次不同的事件发生才能叫"重复"。只有代码模式、没有运行历史的,只能叫"潜在 loop",不能叫"已证明的重复"。
还会主动拒绝这几种:一次性迁移、直线型清单、模糊目标、再跑一轮也拿不到新证据的任务。
第 3 步:把最佳候选转成 loop
- 先查公开目录,有现成的强匹配就改造而不是重造
- 候选势均力敌时,给个排序清单让你选
- 从证据里推导出触发条件、新鲜观察、有界动作、可复现验证、记录方式、终止行为
- 跑一遍强制的"成品预检",修掉实质性问题
- 交付时标注是"未发布设计"还是"改造"。如果没候选合格,就干净地报告"无操作",绝不硬造一个 loop
这个"宁可说没有,也不编一个"的态度,是这个项目最让人放心的地方。
五、Loopy 的八条路径
装了 Loopy 之后,它能走八条路。不需要记术语,说人话描述需求就行:
| 路径 | 干什么 | 示例说法 |
|---|---|---|
| Discover 发现 | 扫代码库/聊天记录找重复工作,转成 loop | "分析这个仓库和我聊天记录里重复干的事,把最好的候选做成 loop" |
| Find 查找 | 搜公开目录,推荐最多 3 个已发布 loop(不运行) | "找个保持文档最新的 loop" |
| Loop Doctor 体检 | 审计你贴的 loop,修掉实质性问题 | "审计这个 loop 并只修实质问题:[贴 loop]" |
| Adapt 适配 | 把现成 loop 改成你的工具、限制、成功标准 | "把'夜间文档清扫'适配到这个仓库和我们现有的检查" |
| Craft 定制 | 一次问一个问题地访谈你,从零造一个 loop | "访谈我,帮我造个把客户反馈变成已验证修复的 loop" |
| Run 运行 | 有界地跑 loop,返回带证据的回执 | "在这个仓库里跑'夜间文档清扫'" |
| Debrief 复盘 | 分析跑完的回执,推荐最小的改进 | "复盘这个回执,告诉我要不要改 loop" |
| Publish 发布 | 查质量和重复度,批准后才提交到 Loop Library | "准备把这个 loop 发布到 Loop Library" |
每条路都有清晰的边界。比如 Run 明确说:
运行 loop 只授权"普通、可逆、明显在范围内的动作"。它不授权排程、改生产、破坏性操作、购买、隐私敏感访问或外部消息。
这种"把权限讲死"的设计,是给生产环境用的底气。
六、85 个已发布 loop 长什么样
光说不练假把式。Loop Library 网站上现在挂着 85 个公开发布的 loop(发文前核验目录所得),覆盖工程、内容、评估、运营、设计等类别。挑几个有代表性的感受下:
工程类(主力)
001 · 文档清扫(The docs sweep)
触发:实现有改动可能让文档落后时 Prompt:需要文档 pass 时,全面 review 代码库,确保所有文档反映当前实现。更新过期文档,验证改动,然后开 PR。
003 · 50ms 页面加载 loop(The sub-50 ms page-load loop)
Prompt:持续优化代码速度。每次重大改动后,在相同可重复测试条件下测量所有页面的加载性能。重复直到每个页面都在 50ms 内加载完成。
004 · 生产错误清扫(The production error sweep)
Prompt:review 生产日志找错误。发现可操作的问题就追溯到根因、修复、验证、开 PR。没有可操作错误就停手,不做任何改动。
005 · 100% 测试覆盖率 loop
Prompt:加测试直到我们有 100% 测试覆盖率。 验证:完整测试套件以 100% 覆盖率通过。
注意这几个的共同点:每条都有明确的 Prompt + 验证标准,不是"尽力而为"的模糊指令。
内容类
006 · SEO/GEO 可见性 loop:跑技术爬虫和搜索可见性检查,按预期影响排 Gap,修最高杠杆的问题,再重跑同样的爬虫和基准测试,直到没有高影响 Gap 剩下。
018 · 产品更新播客 loop:把产品更新自动转成播客内容。
026 · 无限标题党缩略图 loop(Infinite Clickbait thumbnail):持续生成和测试 YouTube 缩略图。
评估类
009 · 质量连胜 loop(quality streak):测真实场景,挂了就记录、加回归测试和基准覆盖、修复、重启连胜。连续过 N 个才停。失败的每一次都永久地改进测试和基准套件。
010 · 全产品评估 loop:穷举式端到端 QA:盘点每个面向用户的功能、角色、路由、按钮、输入框、模态框、状态、工作流,定义验收标准,像真实用户一样测,记录每个 bug 带复现证据。
一些有意思的
- 023 · 自我提升冠军 loop:让 AI 自己和自己的历史版本对打
- 027 · builder-reviewer 双角色 loop:一个 agent 写,一个 agent 审
- 042 · Axelrod 子代理竞技场:多 agent 博弈
- 070 · 文献检索验证 loop:验证 AI 做的文献检索是不是真有那些论文
这 85 个 loop 本身就是一个绝佳的学习样本:看别人怎么把模糊工作拆成有界的、可验证的、会停止的循环。
七、怎么装、怎么用
安装(三选一或全装)
# Codex
npx skills add Forward-Future/loop-library --skill loopy --agent codex -g -y

# Cursor
npx skills add Forward-Future/loop-library --skill loopy --agent cursor -g -y

# Claude Code
npx skills add Forward-Future/loop-library --skill loopy --agent claude-code -g -y一行命令搞定。-g 是全局可用,-y 是跳过交互确认。
调用
不同平台略有差异:
- Codex:输
/skills,选 Loopy,再输请求;或直接$loopy 你的需求 - Cursor:Agent 聊天里输
/,搜loopy,选中再加请求;或直接/loopy - Claude Code:
/loopy 你的请求
一个真实例子
想让 Loopy 发现你代码里的重复工作,在 Codex 里这么写:
$loopy 分析这个代码库和我的聊天记录里的重复工作,然后把最强的候选变成可靠的 loop。
它会自己去找、去判断、去设计,最后给你一个能直接用的 prompt。
八、背后的技术细节(给爱钻研的)
Loop Library 的架构其实挺现代:
- 网站:静态站点(
site/),但 loop 数据存在 Cloudflare Worker 后端的 SQLite Durable Object 里,不进 Git - 发布流程:用
npm run loop:publish写一次数据库,同时生成首页、详情页、JSON/MD/纯文本目录、feed、sitemap,一次写入,多格式输出 - 版本管理:每次发布都有只追加的修订历史,可以回滚
- 投票:读公开,但投票/改票/撤票需要 GitHub OAuth 登录,用 HMAC 签名 + 浏览器 nonce 的安全状态值
- Loopy skill:一个标准 SKILL.md(13KB)+ 五个 references 文档(discover/audit/run/debrief/publish),每条路径都指向对应的工作流文件
这种"数据库驱动、多格式导出、agent 友好"的设计,让 Loop Library 既能被人浏览,也能被任何 AI agent 直接消费,catalog.txt 那种纯文本目录就是给 agent 喂数据用的。
九、为什么这个项目值得你花时间
读完整个仓库和 85 个 loop,我认为 Loop Library 解决的是 AI 编程里一个被严重低估的问题:
大家都在研究"怎么让 AI 写更好的代码",但很少有人研究"怎么让 AI 的工作可复现、可信任、可传承"。
Loop 的价值恰恰在这三点:
- 可复现:同样的 loop,换个 agent 也能跑出类似结果,因为验证标准和停止条件写死了
- 可信任:"该停就停""该问就问""只做可逆动作",权限边界讲得很死
- 可传承:85 个公开发布的 loop,就是 85 个被验证过的工作方法论,任何人都能 fork
而 Lazy Loops(Discover)最妙的地方在于,它把"发现重复劳动"这个本来要人自己反思的活,外包给了 AI。你不用主动想"我每天在重复什么",让 AI 翻你的代码和聊天记录,它比你更清楚。
这大概就是官方给这个功能取名 Lazy 的双关含义:不是偷懒,而是让 AI 替你看见你自己看不见的重复。
十、怎么拿
- 仓库:
github.com/Forward-Future/loop-library - 网站:
signals.forwardfuture.com/loop-library/ - 纯文本目录(agent 友好):
signals.forwardfuture.com/loop-library/catalog.txt - JSON 目录:
signals.forwardfuture.com/loop-library/catalog.json - 协议:MIT License,Forward Future 出品
不需要装任何东西就能逛网站、复制 85 个现成 loop 的 prompt。想让 AI 帮你发现和定制,再装 Loopy skill。
一句话总结:prompt 让 AI 做一次,loop 让 AI 做对、做好、还能再来一次。
本文基于 Forward Future 的 Loop Library 项目(仓库 Forward-Future/loop-library)整理,线上目录经核验共 85 个已发布 loop。在循环工作流这个方向上,社区还有盘问式工作流设计、循环工程方法论等相近探索,思路可以互相印证。