
字
字节笔记本
2026年11月7日 · 约 2 分钟读完
别再塞长上下文了:斯坦福用 16 个记忆 token 装下文档库
API中转
¥120
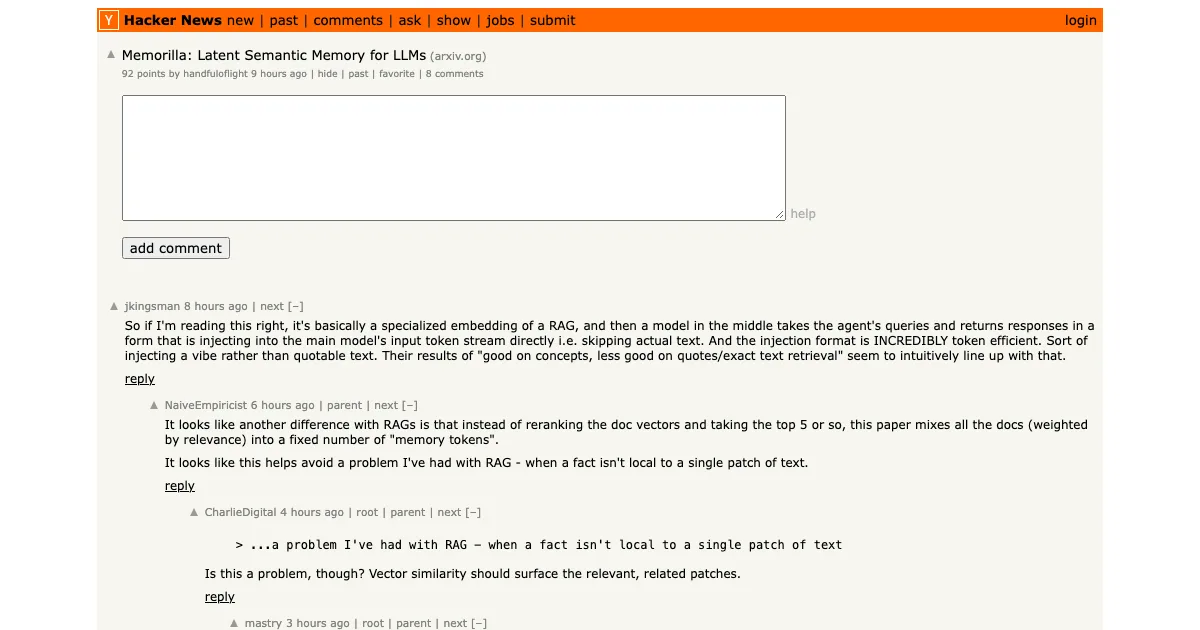
长上下文的成本问题有个新答案:别把整个文档库塞进上下文,把它压进 16 个"记忆 token"。斯坦福团队(Jure Leskovec 组)的 Memorilla 论文(arXiv:2610.21375,2026 年 10 月 15 日提交、11 月 3 日 v3)在 HN 上拿到 92 分(2026-11-07 快照),项目页在 memory.stanford.edu。
它做什么(论文口径)
Memorilla 是给冻结 LLM(不动权重)配的记忆系统:把整个文档集合(用户聊天记录、书籍章节等)一次性编码成可复用的嵌入,然后按查询需要,把 query 相关的信息取出来、直接注入 LLM 的输入嵌入空间——形式上是固定数量的查询相关"记忆 token"(论文里只用了 16 个),替代把全文塞进上下文窗口的做法。
三个卖点:① 记忆体积固定——16 个 token,不随文档库变大而膨胀;② 模型冻结即可用,不改权重;③ 支持 agent 的持续学习——轨迹越跑越长、文档越积越多,记忆照样装得下。
数字(论文口径)
- 8 个基准(个性化、长文档、知识密集型 QA 等)里 5 个拿下最优,对比基线包括 Mem0 与 MemoRAG;
- FactKG:84.33% vs 全量上下文推理的 80.43%——准确率反超的同时,表示源文档只用了后者 1/108 的 token;
- TextWorld agent 任务:成功率从全量历史 in-context learning 的 18.6% 提到 24.2%,而且 agent 在已探索房间之间乱转得更少。
判断
对做 agent 记忆、RAG 变体的开发者,这篇的信号是"记忆的粒度可以比 chunk 更小":当别人还在优化"取哪段文本",Memorilla 直接在嵌入空间里学出一个压缩表征。三点校准:① 数字是论文自报口径,代码仓库页面未列出,第三方复现还没跟上;② 16 个 token 的容量上限意味着它装的是"压缩后的语义",不是全文可查——需要精确引用原文的场景仍得回 RAG;③ 对比基线是 Mem0/MemoRAG 这类记忆方案,不是全量长上下文在所有任务上的通杀。
参考来源
相关文章
分享: