字节笔记本
2026年10月4日 · 约 3 分钟读完
小模型干不成活?两篇论文都说先查 harness
agent 项目跑不动,多数人的第一反应是换更大的模型。10 月 1 日提交到 arXiv 的两篇论文给出了一致的另一种答案:先查 harness 与评测配置,问题多半在那儿。
Mingbird:给小模型的本地优先 harness
第一篇来自 Hao Wang 与 Ting Huang(arXiv:2610.02001)。论文的出发点是观察:2 至 9B 的开源小模型放进为大模型设计的云端 harness 里,往往干不成真活,工具预填撑爆上下文、自我修正发散、工具演示循环、任务被静默放弃,这些锅是 harness 的,不是模型的。Mingbird 是一个面向 Windows 加 Ollama 的本地优先 harness,用十项机制对症下药:字节级的净零预填预算、完成任务前重读任务原文的收尾闸门、签名级循环检测等。
数字很直接:在作者自建的 LRAB 基准(4 个 harness、4 个模型、18 项任务)上,Mingbird 得分 0.886,goose 为 0.631,opencode 为 0.479,agent-mini 为 0.405;在 278 项任务的 tau 方基准上也拿到 0.856。作者对局限写得很诚实:自建基准、单机、单次计分,消融结果只作方向参考。代码、基准协议与评分脚本在 github.com/Mingbird/Mingbird-agent 开源。
Agents Are Systems, Not Models:评测该改口径了
第二篇来自 Luis Wiedmann、Leander Girrbach、Cordelia Schmid 与 Zeynep Akata(arXiv:2610.01618)。核心论点:agent 是可配置的系统,评测却常把它当固定模型。在四项需要 coding agent 查找并运行已发布专业模型的科研任务上,作者研究了五类配置(任务信息、推理、自验证、时间预算、骨干模型),结论条条扎心。
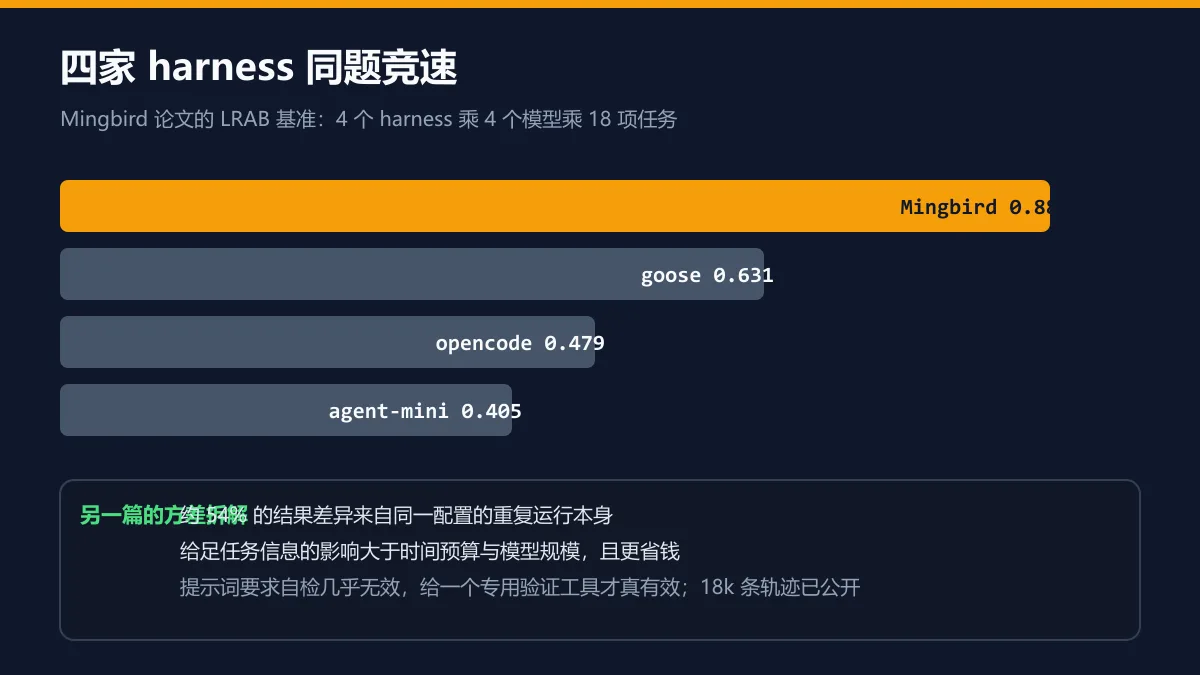
约 54% 的结果方差竟来自同一配置的重复运行本身,也就是说单次跑分说明不了什么;给足任务信息的影响大于时间预算与模型规模,还更省钱;配置之间会互相作用,额外时间只在信息充足或模型够强时才有用;最反直觉的一条是用提示词要求 agent 自检几乎不改变行为,给它一个专用验证工具才真的有效。作者随论文公开了基准与超过 18000 条 agent 轨迹。
放在一起读
两篇论文一个从工程、一个从评测指向同一件事:agent 的能力边界很大程度由 harness 设计与配置决定。下次小模型翻车,先别急着升模型档位,检查预填预算、循环检测、任务信息完整度与验证工具,可能一分钱不花就把问题解决了。