字节笔记本
2026年10月4日 · 约 2 分钟读完
挑技能该有尺子了:两篇 agent 论文的新解法
agent 技能生态这半年爆发式膨胀,一个现实问题跟着来了:技能越多,越不知道装哪个。10 月 1 日 arXiv 上的两篇论文分别给了技能选择与长任务执行两把新工具,都值得工程侧留意。
MCRI:给技能生态造一把尺子
第一篇是 MCRI(arXiv:2610.01506,Zongrui Yang 等人,cs.AI 与 cs.SE 双栏)。论文出发点很实际:agent 正从单工具系统走向模块化组合架构,技能成了能力分发的主要载体,但一直没有结构化的分析与评估框架。作者从信息增益与行为约束两个概念出发构建四维框架,并落地成基于大模型的 MCRI-Eval 评估方法。
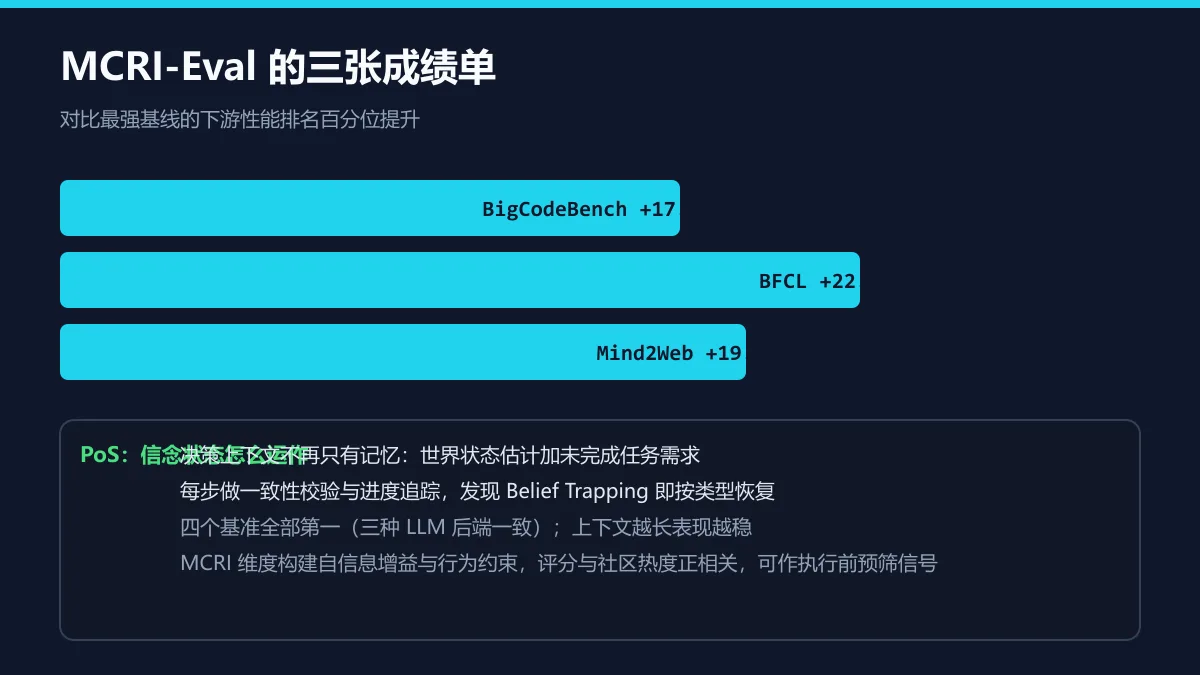
验证规模给得很足:从 OpenClaw 技能中心取了 63812 个公开技能,做 58275 次技能条件下的执行,横跨 BigCodeBench、BFCL 与 Mind2Web 三个基准。结果:MCRI-Eval 评分与社区热度信号正相关;对比各方法其下游排名一致性最高;用它预筛技能后,top-1 选择的下游性能排名比最强基线分别提升 17.7、22.8、19.6 个百分位。对运营技能市场的团队,这就是一个执行前就能用的排序信号,省下大量昂贵的实测成本。要注明:摘要页未见代码开源链接。
PoS:长任务别只靠记忆堆叠
第二篇是 Beyond Memory(arXiv:2610.01415,Yu Luo 等人)。它指出一个被忽视的问题:把交互历史组织成记忆,并不保证 agent 对当前世界有连贯认知。PoS 框架在推理时构建并持续维护显式信念状态作为决策上下文,每个信念状态由世界状态估计加未完成的任务需求组成,配合一致性校验与进度追踪。
最有意思的概念是 Belief Trapping:agent 持续行动却没有任何真实进展的卡死状态。PoS 能检测出这种状态,并按陷入模式与需求类型定制恢复策略。实验覆盖四个执行与诊断类基准,三种 LLM 后端下 PoS 全部拿下总排名第一,上下文规模测试中表现随规模增长依旧稳健。同样未见代码链接,跟进需等后续发布。
放在一起读
技能市场要可信,得先可评估;长任务要可靠,得先知道自己卡没卡。这两篇一个管入口(选对技能),一个管过程(守住信念),加上此前写过的 ClawScan 安全扫描,技能生态的质量基础设施正在被一篇篇补齐。