字节笔记本
2026年10月4日 · 约 2 分钟读完
别让判断模型干模拟的活:论文给出分工方案
判断模型(一次调用直接返回各选项概率、不写推理文本)正被越来越多的 agent 拿来做动作选择,Cloudflare 的 Clef 就是这一路线的产品化代表。10 月 1 日 arXiv 的一篇论文给这个路线划出了一条清晰的边界线,另一篇 RAG 综述则画了张地图。
Jev 的能与不能
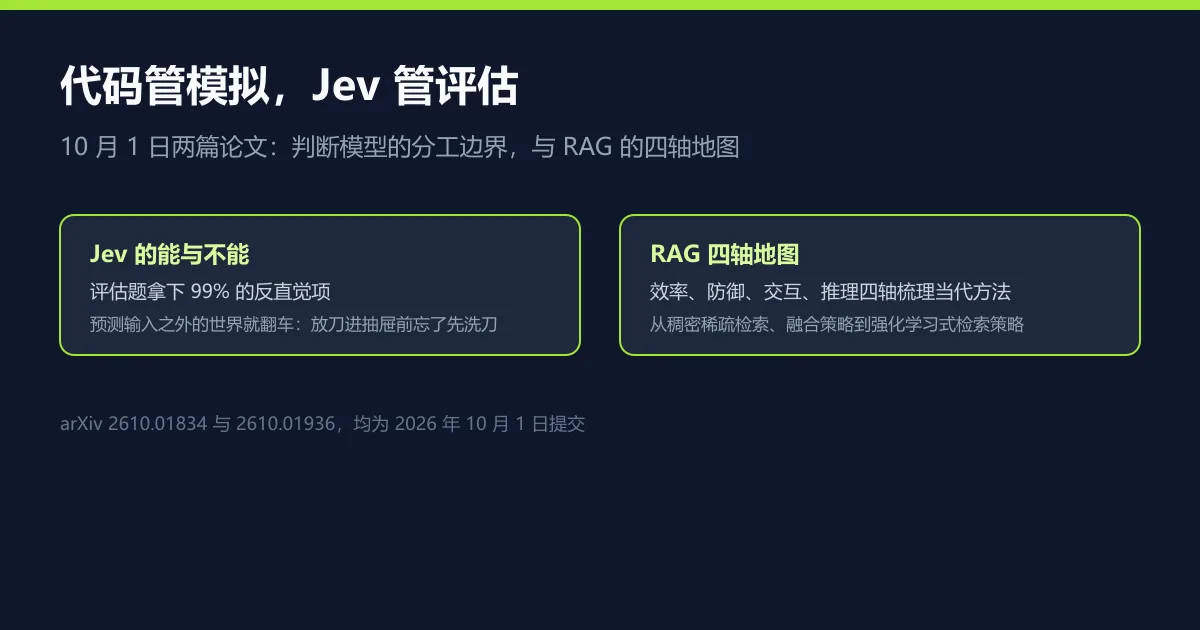
第一篇题为 Code Owns the Simulation, Jev Owns the Evaluation(arXiv:2610.01834,Yaodong Yang、Hongyao Tang、Yi Ma)。作者在反思测试、一次性矩阵博弈、ALFWorld 与机器人控制四类场景里测试 Jev 类判断模型,结论是它在评估上很强,从描述完的输入里挑出正确选项,反直觉的认知反射题能解出 99%;但在模拟上很弱,预测输入里没有的东西就不行了。
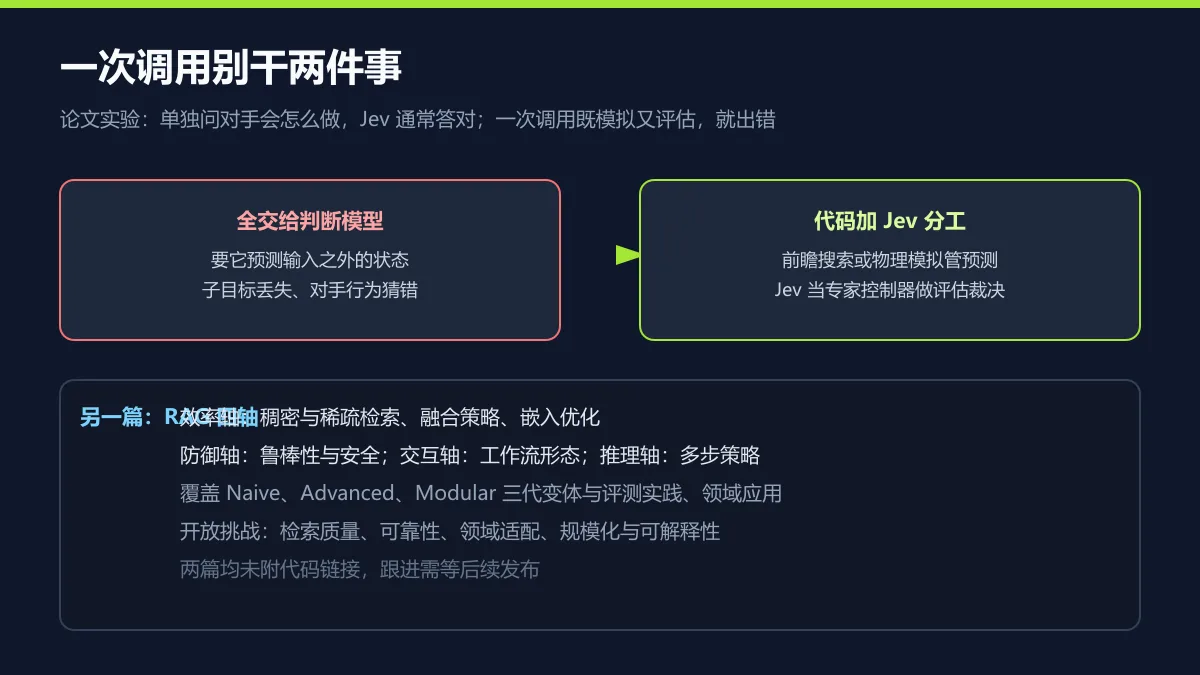
最典型的例子来自 ALFWorld:任务是「把干净的刀放进抽屉」,Jev 直接把刀放进去,跳过了先洗刀这个子目标。有意思的是,单独问它对手会怎么做,它通常答得对;失败只发生在一次调用要同时做模拟和评估的时候。作者的解法干脆:让代码管模拟(ALFWorld 里用前瞻搜索,机器人上用物理仿真),Jev 退回专家控制器的角色专心做评估裁决。对正在用 Clef 这类决策模型搭 agent 的工程团队,这条分工线可以直接抄作业。
RAG 的四轴地图
第二篇是 Mapping the RAG Landscape(arXiv:2610.01936,Meghana Sunil 等)。综述把当代 RAG 的发展整理成四条轴:检索效率(稠密与稀疏检索、融合策略、嵌入优化、强化学习式检索策略)、鲁棒性与安全、交互式工作流、多步推理。文中还形式化了 RAG 的核心组件,梳理了 Naive、Advanced、Modular 三代变体的演进,收尾列出检索质量、可靠性、领域适配、规模化与可解释性五个开放挑战。
放在一起读
一篇讲 agent 的决策层怎么分工,一篇讲检索层的全景谱系,恰好覆盖 agent 工程的两个地基。配合站内此前的 Clef 三件套解读与七周 RAG 课程,这两篇论文正好补上理论与地图那一块。两篇均未附代码链接,跟进请留意作者后续发布。