字节笔记本
2026年11月5日 · 约 2 分钟读完
多轮 RL 到底教会了 agent 什么?答案是兜底,不是更聪明
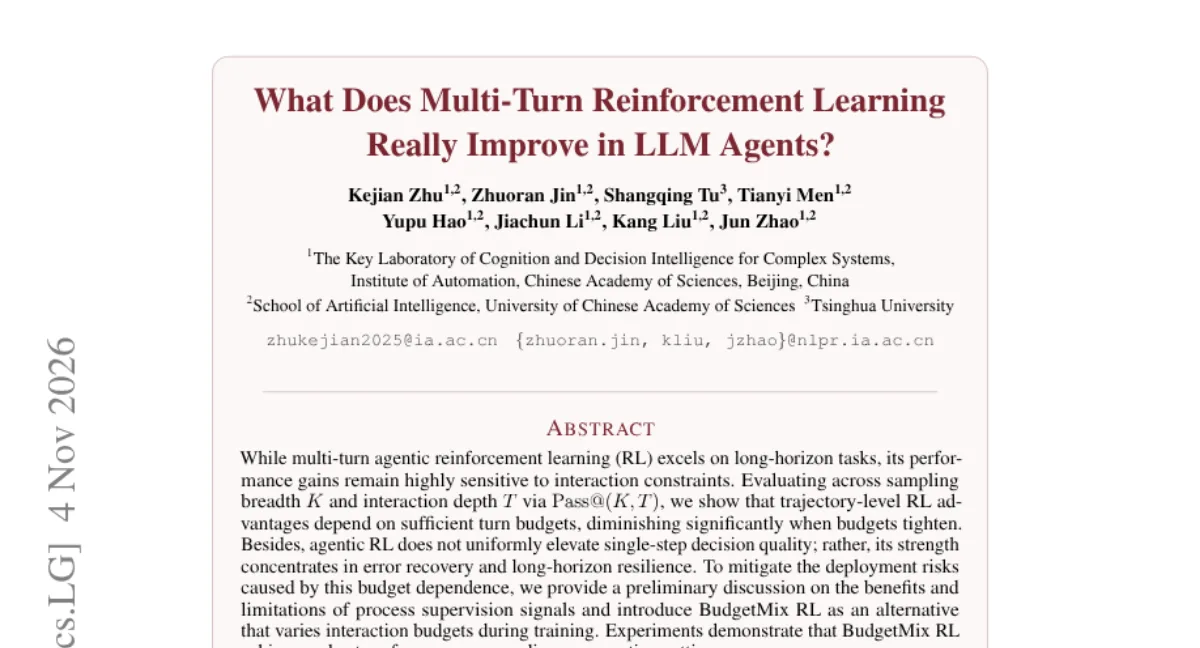
多轮强化学习(RL)已经成了训练 agent 的标配,但它到底把模型练好了什么?一篇登上 HF Daily Papers 的新研究(arXiv 2611.06483,摘要标注来自中科院自动化所团队)给出了一个反直觉的答案:练的主要是兜底能力,不是每一步都更聪明。
研究设计了二维指标 Pass@(K,T):K 管采样广度,即独立采多少条轨迹;T 管交互深度,即每条轨迹最多交互几轮。在 FrozenLake、DeepCoder-MT、BFCL、InterCode-SQL 四个交互基准(外加 Terminal-Bench 附加实验)上,用 Qwen3-4B/8B 做基座,跑 GRPO、GiGPO、PPO 三种算法。
三个发现值得逐条说。其一,采样广度拉满时 RL 持续超越基座,扩展了基座的经验能力边界,这与单轮任务里「RL 不扩展边界」的既有观察形成对照。其二,RL 的优势高度依赖交互预算:预算一收紧,优势缩小甚至反转,而且此时结构上界明明还有余量。其三,步级动作质量并没有普遍提升:DeepCoder-MT 上只有 46.8% 的匹配状态里 RL 选动作更优,FrozenLake 上只有 42.8%,某些场景甚至退化。
那增益从哪来?答案在错误恢复和长程韧性:处在错误状态时,RL 模型在 FrozenLake 和 DeepCoder-MT 上分别有 65.7% 和 67.3% 的情况选出更优动作。机制层面也很有意思,RL 生成的单步动作在基座策略眼里仍是「局部合理」的(NLL 约 12.20 对 10.25),但整条 RL 轨迹在 RL 策略下的累计对数似然比远高于基座轨迹(约 228 对 26):RL 学会的是把局部合理的动作可靠地串成长程轨迹。
对部署者的启示很直接:如果应用场景有严格交互预算或涉及不可逆操作,多轮 RL 带来的成功率提升可能兑现不了,评估也不能只看最终任务成功率。论文还给了个缓解方案 BudgetMix RL,训练时按区间随机采样交互预算,在 25%、50%、75% 预算下分别比全预算训练平均提升 7.5、5.3、4.0 个百分点,且不牺牲满预算性能。跑 agent 训练的团队,这篇值得精读。