字节笔记本
2026年11月5日 · 约 2 分钟读完
动作关键信号藏在视觉中层:NEO-VLA 把编码器扔了
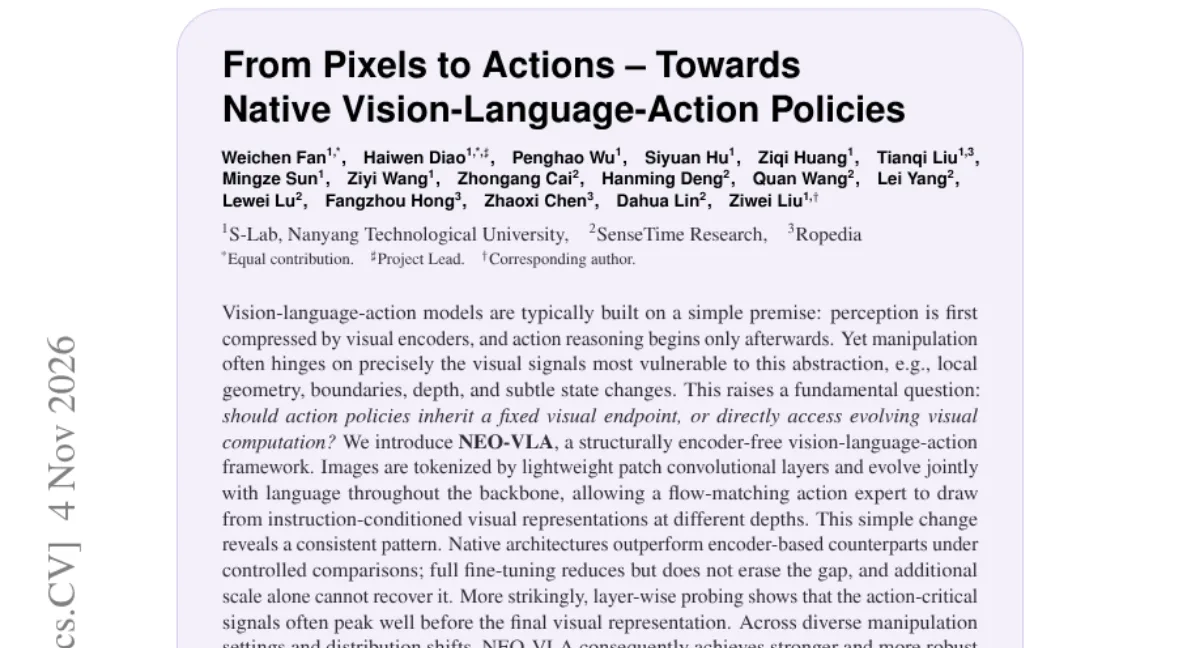
VLA 模型的常规剧本是「先压缩视觉,再做动作决策」,一篇登上 HF Daily Papers 的论文对这个前提发了难:动作真正需要的信号,往往在视觉表征成形之前就到峰值了。论文 From Pixels to Actions(arXiv 2611.06918)据此造出了免编码器的 NEO-VLA。
证据先于架构:冻结骨干时,读早期层明显优于读最后一层(skip-28 拿到 90.9%,end-28 只有 86.7%);全量微调能缩小但不能消除差距,单纯加大规模也补不回来。更有意思的是反向实验:给编码器式的 Qwen3-VL 接入中间视觉塔特征,冻结性能反而从 79.5% 掉到 64.9%,说明关键不在「有没有中间层」,而在表征形成与暴露的方式。
NEO-VLA 的架构因此走了一条彻底的路:不要预训练视觉编码器、不要图像码本、不要自编码器,一个轻量两级卷积 patch embedder(总步长 32)直接把像素送进骨干的 token 空间。骨干是 40 层、2B 参数的视觉语言模型,旋转位置编码按时间、高、宽三维分解;旁边挂一个窄型流匹配动作专家,通过可配置的层映射直接读取骨干中间层的 KV 缓存来预测连续动作块(双臂加机身),推理用 10 步欧拉采样。
训练规模毫不含糊:预训练语料来自 AgiBot-World、Open X-Embodiment、DROID、RH20T、RoboMIND 等 9 个公开数据集家族,共 223 万条 episode、9,927 小时,三阶段从冻骨训专家到全参再微调。成绩单上,LIBERO 平均成功率 97.4;LIBERO-plus 总分 89.7,是开源(代码加权重)模型里最好的,相机扰动下 94.5、语言扰动下 91.7;RoboTwin 2.0 的 Clean2Rand 拿 69.4,开源方法最强。真机上 3 个任务各 50 条演示微调,成功率 12/20、17/20、13/20,参数更小却匹敌或超过 π0.5。它还顺手验证了一件事:动作数据与理解数据协同训练,模型保留文本输出且策略最优;只微调动作,文本能力直接归零。
短板作者自己也交代了:对视觉外观变化很稳,但陌生空间构型和任务目标仍显著退化。RTX 3090 上 282.5 毫秒一次查询的延迟,离高频控制还有距离。但对「机器人基础模型该长什么样」这场争论,这篇给出了一个干净有力的论点:别把动作专家锁死在视觉的终点站。