字节笔记本
2026年10月10日 · 约 4 分钟读完
函数过了测试,整仓照样交不出去
函数过了测试,整仓照样交不出去
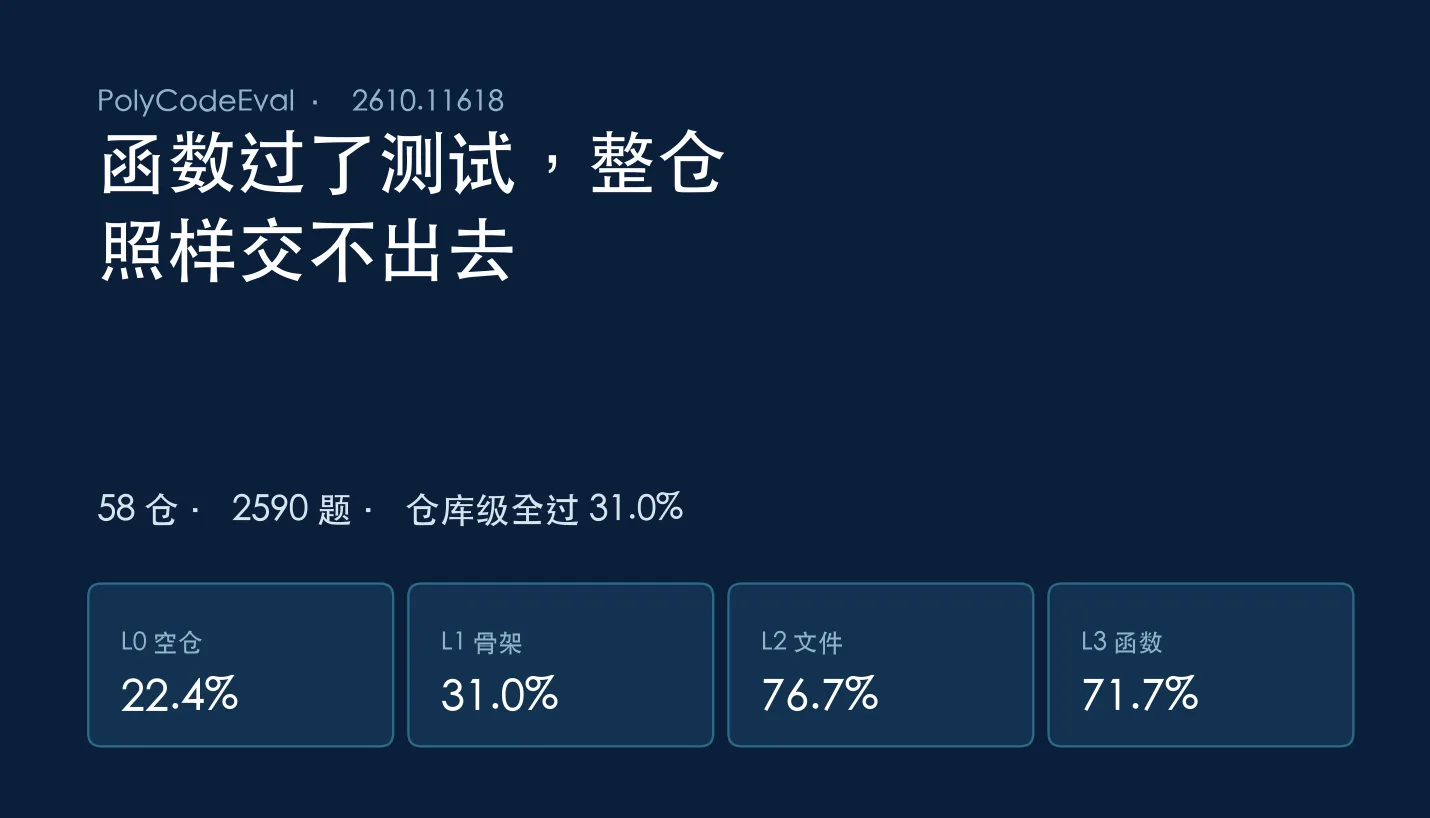
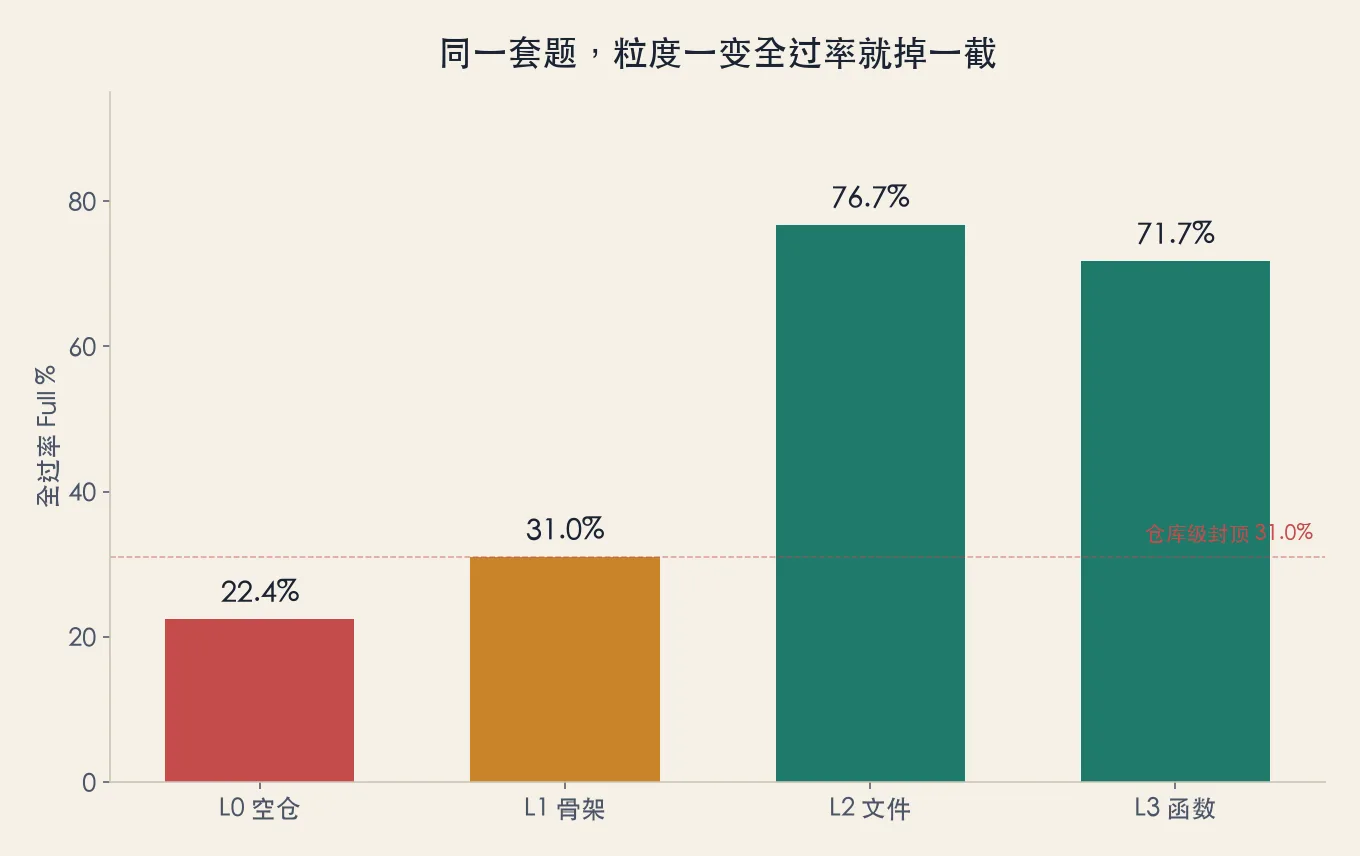
评测单常把函数级通过率写成能力。天津大学放出的 PolyCodeEval 把同一套可执行仓库拆成空仓、骨架、文件、函数四档,结果立刻分层:函数能绿,整仓仍交不出去。仓库级全过最高只有 31.0%,文件级能到 76.7%,函数级 71.7%。再拿函数绿当仓库能力,缺口就被抹平了。
论文编号 2610.11618。基准从大体超过 500 星的可执行仓里收了 58 个,语言是 Python 13、Go 12、JavaScript 11、Java 11、C++ 11。总题量 2590:空仓与骨架各 58,文件 150,函数 2324。空仓和骨架的目标平均 2464 行,文件档 898 行,函数档约 29 行。评测先补测试,58 仓行覆盖都超过 85%,均值 93.9%,2590 条路径都在对照实现上跑通。规格用对照证据套模板生成,完整、清楚、一致、可实现四项均值不超过 3.5 就人工改到超过 3.5。项目页公开了套件、脚本和产物。仓库本身 0 星,实验数据要另下。
粒度一变,排名也跟着换
空仓这一档,Claude Code 的构建、测试、全过是 74.1%、91.0%、22.4%,花了约 7427 万 token、48.76 美元;Codex 是 63.8%、88.5%、20.7%,约 1080 万 token、14.87 美元。ChatDev 配 Sonnet 全过 17.2%,配 GPT 12.1%。骨架档把 Claude Code 全过抬到 31.0%,构建却掉到 62.1%;Codex 全过 29.3%,构建 60.3%。作者写明:多给一份仓库骨架,并不保证整体变好。这一档的建构率下滑,常常是目录和依赖已摊开,智能体反而把已有接口写坏。
文件档 150 题,Codex 构建 88.0%、全过 76.7%;直接问 GPT 全过 55.3%,直接问 Sonnet 57.3%,Claude Code 56.7%。Codex 对直接 GPT 的构建差,校正后显著性约 3.08 乘 10 的负 5 次。Claude Code 有 20 题评不上,包括 10 分钟上限和异常停。函数档 2324 题,RepoCoder 加 GPT 构建 85.4%、全过 71.7%,直接问 GPT 全过只有 48.8%。HCP 加 GPT 全过 68.9%,AlignCoder 加 GPT 全过 50.3%。1891 道成对题上,同文件相关上下文把 GPT 全过从 50.1% 抬到 55.0%,Sonnet 从 40.2% 抬到 51.6%。温度固定 0.2。
语言一拆,骨架有的帮忙有的拆台
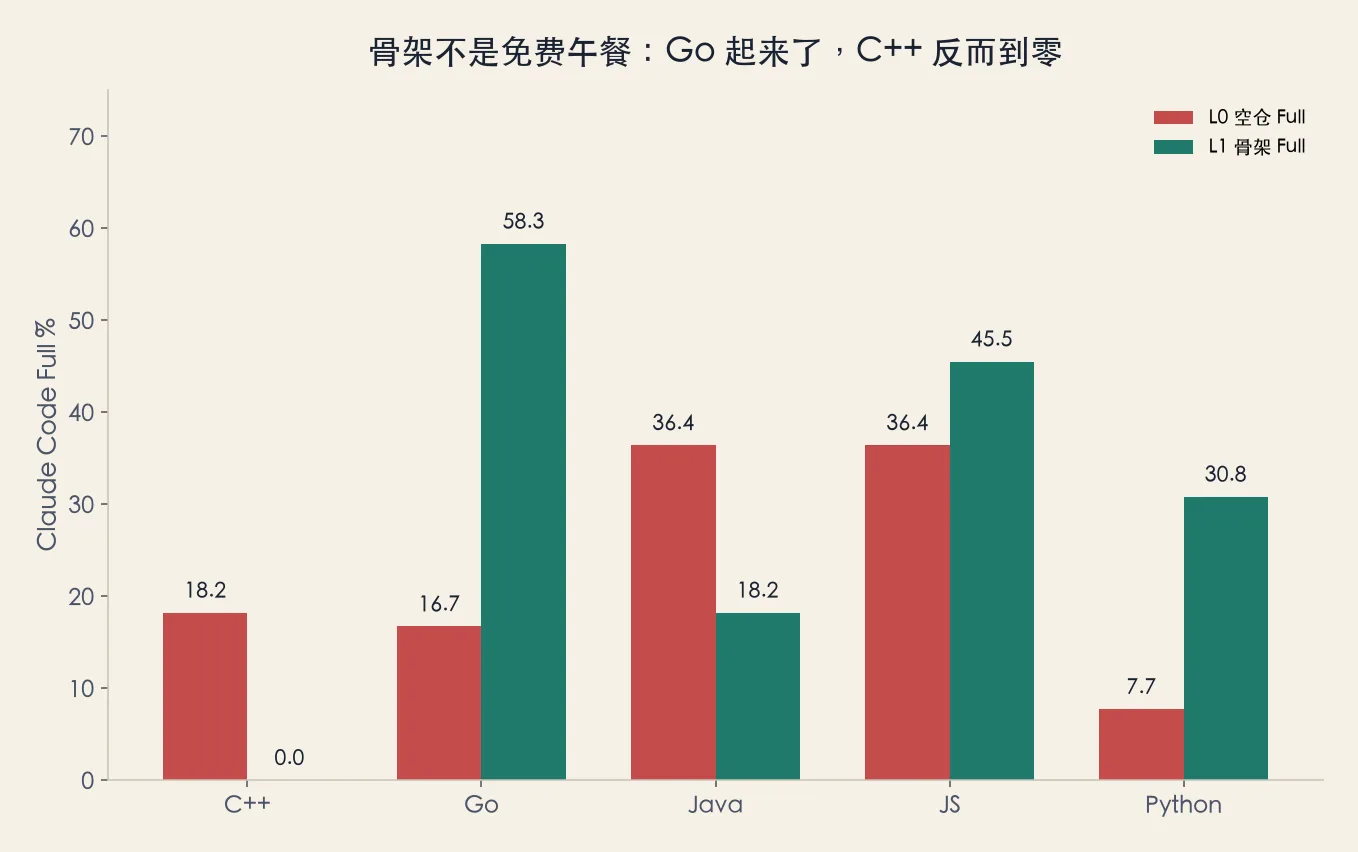
Claude Code 在空仓的全过是 C++ 18.2%、Go 16.7%、Java 36.4%、JavaScript 36.4%、Python 7.7%。换成骨架后,Go 升到 58.3%,JavaScript 45.5%,Python 30.8%,Java 掉到 18.2%,C++ 掉到 0。Codex 的骨架档也是 Go 50.0%、C++ 只有 9.1%。文件档里 Codex 的全过是 C++ 66.0%、Go 82.9%、Java 82.8%、JavaScript 88.5%、Python 61.5%。作者的判断很直:方法排名会随粒度和语言变,仓库级要更强的工程拼装,文件级要更懂接口和依赖。现有做法仍难在多种粒度和语言上交出完整片段。
四档不是同一道题的四种写法。空仓只给规格,骨架把目录摊开,文件档挖空至少三个非琐碎函数,函数档只挖不少于三行且不是访问器的函数体。一份报告若只写函数全过,读的人会误以为智能体已能从规格长出一棵仓。复现应先看项目页的四档分数并排,再决定把哪一档写进报告。函数绿了只说明那一截补丁对上了测试。