字节笔记本
2026年10月10日 · 约 4 分钟读完
固件智能体过关,不该只看一次提交
固件智能体过关,不该只看一次提交
编码智能体改文件、编译、跑测试、读日志再回修,已经是日常。固件不一样:过关要看现场传感、时序和安全联锁,不是静态片段对不对。一次提交过了隐藏评分,往往只说明评测把现场摊开了,并不等于智能体自己会找证据。
Jorge García-Carrasco 等人在《Journal of Systems Architecture》179 卷发了闭环评测,论文编号 2610.11447,配套仓库是公开的任务包和 420 次试验产物。每道题给一段文字规格、收窄的工作区和看得见的编译运行面。智能体只能改允许的固件,用提交脚本走构建,隐藏评分器再对照主机测试和被控对象。目标板是仿真里的 ESP32,保证可复现。五道控制题从液位启停、热室滞回、压力联锁、混罐耦合,一直到过滤罐时序。四种反馈分别是单次提交、只看现场自检、提交后只给红绿、以及带详细诊断的对照。
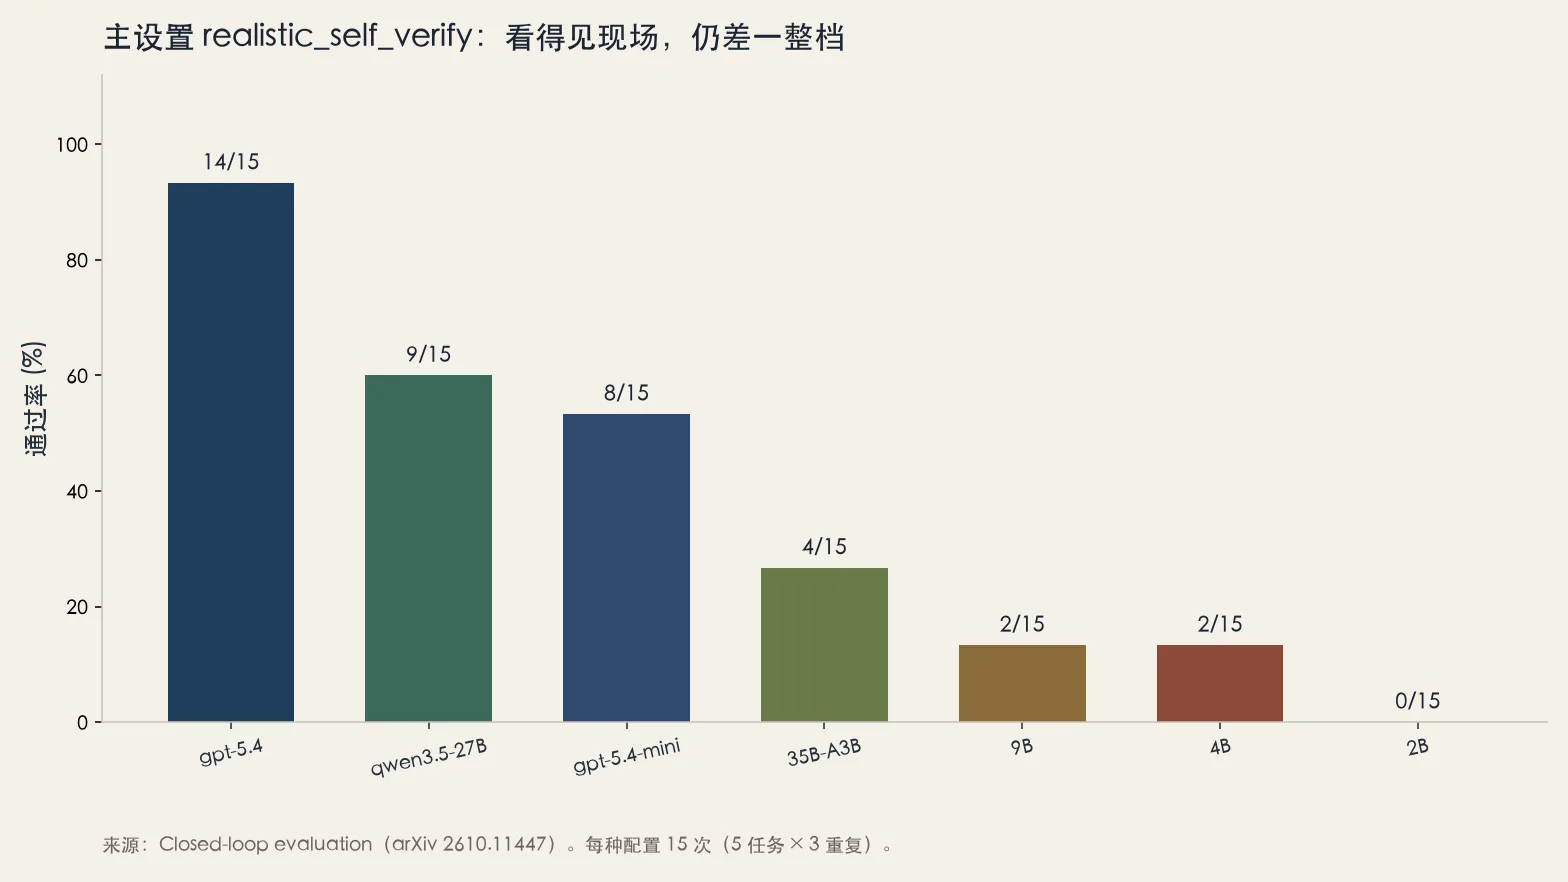
看得见现场,分数仍按档掉
主设置叫 realistic_self_verify:本地证据在,隐藏评分词不给。七套配置各跑 15 次,也就是 5 题乘 3 次重复。gpt-5.4 是 15 次里 14 次,约 93.3%;qwen3.5-27B 是 9 次,60.0%;gpt-5.4-mini 是 8 次,53.3%;35B 混合专家是 4 次,26.7%;9B 与 4B 都是 2 次,13.3%;2B 是 0 次。作者写明,最强的托管配置也没有把整套题做满。
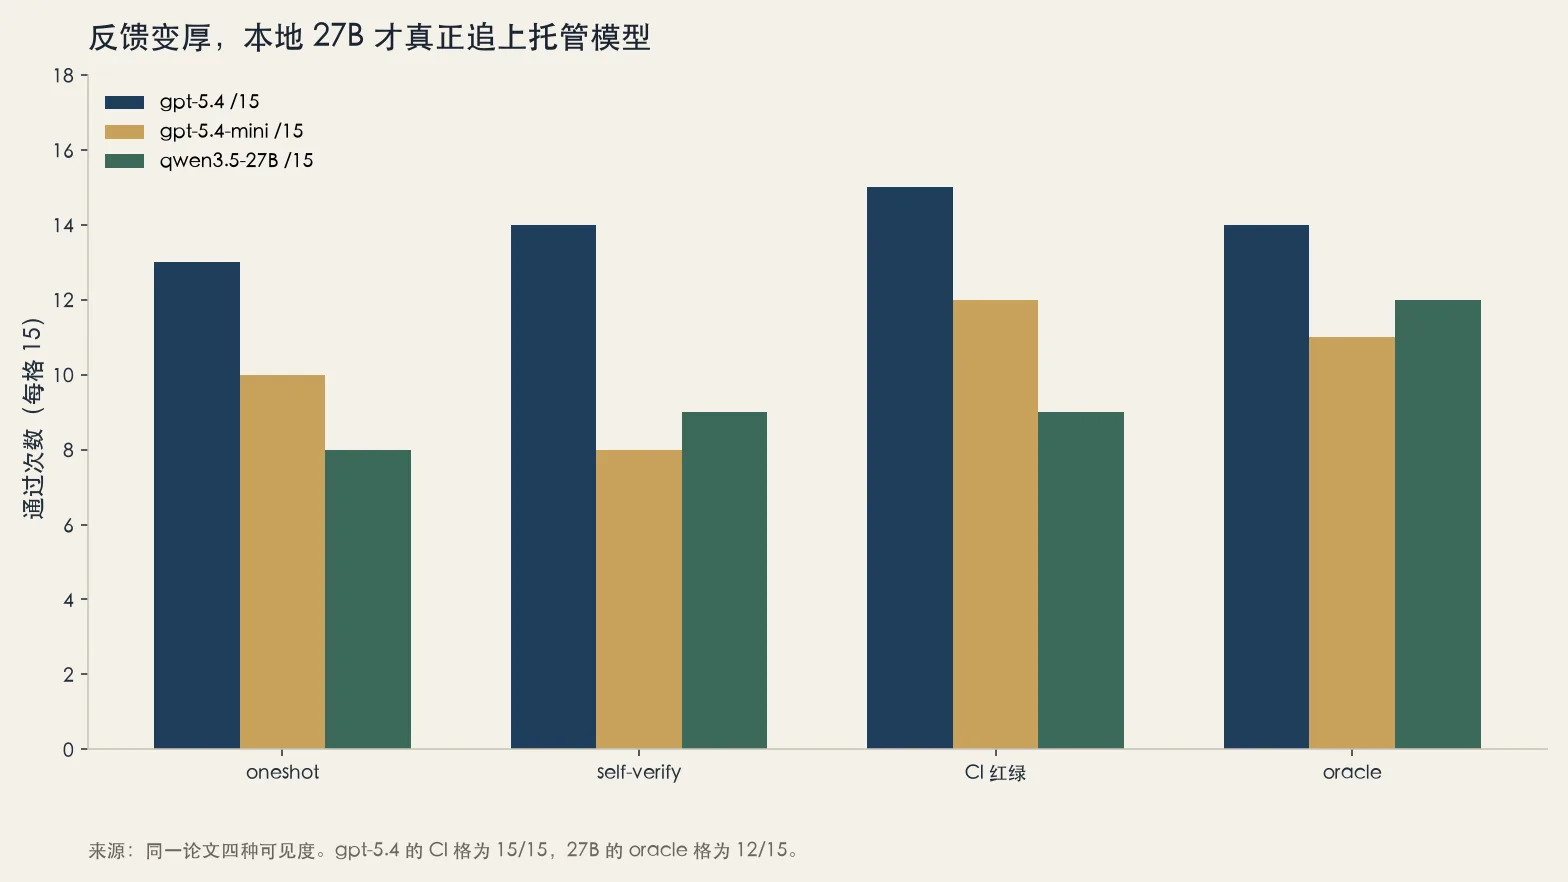
四种可见度把差距拆得更清楚。gpt-5.4 在单次、自检、红绿、对照四格是 13、14、15、14;27B 是 8、9、9、12。红绿格里托管模型 15 次全过,本地 27B 要等到对照诊断才到 12 次。本地五档共 60 次、同一块加速卡上,27B 是 38 次,约 63.3%;混合专家 26 次;9B 14 次;4B 5 次;2B 0 次。小模型更费搜索:2B 大约烧掉 5495 万 token、716 次工具调用,却只交出 8 次提交。过滤罐时序是最难的那档,液位启停是锚点。
观点很直接。固件智能体值不值得上桌,要看它在只看得见编译、运行和现场读数时能不能自己收敛,而不是看一次对照诊断喂饱之后的通过率。仓库把任务包、运行器和 420 次产物公开了,复现应先卡在自检这一档,再去碰红绿和对照。
小模型不是慢一点,是搜索先散掉
主设置里消耗也对得上档位。gpt-5.4 大约 42 万 token、35.5 次工具、1.0 次隐藏评分、2.6 次自测;27B 大约 690 万 token、109 次工具、1.5 次隐藏评分、12.2 次自测;2B 则把 token 推到约 7739 万、工具约 987.5 次,隐藏评分 0 次。可见度矩阵里,gpt-5.4 单次提交已是 15 次里 13 次,约 86.7%,红绿格 15 次全过;27B 单次 8 次,对照格 12 次,约 80.0%。本地五档墙上时间大约 26.2、16.9、25.3、21.4、29.7 分钟,第一次交出提交的中位大约 18.0、11.9、17.6、9.4、1.3 分钟。提交次数是 60、60、56、50、8。2B 几乎不交卷,却把搜索预算烧光。
五道题不是同一难度。液位启停要守住阈值、中位保持,以及 1000 毫秒陈旧读数就关泵。热室滞回要提前关加热并守 56 摄氏度顶。压力罐要求双路新鲜、开门禁压,压缩机和泄压不能一起开。混罐把补液和加热耦在一起,低液位锁加热,顶在 51 摄氏度。过滤罐要走阶段、连续 3 个清样、400 毫秒稳定,扰动后重来。作者把过滤罐时序写成最难的分界,液位写成容易的锚点。本地模型用 4 比特权重量化、思考关闭,跑在一块加速卡上。论文许可是署名 4.0。
所以过关不该写成一次提交变绿。自检档看的是智能体自己会不会读编译、运行和现场;红绿档看的是它会不会在只有通过与否时还找路;对照档看的是诊断喂饱之后还能不能收敛。三档分数并排,才知道那次过关是现场能力,还是评测把答案摊开了。