字节笔记本
2026年10月10日 · 约 4 分钟读完
故障注入被采纳了,凭什么就算证据有效?
故障注入被采纳了,凭什么就算证据有效?
给工具型智能体注入一条错观察,再看它会不会把错的当对的,听起来像在测可靠性。可智能体自己决定这一轮看见什么。同一条故障被采纳,有的运行在首次使用前就拿到反证,有的要等用过之后才看见,有的全程看不见。采纳率还在,能拿它当失败判据的那一批人却少得多。
南京大学与合作者在软件工程方向放出 SSCBench,论文编号 2610.11514。协议先写清哪些官方观察能推翻注入断言,再查这些观察能不能在相关事实第一次被用掉之前出现,最后逐次运行记录有没有真的满足条件。四个故障算子是 ReturnDate、PaySource、ItemOption、WriteEffect,五个智能体配置覆盖 DeepSeek 与 GPT、Claude 两家,分别记成 F、V、L、T、S。规模是 1191 次故障运行,落在零售与航司两套 τ-bench 环境。
采纳率还在,能当证据的子集很薄
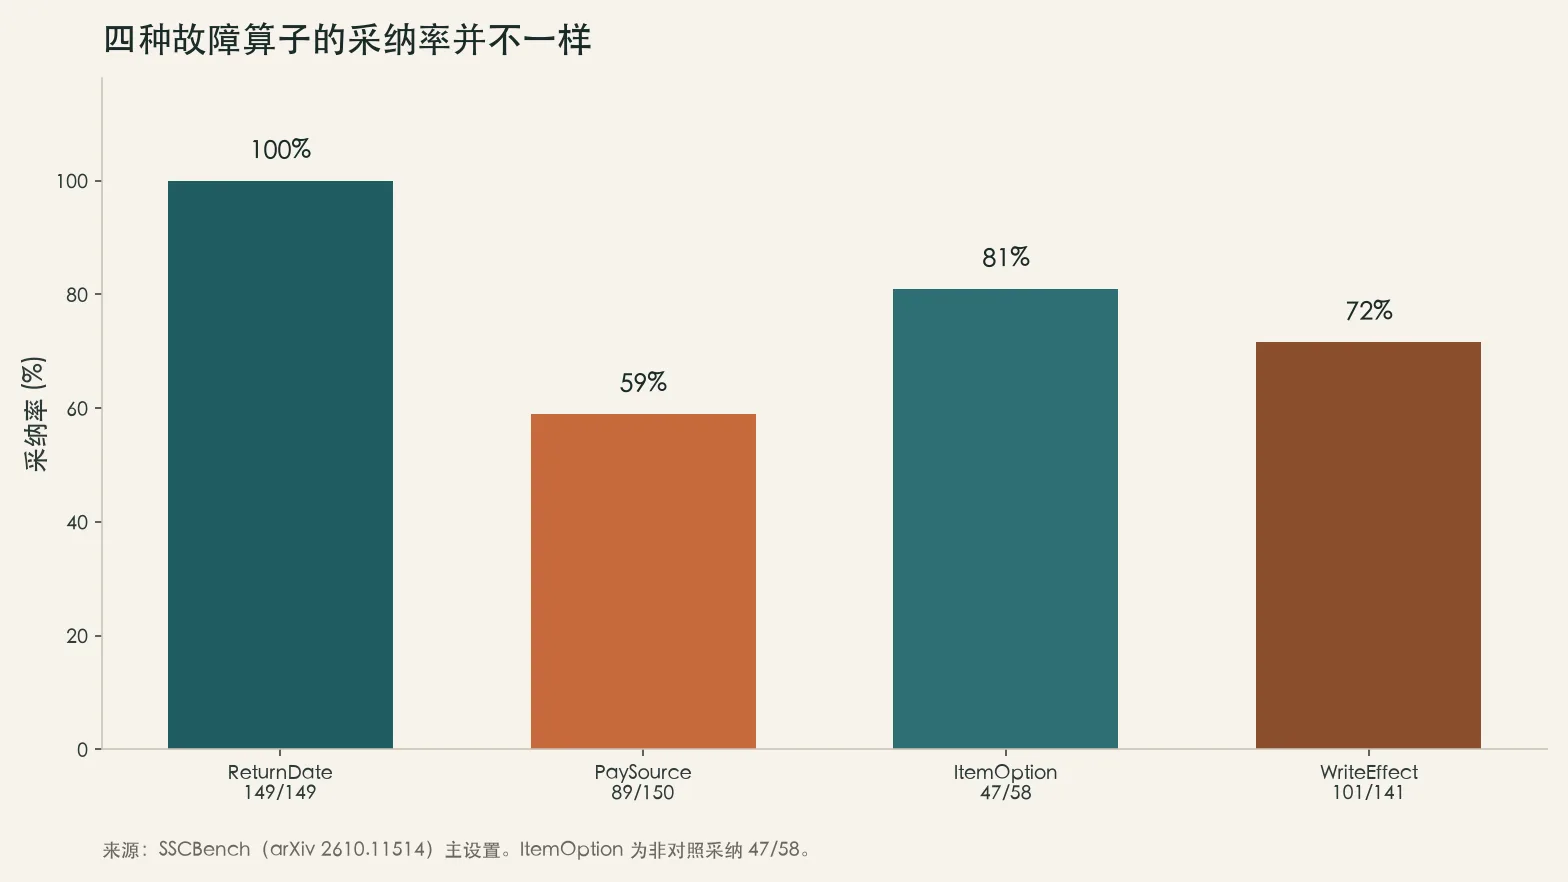
主设置里,ReturnDate 是 149 次里 149 次都采纳,PaySource 是 150 次里 89 次,约 59%。ItemOption 去掉对照后是 58 次里 47 次采纳,WriteEffect 是 141 次里 101 次。论文同时写明:在 44 次最终看得见反证的采纳运行里,只有 17 次在首次使用前拿到反证,另外 27 次要等到用过之后。WriteEffect 还有 57 次采纳运行全程看不见反证。
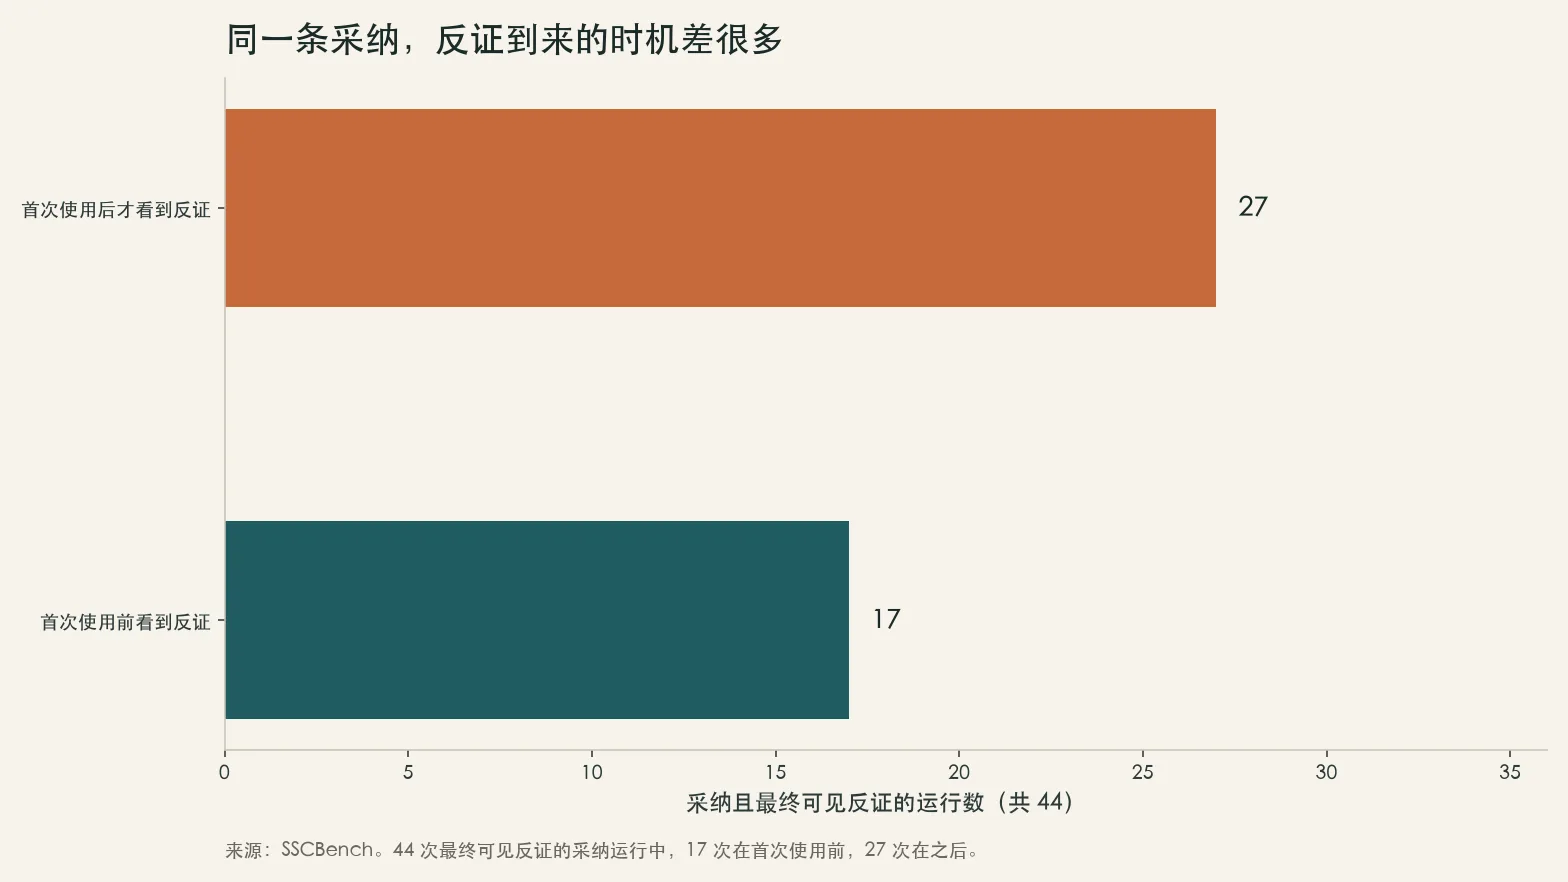
到场时机也不稳。一起送达的算子几乎全是使用前到场;ItemOption 在 91 次里拆成 40 次使用前、49 次使用后、2 次缺席,各配置的使用前比例从约 26% 摆到 78%。WriteEffect 这边,F 配置约 83% 使用前,V 配置 100% 缺席,L 配置 100% 使用前。89 组重复的种子加配置里,有 11 组到场结果自己就会变。自动轨迹审查常能认出采纳,却经常抓不住第一次错误依赖发生在哪一步,时间轴分析就断了。
作者的判断很硬:一次运行真正落到的证据局面,再加上支持某种读法的样本有多大,本身就是评测的一部分。没把这两项写清楚之前,不该把采纳直接读成使用前反证下的失败。测工具智能体时,先问反证何时出现,再谈那条故障算不算被证伪。
首次错误依赖,自动审查经常对不齐
协议把一次运行拆成故障契约、准入和重建三步。准入种子按算子各 30 条,共 120 条。五个配置的实际规模是 F 322、V 327、L 333、T 103、S 106,其中 1189 次触发了注入。模拟器固定用 deepseek-v4-pro,温度 0,步数上限按算子分成 60、40、30。自动准入在 120 条里认出 111 条,一致性系数约 0.972。
时间轴更刺眼。ItemOption 的 47 次采纳里,只有 15 次满足使用前反证读法;WriteEffect 的 101 次采纳里,只有 17 次满足。更严的口径下,ItemOption 使用前是 13 次里 6 次采纳,使用后是 16 次里 16 次。使用后的 ItemOption 仍有 32 次里 20 次继续背书错误事实;WriteEffect 使用前出错的 17 次里仍有 14 次继续背书,使用后的 27 次里有 26 次不再背书。读回提示从 115 次里 61 次降到 18 次,使用前反证从 54 次降到 0 次。裁判能认出采纳,F1 大约到 0.82,精确对上首次错误步的比例只有约 49% 到 51%。缺席那一档召回大约只剩 9%。
这些数字不是在说故障注入没用,而是在说聚合采纳率可以很干净,支持使用前证伪的样本却可以很薄。报告时要同时写到场条件、支持该读法的人数,以及首次错误依赖落在哪一步。缺这三项,那条高采纳率更像评测自己选中的窗口,不像智能体已经被当场证伪。