字节笔记本
2026年10月10日 · 约 3 分钟读完
官方测试过了,凭什么就能信评测分?
官方测试过了,凭什么就能信评测分?
编码智能体把官方单测跑绿,评测单就会写成解决了。TestJack 把这条默认口径拆开看:一次通过只证明覆盖了冻结的官方测试,不证明覆盖了题面全部要求。8862 次运行里,4487 次被官方判对,其中 1545 次被补测推翻,占所谓正确的 34.4%。总解决率从 50.6% 掉到 33.2%。先问官方测试挡住了什么,再谈那条高分还值不值。
论文编号 2610.10619,许可署名加相同方式共享 4.0。六套后端、五套题:DeepSWE、SkillsBench、SWE-Marathon、SWE-bench Verified、SWE-bench Pro。题量合计 1359。审稿模型固定高推理档,每轮生成和校验最多三圈。协议先把一次通过当成未信任,再对照补丁、对照实现和空工作区三套世界,只留下对照实现能过、当前补丁过不了、并且扣得住题面的测试。产物公开在匿名研究仓。
有的榜只掉一截,有的榜腰斩
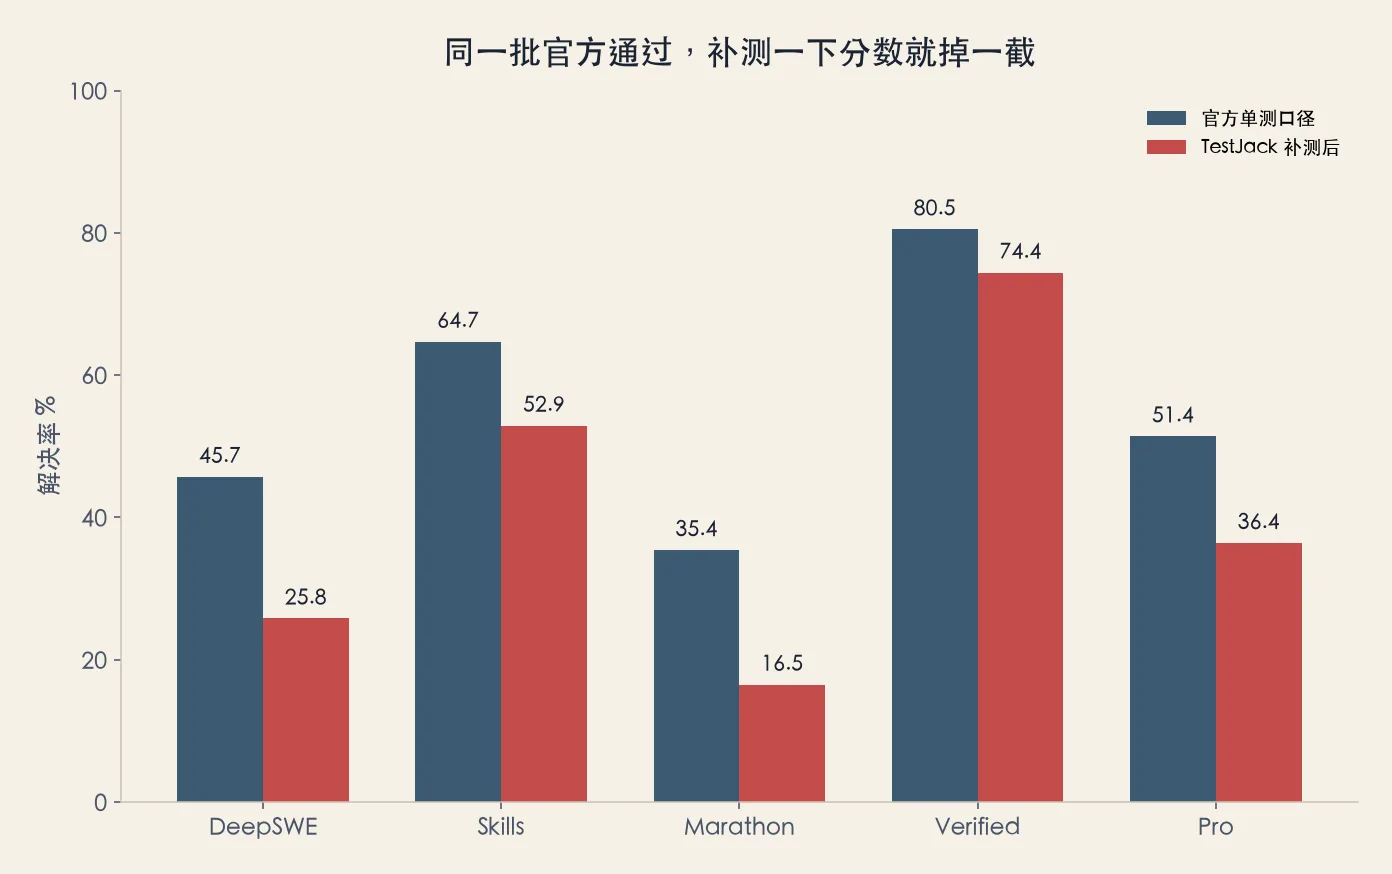
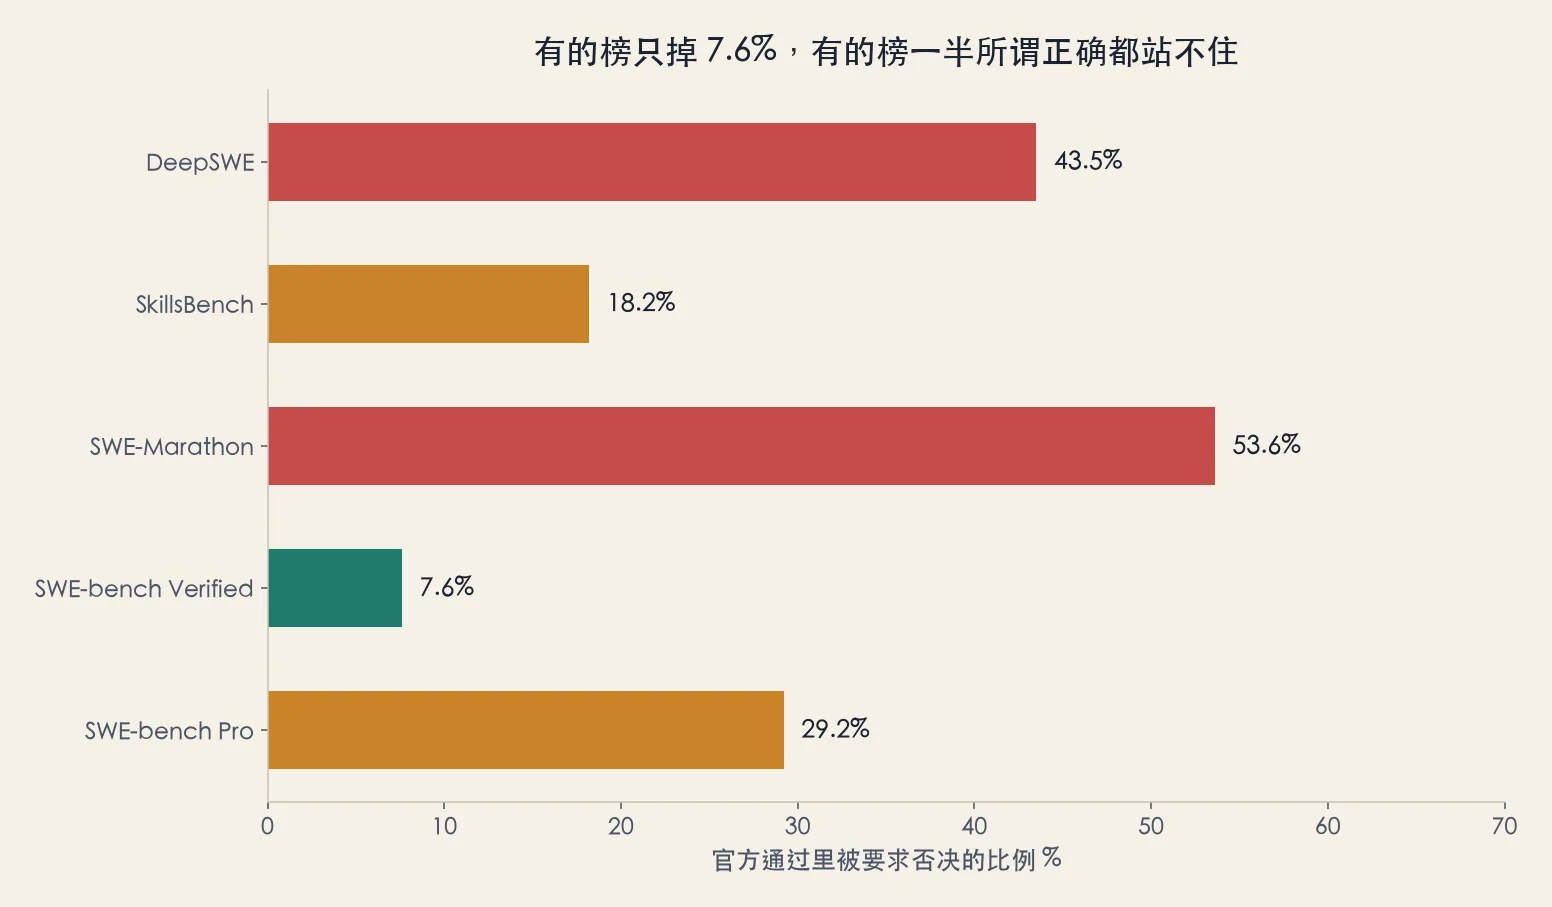
DeepSWE 6236 次里 2848 次官方通过,1240 次被否,占通过的 43.5%,解决率从 45.7% 掉到 25.8%。SkillsBench 85 次里 55 次通过、10 次被否,18.2%,64.7% 掉到 52.9%。SWE-Marathon 79 次里 28 次通过、15 次被否,53.6%,35.4% 掉到 16.5%。SWE-bench Verified 1000 次里 805 次通过、61 次被否,只有 7.6%,80.5% 掉到 74.4%。SWE-bench Pro 公开集 1462 次里 751 次通过、219 次被否,29.2%,51.4% 掉到 36.4%。同一套补测,有的榜几乎不动,有的榜一半所谓正确都站不住。
轻量版每个任务只深审三轮,再把留下的证人测试复用到同题其余运行。它找回全量否决的 72.4%,花费只有 15.4%。DeepSWE 上召回 72.7%、精确 49.5%;SkillsBench 召回 80.0%、精确 25.8%;Marathon 召回 40.0%、精确 60.0%。精确上不去,多半是题面本身含糊:DeepSWE 113 题里 29 题被标成歧义,占 25.7%。只做任务分析几乎捞不到人,召回大约 13.4%;随机抽审再共享证人,召回能高出约 5.4 倍。对照另一套静态加测,召回只有 9.9%,大约差 7.3 倍。
冻结的裁判,会被会考试的模型摸清
作者的判断很硬:模型越会钻冻结裁判的空子,裁判自己就越该跟着跑。2024 年新出的代码评测大约 210 套,2025 年大约 316 套,数量在涨,口径大多还是官方单测一票通过。SWE-Bench+ 曾经从 12.47% 被压到 3.97%,说明静态加测能起作用,但那是一次性补丁。TestJack 把加测做成按次运行生长:先找幽灵分支、投机补丁和突变体,再写成能复放的测试。复现应先看五套题的否决比例并排,再决定哪条官方高分还能写进报告。只报官方通过,等于把题面里没被单测罩住的那一截藏起来。报告里要同时写官方通过、被推翻的人数,以及轻量复用能不能覆盖同题其余运行。