字节笔记本
2026年10月8日 · 约 2 分钟读完
检索找不到的答案,得算出来:RECAST 给 RAG 换思路
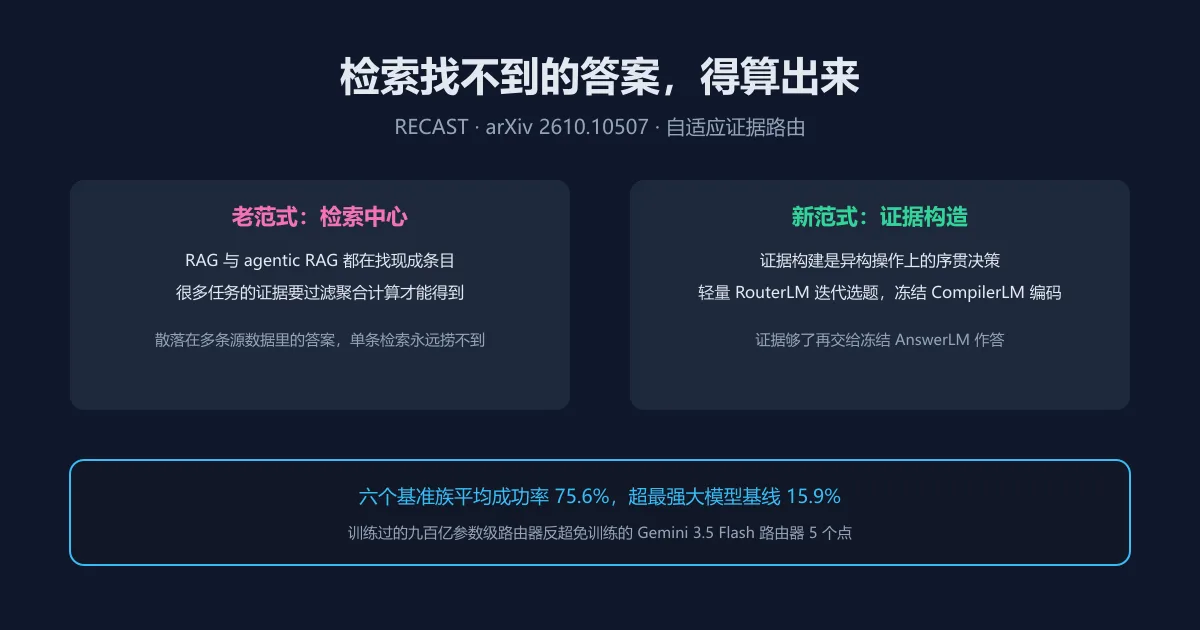
问一个平均数、比一组趋势、算一笔跨表账,这类问题的答案不在任何一条现成的文档里,而在多条源数据的过滤聚合计算之中。标准 RAG 和 agentic RAG 都是检索中心的思路,找现成条目再拼答案,遇到要算的证据就束手无策,只能靠多轮检索碰运气,上下文塞满了仍凑不齐答案。10 月 7 日放榜的 RECAST(arXiv 2610.10507,作者 Yilun Hao、Craig Boutilier、Chuchu Fan 等)换了套思路:不找证据,构造证据,把取料这件事从检索问题改写成计算问题。
三段式分工
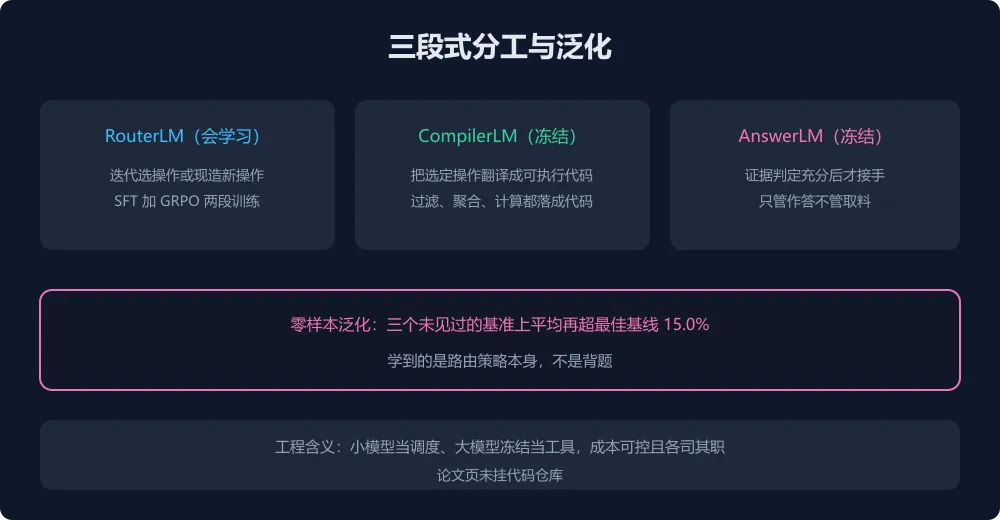
证据构造被表述为异构操作集合上的序贯决策,三个角色各司其职:轻量的 RouterLM 负责迭代决策,每一步选择或现造一个原语操作(也可自定义),判断证据是否已经足够,不够就继续下一步;冻结的 CompilerLM 把选定的操作翻译成可执行代码,过滤、聚合、计算都落成代码跑,中间结果可查可复现;证据判定充分后交给冻结的 AnswerLM 作答,它只管答不管取料。RouterLM 的训练走 SFT 加 GRPO 两段,先从示范学会基本套路,再用强化学习打磨长期效果,学的是路由策略本身。这个分工的工程美感在于成本结构:贵的两个大模型全部冻结当工具,零训练零微调成本,只有小的路由器需要训练,调度智能长在自己家里,换底层模型也不用重训。
数字与泛化
六个基准族平均成功率 75.6%,比最强的大模型基线高 15.9%,领先幅度在证据类任务上属于断档级别;训练过的九十亿参数级 RouterLM 反超免训练的 Gemini 3.5 Flash 路由器 5 个点,说明路由策略确实学得动、值得训,小模型专精一件事照样赢大模型客串;更硬的是泛化,三个训练时未见过的基准上平均再超最佳基线 15.0%,零样本不缩水,学到的是怎么路由而不是背题。对做企业知识库与数据分析 agent 的团队,这套思路直接可用:凡答案需要跨条目计算的问答,别再堆检索轮次,把证据构造显式建模成操作序列,小模型学路由、大模型冻结出码,账单和效果两头都好看。落地的第一步可以很朴素:把现有知识问答里那些检索多轮仍答不准的问题挑出来,按过滤加聚合的操作序列重写求解路径,用这次实验验证换赛道的收益。论文页未挂代码仓库,跟进以作者发布为准。