字节笔记本
2026年10月8日 · 约 2 分钟读完
奖励也要跟着进化:RewardWeaver 把过程监督织起来
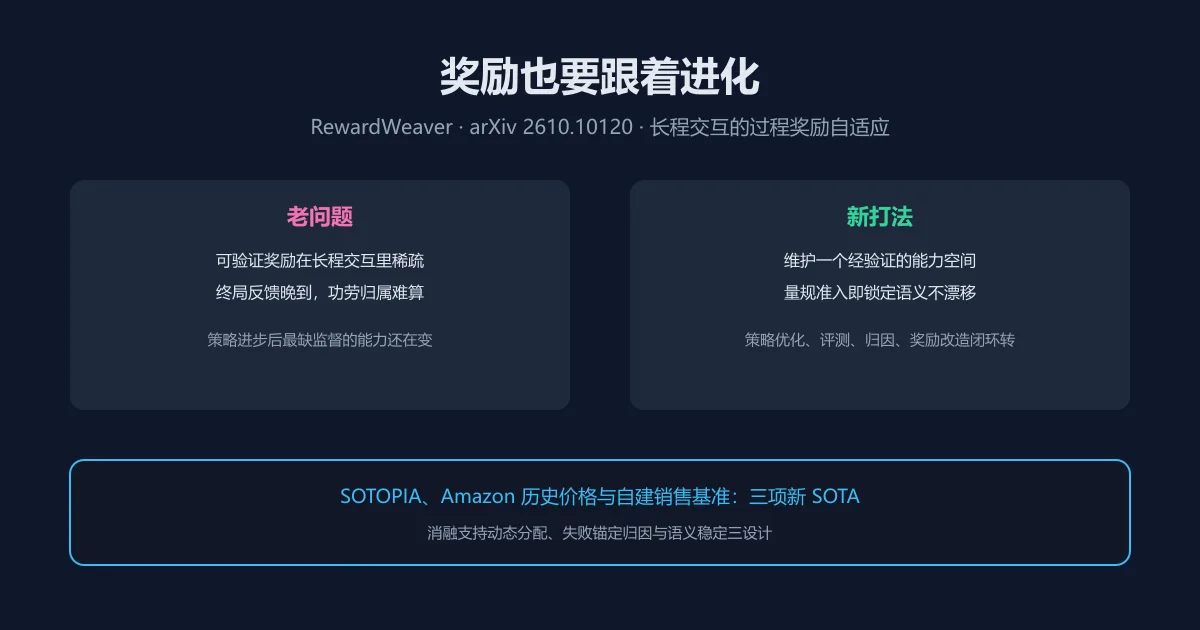
用强化学习训练长程交互 agent 的人都撞过同一堵墙:可验证奖励只在终局兑现,反馈稀疏,功劳归属难算;补过程奖励能缓解,但策略一进步,最缺监督的能力就换了一个位置,静态的奖励设计很快失焦,训练越往后越像蒙眼射击。10 月 7 日放榜的 RewardWeaver(arXiv 2610.10120,作者 Hengbo Xiao、Fan Zhang 等)把过程奖励做成活的:跟着策略一起进化,始终把监督火力对准当前短板。
能力空间加四步循环
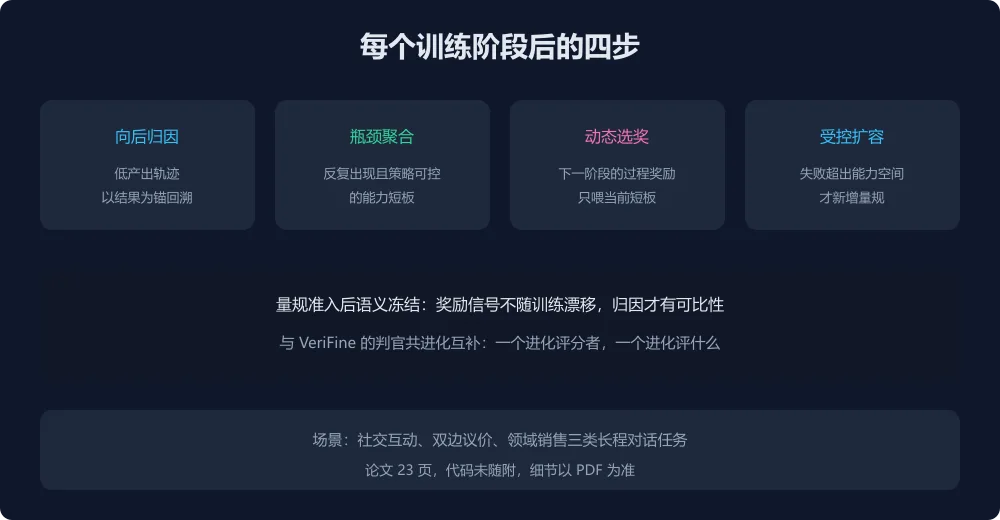
框架的底座是一个经验证的能力空间:每条量规通过验证准入后语义即冻结,不随训练漂移,这保证了不同阶段的归因可以互相比较,也让奖励信号的历史记录有据可查。在此之上,每个训练阶段结束跑四步:先对低产出轨迹做以结果为锚的向后归因,从终局失败反推到底哪一步走错;再聚合出反复出现且策略可控的能力瓶颈,一次性的失误与环境影响被过滤掉;然后据此动态选择下一阶段的过程奖励,只喂当前短板,已达标的能力不再重复占用监督资源;当失败模式超出已有能力空间的覆盖时,触发受控扩容新增量规,扩张有门槛而非无脑膨胀。策略优化、任务评测、失败归因、奖励改造四件事闭合成环,这就是名字里织布的意象:纬线随经线走,布面始终平整。
成绩与读法
在社交互动(SOTOPIA)、双边议价(Amazon 历史价格)与自建的销售基准三类长程对话任务上,RewardWeaver 刷新 SOTA,覆盖的恰是奖励最难设计的软技能地带;消融实验分别支持动态奖励分配、失败锚定归因与语义稳定三处设计,各自拆开都能看到掉分,说明每个部件都在挣自己的饭钱,不是装饰性复杂度。把它与上周的 VeriFine 并读正好互补:VeriFine 进化的是评分者本身,RewardWeaver 进化的是给哪些能力评分,一个练裁判一个换考题,合起来就是评测与奖励体系的完整共进化观。论文 23 页,代码未随附,具体数字以 PDF 为准。对自建 RLVR 管线的团队,可直接借走的设计是语义冻结的能力空间加按阶段换奖励:先把能力维度定义稳,再让监督信号跟着瓶颈走,这套节奏比一次性设计全套过程奖励更经得起训练轮次的考验,也省掉了反复重调奖励的手工活。