
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
HuggingFace 给机器人物理智能办了场野外大考
API中转
¥120
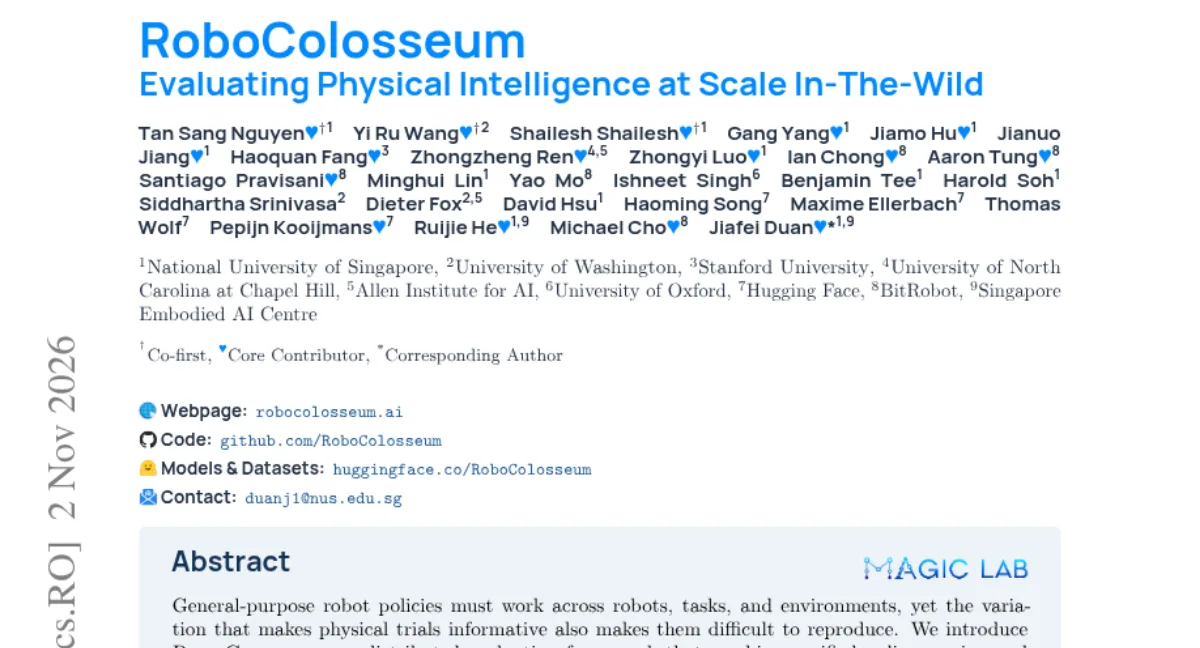
机器人策略的论文分数越来越好看,但换个机器人、换个厨房还成立吗?Hugging Face 参与组织的 RoboColosseum(arXiv 2611.02497,项目页 robocolosseum.ai)把考场搬到了真实世界:一个分布式评估框架,用统一策略服务与标准化协议,在全球 124 个本地运营站点跑出 5,699 次两两对比,测试 5 个 VLA 策略加 3 个前沿 AI 智能体,覆盖 SO-101、Franka、双臂 YAM 和 G1 人形四种本体。
发现相当泼冷水也相当有价值。其一,前沿 AI 智能体已经能与专用 VLA 策略掰手腕,但所有系统都难以可靠完成开放世界任务。其二,跨本体的策略排名一致性很弱(Kendall's W 只有 0.24):在 A 机器人上排第一的策略,到了 B 机器人上可能垫底。其三,Open Track 的排名对微调后的表现预测很差,三个共有本体上出现大幅排名反转,这意味着「选型看跑分」在机器人领域暂时行不通。其四,进度度量能揭示成功率掩盖的差异:G1 人形上没有策略完成任何 5 个任务,但平均进度在 13.3% 到 23.2% 之间明显分化。
方法上也有贡献:主动匹配(active matchmaking)用远少于均匀采样的物理试验次数达到相当的排名一致性,省的是真金白银的机器人时间。28 位作者横跨多所大学与 Hugging Face 社区,代码与项目页均已公开。
对具身智能团队,这个「野外大考」模式本身比任何单篇策略论文都重要:物理智能的进步需要可复现的真实世界评测,而分布式加标准化协议是目前唯一规模化的答案。
相关文章

分享: