字节笔记本
2026年10月7日 · 约 7 分钟读完
单文件信息流原型:三处必查的写法与暗坑
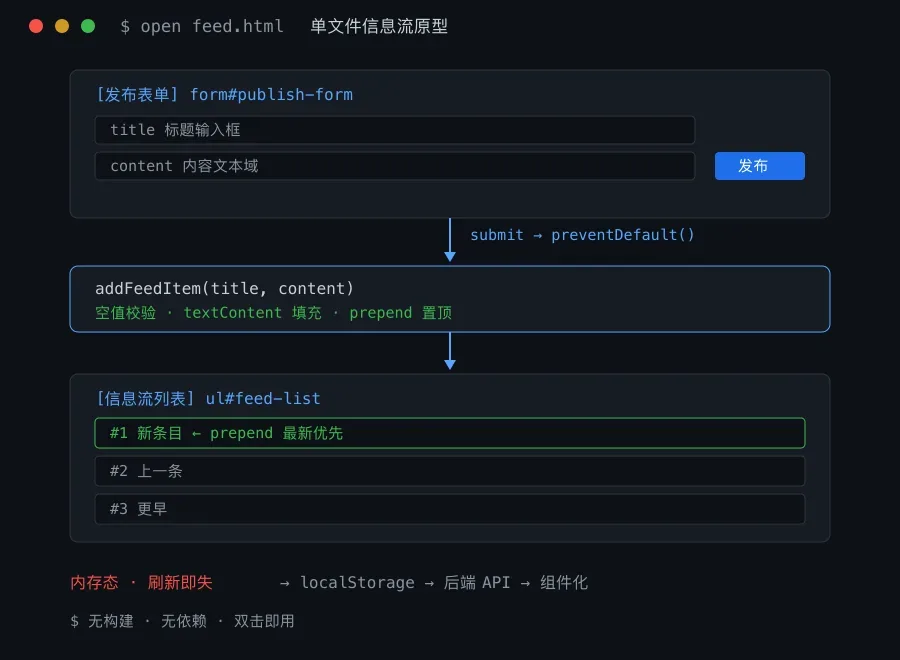
现在的 AI 对话工具,一句话就能吐出一个能在浏览器里直接打开的页面。拿一个常见需求试水:做一个信息流发布页——上方是表单,输入标题和内容,点发布;下方是信息流列表,新条目出现在最前面。几秒钟后你会得到一个几十行的单文件 HTML,双击就能用。
但"能跑"和"写对了"是两回事。这类即时生成的代码,最适合当成一次代码评审的样本:结构里值得学的学下来,暗坑当场修掉。下面以这样一个真实生成的页面为样本,逐段过一遍。
先看整体:单文件结构为什么成立
整个页面只有一个 HTML 文件:样式靠 CDN 引入 Tailwind 的运行时脚本,交互是一段内联的原生 JavaScript,连构建工具都不需要。这个形态的合理性在于反馈速度——零依赖、零配置,保存即所见,发给别人也只是发一个文件。
它天然适合三类场景:产品概念演示,重点是"能点能看"而非健壮性;团队内部小工具,用户就是身边几个同事;教学演示,一个文件就是全部知识点。需要提醒的是,Tailwind 的 CDN 运行时是给原型和本地实验用的,官方明确不建议用于生产——真要上线,应回到构建流程,让未用到的样式在打包时被剔除。
跟"正经开工"的方案对比一下更清楚:用脚手架开一个 Vite 或 React 工程,初始化加装依赖就要几分钟,产出的是一堆配置文件和组件目录,用来验证一个交互想法明显太重;而单文件方案的全部成本就是保存和刷新。反过来,一旦页面需要路由、需要构建期优化、需要多人协作开发,单文件就到了天花板。选型依据不是技术偏好,而是这个页面的预期寿命有多长。
页面本体是两个卡片模块:发布表单(标题输入框、内容文本域、发布按钮)和信息流列表。数据流只有一条:表单提交、取值、插入列表、清空输入框。结构没毛病,但往下看每一环,都有值得推敲的写法。
第一处:submit 事件的默认行为
生成的代码监听表单的 submit 事件,第一行就调用了 event.preventDefault()。这行必须写,而且必须最早写:浏览器对表单提交的默认行为是把数据发往 action 地址并整页刷新,一旦默认行为抢先发生,刚插入列表的数据瞬间清零,页面回到初始状态。
顺手补一个原生红利:把输入控件放进真正的 <form> 标签,而不是用 div 加按钮点击来模拟,用户在输入框里按回车就能触发提交。键盘语义是白送的,很多人用 div 搭表单时把这份体验白白丢掉了。
提交处理函数里还有两行容易被当成废话的代码:先判断标题和内容是否为空,非空才插入;插入成功后把两个输入框清空。它们恰恰是表单体验的底线——空条目会制造一条需要人工清理的脏数据,而输入框不清空,用户分不清刚才那次发布有没有生效。原型阶段的表单可以没有校验样式,但不能没有这两个动作。
第二处:innerHTML 拼接用户输入
把视线移到插入列表的函数,会看到这样的写法:
li.innerHTML = '<h3 class="text-lg font-semibold">' + title + '</h3>'
  + '<p class="text-gray-600">' + content + '</p>';
用户输入被原样拼进了 HTML 字符串。在标题里输入 <img src=x onerror=alert(1)>,发布后脚本立刻执行——教科书级的 XSS。原型阶段当然没人攻击你,但问题有两层:一是这段代码只要被复制进任何真实项目,隐患就跟着走;二是数据一旦持久化,哪怕只是存进 localStorage,恶意内容就从"自己伤自己"升级为存储型 XSS,之后每个打开页面的人都会中招。在真实部署的页面里,攻击者拿到的绝不只是弹个窗:同源下的 Cookie、localStorage 里的登录令牌、代表用户发起的任意请求,都在注入脚本的射程之内。
修法按成本从低到高:优先用 textContent 给文本节点赋值填充标题和内容,天然免疫注入;其次是手动转义 <、>、& 和引号;确实要支持富文本时,引入 DOMPurify 这类白名单过滤库再渲染。在原型里就养成用 textContent 的习惯,成本几乎为零。
第三处:数据只活在内存里
目前所有条目都存在页面内存里,刷新即清空。这符合原型的定位,但要心里有数,因为它决定了这个页面算不算一个产品。
想让数据活过一次刷新,第一级是 localStorage:发布时把条目数组 JSON.stringify 后写入,页面加载时读回并遍历重建列表,十几行代码就能完成,代价是数据绑死在一台设备的浏览器里。第二级是后端 API:一旦需要多人共享,数据就要落到服务端,起步只需要 GET 拉列表、POST 发布两个接口,存储用 SQLite 或 Postgres 都行,前端只改一处——插入 DOM 前先等请求成功。第三级是组件化:当点赞、评论、编辑这类操作出现后,继续手写 DOM 增删会迅速失控,迁到 React 或 Vue,把表单和列表拆成组件、由状态驱动渲染,才是可持续的形态。
做 localStorage 方案时有个顺手的改进:条目别只存标题和内容,加上时间戳和自增 id 再入列。信息流的排序、去重、将来对接后端时的增量拉取,都靠这两个字段撑着,越早加上迁移成本越低。等数据量超过几十条,还要补上分页——一次全量渲染长列表,原型里无所谓,真实用户面前就是卡顿。
还有一个容易被忽略的小细节:插入列表用的是 prepend 而不是 append,新条目置顶,形成倒序时间线。这是社交产品多年训练出的阅读惯例,做信息流类页面第一天就该遵守。
收尾:一张评审清单
把检查点收拢,任何 AI 生成的单文件交互页面都可以用同一张清单过一遍:
- submit 是否阻止了默认行为,回车提交是否可用;
- 用户输入是否进了 innerHTML,能否换成 textContent 或转义;
- 数据存在哪里,刷新后会丢什么,这是否符合预期;
- 样式是否依赖 CDN 运行时,上线前要不要回构建流程;
- 交互复杂度到了哪一级,何时该迁组件化框架。
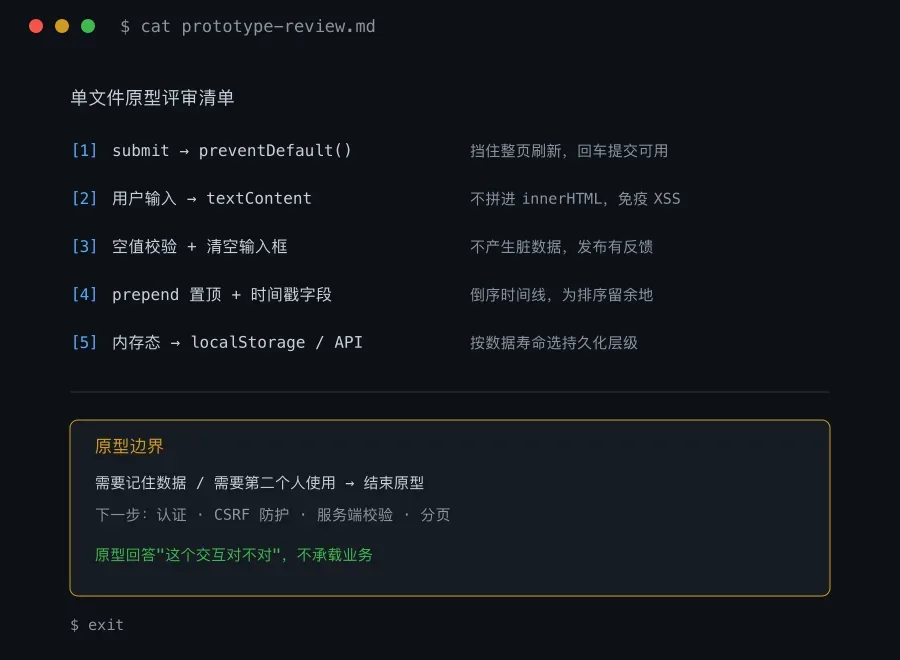
单文件原型的价值,在于把"设计、开发、验证"的线性流程压成"出原型、当场点、马上改"的循环,验证一个交互方案的成本趋近于零。它的边界同样清楚:当页面需要记住数据,或者需要第二个人使用时,原型阶段就该结束。原型负责回答"这个交互对不对",不负责承载业务——守住这条线,它是最高效的思考工具;越过这条线还往里堆功能,它就变成最难维护的那种代码。