
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
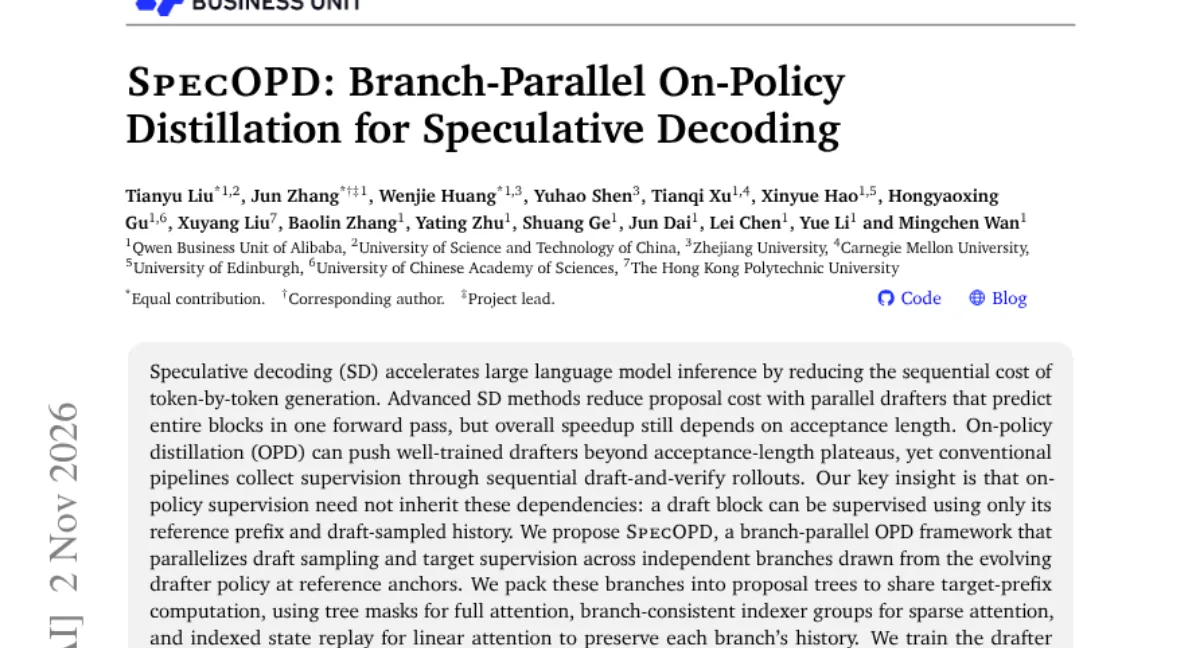
草稿不用等验证:SpecOPD 让投机解码的监督吞吐翻 16 倍
API中转
¥120
投机解码的草稿模型靠在线策略蒸馏变强,但训练数据收集环节有个结构性别扭:监督信号要靠「草拟、验证」的串行 rollout 一步步攒,每个训练上下文都依赖之前的验证结果,GPU 大部分时间在空转,论文记录的平均活动率只有 26%。Qwen 团队的 SpecOPD(arXiv 2611.02846)的洞察一句话就能说清:草稿块的监督只需要它的参考前缀和草稿采样的历史,根本不用等完整验证轨迹走完。
做法是把监督数据改成树状并行采集:参考序列作为共享主干,随机选锚点、在锚点上并行采出独立草稿分支。工程难点在三种注意力机制各有各的处理:全注意力用树掩码共享主干 KV,稀疏注意力用分支一致的压缩索引组,线性注意力则从不可变检查点恢复锚点状态再并行推进。打分目标沿用 E2E-TV,直接以草稿与目标分布重叠的前缀乘积作为接受长度代理。
数字按论文口径:平均接受长度最高提升 41.45%(Terminal 任务单项 81.51%);监督 token 吞吐相对串行 rollout 提升 16.09 倍;Qwen3.8-27B 实测生成加速最高 3.56 倍,五个负载在并发 1、8、32 下的几何平均加速为 2.97、2.23、1.35 倍。覆盖 8B 到 125B 的目标模型、三种草稿架构、四类任务。
要如实标注的边界:27B 在智能体任务上提升有限(某配置略降 1.02%),125B 草稿模型缺智能体预训练数据,E2E-TV 对条件提案只是代理目标。对做推理服务的团队,这篇把「蒸馏数据怎么采」从串行流水线改成了树状农场,训练成本曲线的斜率被实质性掰弯了。
相关文章

分享: