字节笔记本
2026年10月7日 · 约 11 分钟读完
用 Stable Diffusion 量产英语单词闪卡配图
用 Stable Diffusion 量产英语单词闪卡配图
背单词这件事,配图的价值常被低估。认知心理学里有个经典说法叫「双重编码」:一个词如果同时绑定图像和语音,回忆时就多了一条通路。道理不难懂,难的是执行——给一百个单词各配一张风格统一的插图,靠搜图引擎基本是灾难:尺寸不一、画风混杂,还随时可能踩版权。文生图模型恰好补上这块:提示词写对,一张卡片配图的成本可以压到几秒钟。
为什么选 Stable Diffusion?它自 2022 年开源以来一直是应用最广的文生图模型之一:可以本地部署,有庞大的社区模型与插件生态,提示词玩法成熟。而做「固定风格、批量出图」这类任务,正好是它的主场——本文就用一套英语单词闪卡的实际场景,把这条链路走通。
本文整理一条经过实际验证的路线:先用四段式结构写出能用的提示词,再用一张参考图把风格钉死成模板,最后用脚本批量替换变量,把「一张一张画」变成「一条流水线」。
一、四段式:提示词的通用骨架
给 Stable Diffusion 写提示词,最稳的入门结构是四段式:
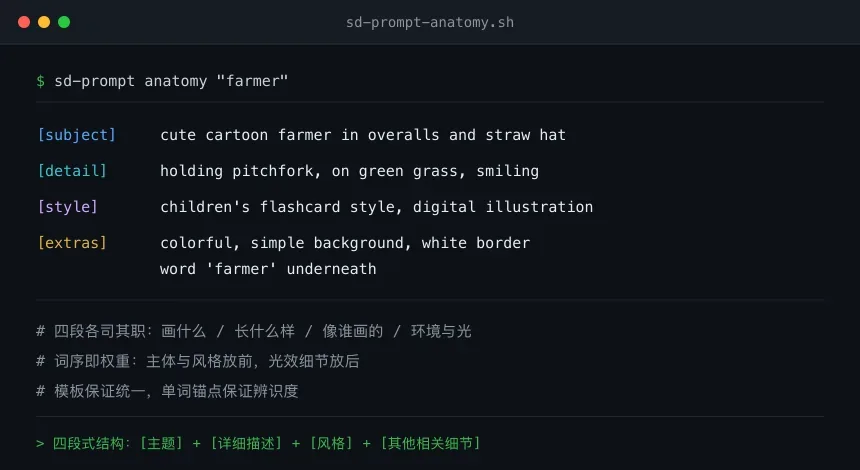
[主题],[详细描述],[风格],[其他相关细节]
四段各司其职。主题回答「画什么」,最好具体到一个名词;详细描述回答「长什么样」,补颜色、姿态、材质这些视觉属性;风格段决定「像谁画的」,photorealistic 和 digital illustration 是两个完全不同的世界;其余细节负责环境与光,比如背景、布光。
举几个实测效果稳定的写实风格例子:
- 苹果:"A red apple, realistic, detailed, on a white background, studio lighting"
- 猫:"A cute fluffy cat, sitting, big eyes, whiskers, photorealistic, soft lighting"
- 书:"Open hardcover book, pages with text, on wooden table, soft ambient lighting, detailed"
- 海滩:"Tropical beach, clear blue water, white sand, palm trees, sunny day, photorealistic"
还有一个实用细节:文本编码器对词序敏感,排在前面的词权重更高,所以四段的先后不是随意的——主体和风格放前,光效细节放后。
注意苹果这条:白色背景加棚拍布光,生成的是「词典插画」而不是「果园随手拍」。对闪卡这种用途,背景本身就是提示词的一部分——越干净,单词和图像的绑定越牢。
二、参考图锚定:把风格钉进模板
四段式解决了「单张能不能用」,批量生产要的是「张张像一套」。这一步的关键,是找一张目标风格的参考图,把它的视觉特征逐项翻译成风格词。参考图怎么挑?三条标准:构图是否可复制(最好是单主体居中)、信息密度是否够低、配色是否有辨识度。
以儿童农场主题闪卡为例,拆出来的模板长这样:
Cute cartoon [subject], on a farm,
children's flashcard style, colorful,
simple background, white border,
word 'X' underneath, digital illustration
这段模板里每个风格词都有明确分工:
- cute cartoon + digital illustration:钉住画风,避免滑向写实照片;
- children's flashcard style:钉住构图与用途,模型会倾向居中、留白、低信息密度;
- colorful:儿童插画需要的高饱和配色;
- simple background:背景干净,主体突出;
- white border:直接画出卡片白边,出图即成品;
- word 'X' underneath:把单词本身写进画面。
套上三个单词,得到完整提示词:
- 农夫:"Cute cartoon farmer in overalls and straw hat, holding pitchfork, on a farm, children's flashcard style, colorful, simple background, white border, word 'farmer' underneath, digital illustration"
- 绵羊:"Cute cartoon fluffy sheep, smiling, on green grass, farm setting, children's flashcard style, colorful, simple background, white border, word 'sheep' underneath, digital illustration"
- 拖拉机:"Cute cartoon yellow tractor, big wheels, in a farm field, children's flashcard style, colorful, simple background, white border, word 'tractor' underneath, digital illustration"
留意每个例子在模板之外都补了「这个单词特有的视觉锚点」:农夫的背带裤、草帽和干草叉,绵羊的绒毛与微笑,拖拉机的黄色大轮子。模板保证统一,锚点保证辨识度,两者缺一不可。
模板还可以「换壳」:把 on a farm 换成 under the sea 或 in the jungle,风格段原封不动,就能得到同一画风的不同主题系列。这是模板化相比逐条写提示词的真正优势——风格成了一种可复用的资产。另外,新模板定稿前先拿三个词试产一轮,对照参考图逐项检查:画风对不对、背景干不干净、白边有没有出来,全部达标再谈量产。
三、从一张到一百张:变量替换
模板成型后,剩下的是工程问题。做法很朴素:一张词表,两列——单词和视觉锚点,脚本负责拼接提示词、调用接口、落盘。十几行 Python 就够:
import csv, requests

TEMPLATE = ("Cute cartoon {detail}, {setting}, children's flashcard style, "
            "colorful, simple background, white border, "
            "word '{word}' underneath, digital illustration")

for row in csv.DictReader(open("words.csv")):
    prompt = TEMPLATE.format(**row)
    img = call_sd_api(prompt, negative_prompt=NEG, seed=42, steps=30)
    img.save(f"cards/{row['word']}.png")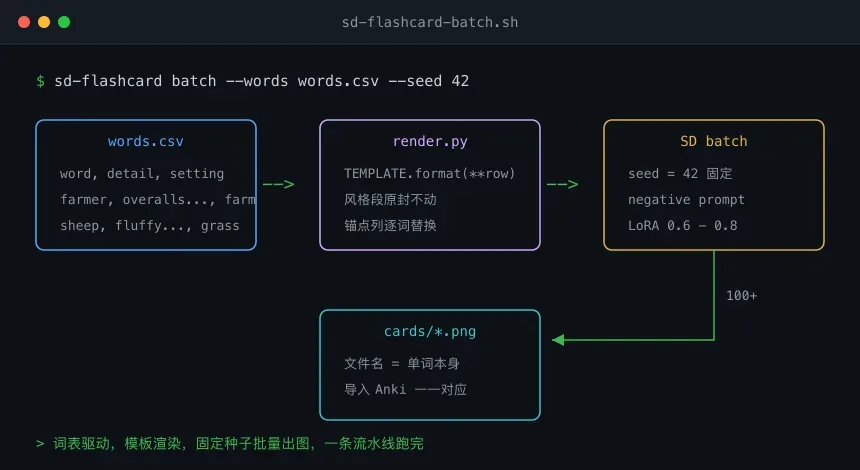
几条工程建议:词表用 CSV 或 JSON 管理,「锚点」列让每个词的插图有辨识度;文件名直接用单词本身,后面导入 Anki 时可以一一对应;同一主题的一批词一次跑完,中途别改模板。
如果本地跑的是 Automatic1111 或 ComfyUI,两者都带 HTTP API,用 requests 就能调;不想管显卡,用 diffusers 库起一个本地 pipeline 也是常见做法。图片文件到手后,导入 Anki 只差一步:建一个单词在正面、图片在背面的笔记模板,批量导入时把文件名字段映射上即可,整个闭环不需要任何手工排版。
四、风格一致性的三道保险
批量出图最大的敌人是「漂移」:第 30 张和第 3 张画风对不上。三道保险能压住大部分漂移。
固定种子。 同一个 seed 配同一个模板,构图波动会小很多。做系列插图时把 seed 写进脚本常量,而不是每次随机。
负面提示词。 正面提示词说「要什么」,负面提示词说「别出现什么」。闪卡场景的常用负面词:photo, realistic, blurry, watermark, text errors, deformed。它和模板是一套组合拳,只调正面往往事倍功半。另外可以调一调 CFG(提示词遵循强度):闪卡模板词多且互相配合,CFG 设在 7 到 9 通常更听话,再高容易出现过饱和的「烧图」感。
LoRA。 现成风格词压不住时,可以挂一个现成的卡通或贴纸风 LoRA,权重从 0.6 到 0.8 起步试;更讲究的做法是拿十几张目标风格的图自己训一个小 LoRA。相比训练整模的 DreamBooth,LoRA 只往模型里注入低秩增量,样本少、收敛快,是批量风格一致性的性价比之选。
五、几个坑
文内文字不可信。 word 'X' underneath 很诱人,但 SD 1.5 时代的文字渲染基本靠运气,拼错是常态;SDXL 之后好了不少,仍建议小批量验证,或者出图后用绘图工具补字。
细节要适度。 提示词不是越长越好:细节太多,模型顾此失彼、属性互相冲突;太少又落回「随便画一个」。每个视觉属性只说一遍,说清就走。
先试产再放量。 新模板先跑三到五张,确认风格收敛了再上全量词表。模板改动晚于批量生成,是返工的最大来源。
尺寸先定死。 闪卡通常是 1:1 或 4:3,批量生成前把分辨率写进脚本参数;跑完几百张再统一裁剪,纯属重复劳动。
写在最后
这套「四段结构、模板锚定、变量替换」的流水线,远不止做单词卡。同一思路可以直接迁移到其他教育素材:科学概念插图(水循环、太阳系)、历史场景再现、数学概念的图形化解释——本质都是「同一风格、不同主体」的批量出图。
更普适的一点是方法论:把提示词当代码来管理——有模板、有词表、有版本、可重跑——AIGC 才能从「抽卡玩具」变成生产线上的一环。