字节笔记本
2026年10月6日 · 约 2 分钟读完
研究品味能用算力算出来
AI 能不能有好品味,这个问题长期停留在玄学层面。周二批次的两篇论文把它推上了手术台:一篇给品味下了可测的定义,一篇让 agent 的提案接受人类专家的盲评。
TasteVal:品味等于计算效率
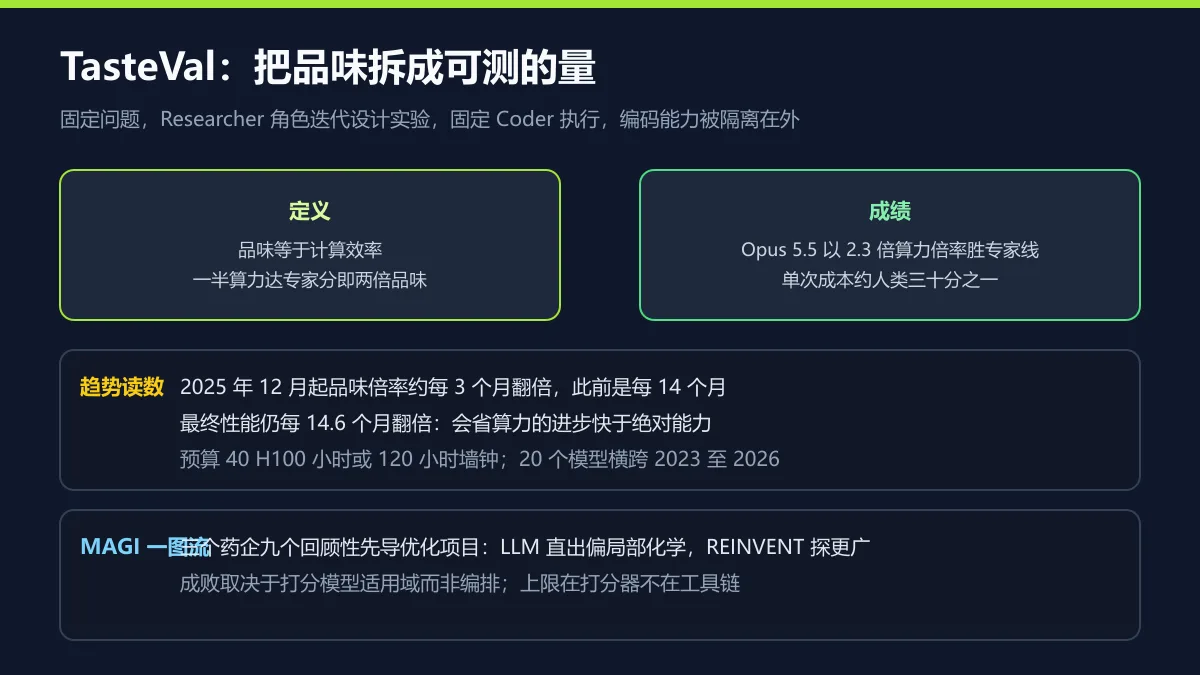
Oliver Jaffe 与 Dane Sherburn 的 TasteVal(arXiv:2610.06824)只测一件事:给定问题,模型作为 Researcher 角色迭代设计实验,固定的 Coder agent 负责实现,编码能力被隔离在外。品味的操作化定义很聪明:达到专家分数所用算力的一半,等于两倍品味。
设置给得足:八个开放式前沿 AI 研发任务,预算 40 个 H100 小时或 120 小时墙钟,24 位人类专家做基线,20 个横跨 2023 至 2026 的模型受测。结果是 Opus 5.5 以 2.3 倍算力倍率超过专家线,单次成本约人类三十分之一。更有信息量的是趋势:品味倍率自 2025 年 12 月起约每 3 个月翻倍,此前是每 14 个月,而最终性能仍保持每 14.6 个月翻倍。会省算力的进步速度,已经远超绝对能力的进步速度。任务本身保密不发布,防的就是基准污染。
MAGI:药物发现的实战检验
Pierre Llompart 等五人的 MAGI(arXiv:2610.06411)是开放模块化的分子设计 agent:定目标、跑优化、解读构效关系、修订策略,分子可由 LLM 直出也可委托 REINVENT 4 生成,打分服务可替换。考场是三个药企的九个回顾性先导优化项目。
两条生成路线各有性格:LLM 提案更贴近局部化学空间、主活性相当或更高且操作更少,REINVENT 探索更广。决定成败的既不是路线也不是编排,而是预测模型的适用域,出了域成功率就掉。盲评环节最有说服力:化学家分不清 agent 提案与保留分子,认为其构效推理大体可信但不完整。论文结论一句话可抄:目前真实项目的上限由打分器适用域决定,而非工具编排。仓库链接暂未见。
放在一起读
一篇证明品味的进步曲线可以量化且正在加速,一篇证明 agent 的提案已能骗过领域专家的眼睛。研究自动化这件事,从能不能干,走到了干得好不好、省不省的量化阶段。