字节笔记本
2026年10月6日 · 约 2 分钟读完
音画同生,动作一步到位
今日 Hugging Face 论文榜的两篇高票新作,一篇管生成端的音画同步,一篇管机器人端的推理提速,都带着扎实的开源交付。
Kandinsky 6.0 Video:音画一体出片
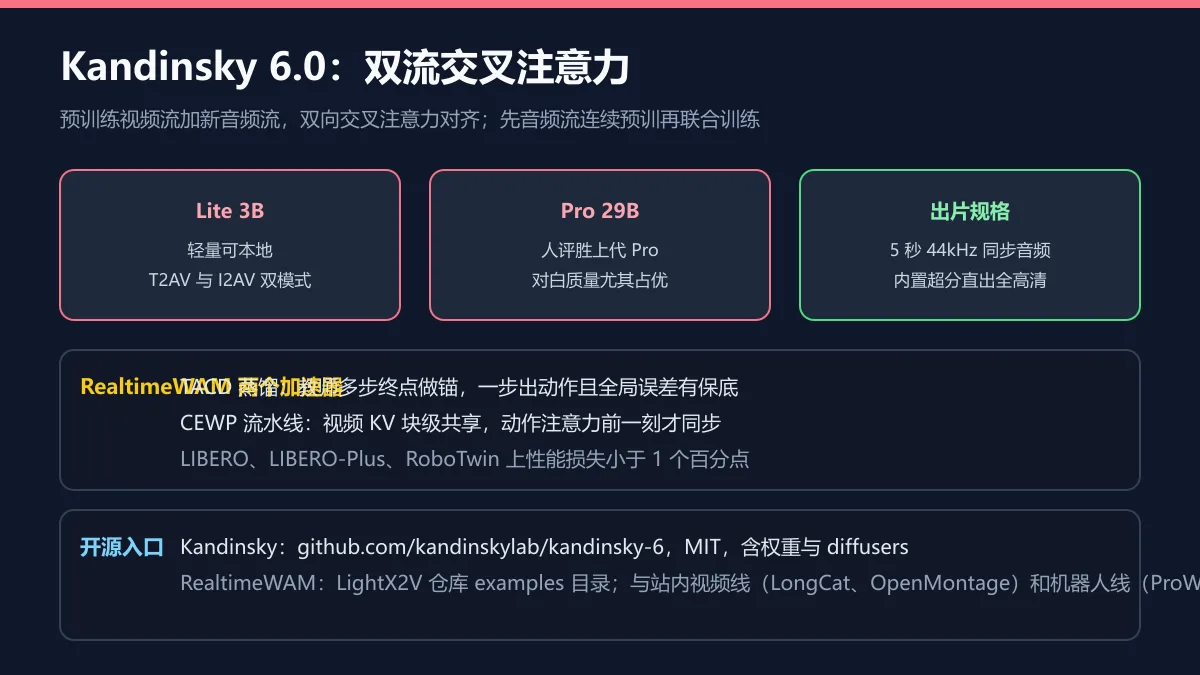
Kandinsky 团队的新作(arXiv:2610.05608,今日榜 22 赞)是一族同步文生音视频的基础扩散模型:Lite 版 3B 参数,Pro 版 29B,都能产五秒带 44kHz 同步音频的视频片段,含唇形同步,支持文本到音视频与图像到音视频两种模式,内置超分步骤直接出 1920 乘 1080 全高清。
架构延续五代的双流 CrossDiT:预训练视频流加新音频流,靠双向交叉注意力对齐。训练分四步走:音频流先连续预训练,再在配对音视频数据上联合训练,随后监督微调、强化学习后训练与蒸馏。人类评估显示 Pro 版明确胜过上代 Pro,与领跑的音视频模型整体相当,语音质量尤其占优。交付很完整:代码、权重与 diffusers 集成全部按 MIT 开源在 github.com/kandinskylab/kandinsky-6。
RealtimeWAM:一步动作加流水线
Chengtao Lv 等 10 位作者的 RealtimeWAM(arXiv:2610.06617)解决世界动作模型的两个推理瓶颈:动作去噪要多步迭代(专家内等待),视频与动作专家串行执行(专家间等待)。
两个加速器各对一个瓶颈。TACD 教师锚定一致性蒸馏发现局部一致性误差低不代表最终动作准,于是把冻结教师的多步终点拉来做监督,保证一步生成的全局准确。CEWP 跨专家波前流水线把视频 KV 缓存按块共享给动作专家,动作注意力需要某块的前一刻才同步,视频与动作专家得以重叠执行。LIBERO、LIBERO-Plus 与 RoboTwin 上,Fast-WAM 与 Faster-WAM 变体性能损失小于 1 个百分点,H100 端到端约 25 倍加速。代码开源于 LightX2V 仓库的 examples 目录。
放在一起读
一个把音视频生成做成开箱即用的开源全家桶,一个把世界动作模型推向实时档。与站内此前的 LongCat-Video、OpenMontage 视频线和 ProWAM 机器人线各自接续:开源视频栈补上了音画同步这块,机器人侧则离真机实时控制又近一步。