字节笔记本
2026年10月14日 · 约 2 分钟读完
终端 agent 的数据账:别再喂短轨迹了
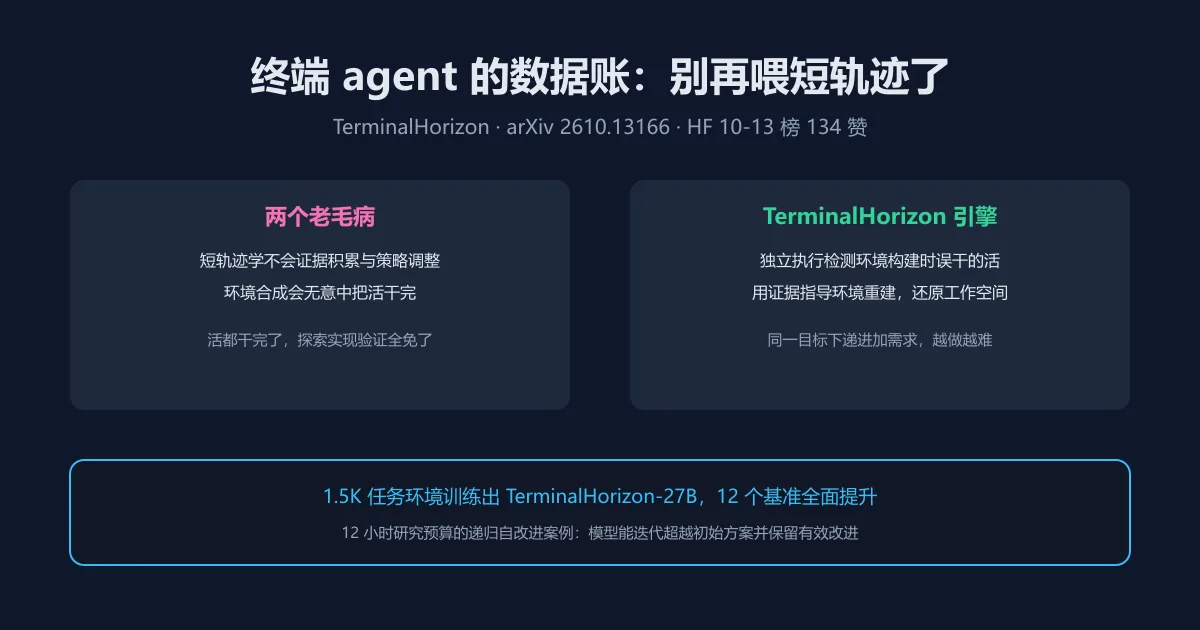
训练终端 agent 的数据集有个长期没被认真对待的缺陷:轨迹太短。真实专业工作要求 agent 积累证据、从反馈中调整策略、把中间结果加工成交付物,这些行为在几十步的短轨迹里根本练不出来。更隐蔽的是环境合成的副作用:构建环境时无意中把关键工作做完了,agent 拿到手的就是半成品,探索、实现、验证的需求全被移除,训练看似高效实则空洞。10 月 9 日放榜的 TerminalHorizon(arXiv 2610.13166,作者 Shun Zou、Xiangxiang Chu 等,HF 论文榜 134 赞)把这两个问题一起修了。
引擎怎么造数据
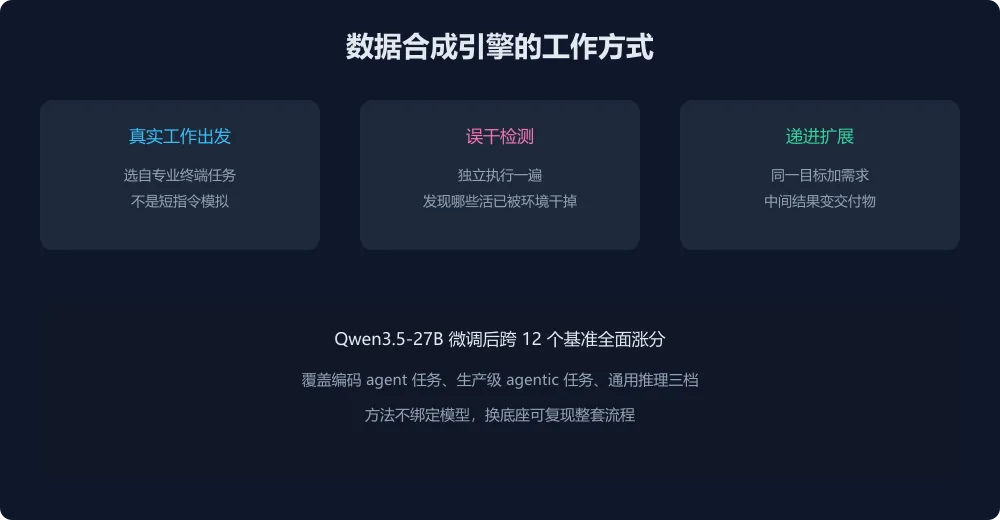
TerminalHorizon 是一个全自动数据合成引擎,全程无人工标注。第一步从真实专业工作出发构建任务环境,不是拍脑袋写任务模板,而是拿真实工作流程当骨架。第二步做误干检测,独立执行一遍来发现环境构建时无意中完成了哪些工作,用这些证据反过来指导环境重建,把被干掉的活还原回来,让 agent 面对真正待解决的问题。第三步递进扩展,在同一个目标下逐步追加需求,新任务要利用先前结果并要求进一步探索,形成越做越难的任务链。这套设计保证 agent 训练时面对的是真实长程工作,不是被提前铺平的赛道。
数字与案例
研究团队用引擎构建了 1500 个任务环境,微调 Qwen3.5-27B 得到 TerminalHorizon-27B,在编码 agent 任务、生产级 agentic 任务、通用推理三档共 12 个基准上全面提升。最有说服力的是多个递归自改进案例:在 12 小时研究预算下,模型能迭代超越初始方案、从反馈中精炼方法,并把有效改进保留在最终产出里,这正是长程专业工作的核心行为模式。
给数据团队的启示
三条直接可用的经验。其一,环境合成后先跑一遍检测误干,这个动作成本极低但价值极高,多数团队从没做过,做一次就能暴露整个数据集被空心化的程度。其二,任务不要平铺,往递进式靠拢:同一目标加需求比同质多题更能训练策略调整,因为 agent 被迫在已有结果上继续工作而不是每次重启。其三,评测要包含生产级长程任务,纯短任务基准会掩盖训练数据改善的真实效果,12 基准的覆盖宽度本身就是一个值得抄的评测设计。项目页面在 zs1314.github.io/TerminalHorizon,方法不绑定模型,换底座可复现整套流程。