字节笔记本
2026年10月14日 · 约 2 分钟读完
叫 LLM 别想,它偏要想:思维惯性是个可量化的坑
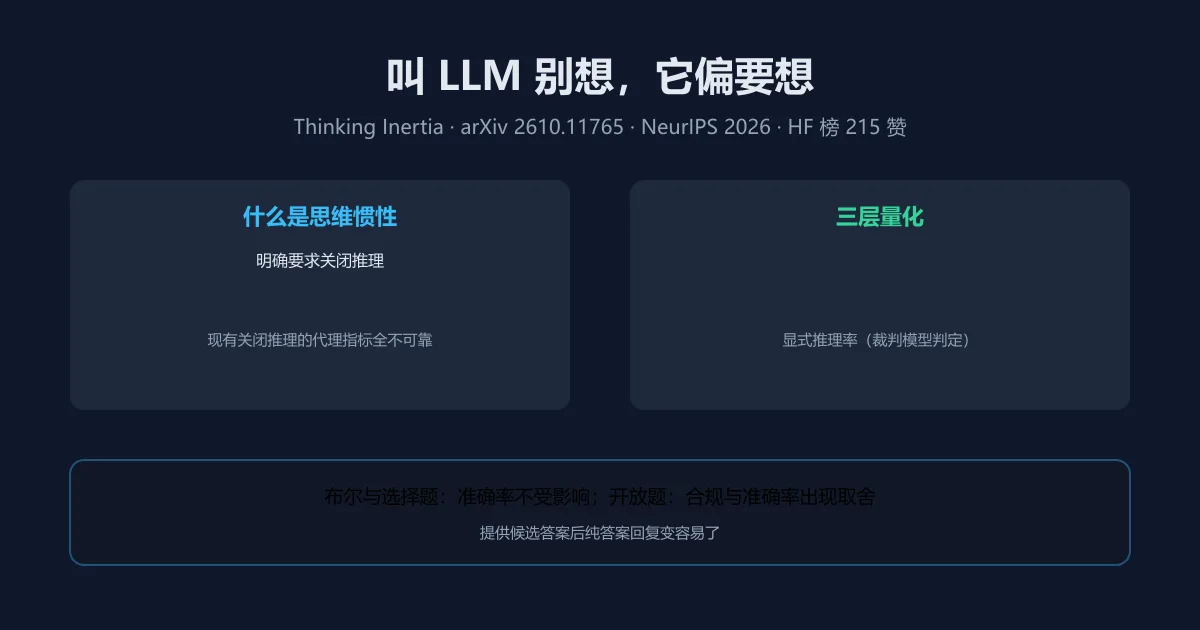
推理模型的时代带来一个被忽视的副作用:你不想要它的推理了,它停不下来。10 月 8 日放榜的 Thinking Inertia(arXiv 2610.11765,作者 Dianqiao Lei、Philip Torr、James Zou 等,NeurIPS 2026 接收,代码开源于 thinking-inertia/code)把这种现象命名为思维惯性:即使被明确指示不要思考,LLM 仍在产出显式推理。Hugging Face 论文榜 215 赞排第二,这个话题显然击中了很多人的日常体验。
老方法为什么量不出来
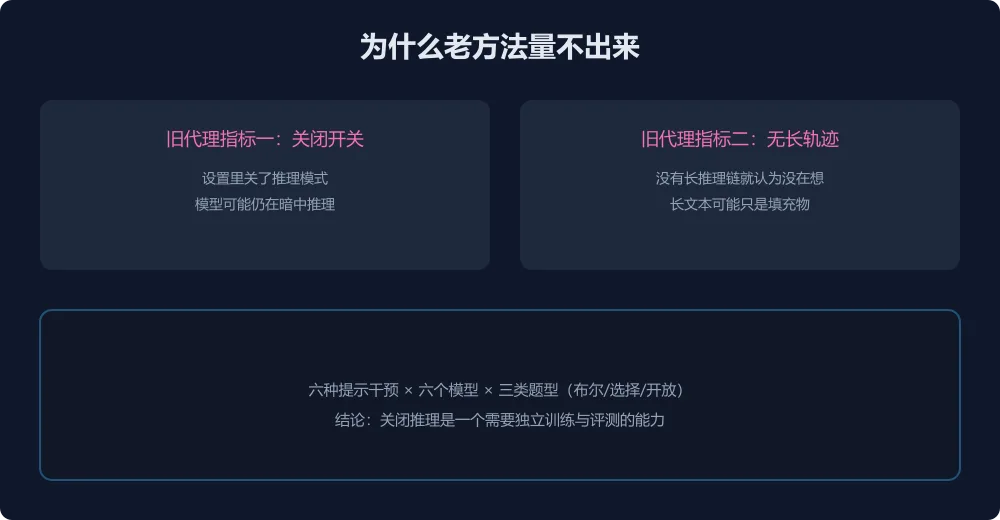
过去判断模型是否在想,靠两个代理指标:推理模式开关关了就算没在想;输出里没有长推理链就算没在想。论文指出两个都不可靠:开关关了模型可能仍在暗中推理;长文本可能只是填充物而非真实推理,两者都给不出真实答案。本文的方法是把每条回复归一化为前答案轨迹加最终答案两部分,然后在三个层级上量化:空思考率衡量严格纯答案合规;题前轨迹相关度看前答案内容与题目的语义相似;显式推理率用裁判模型判定可见推理是否出现。六种提示干预、六个 LLM、布尔选择开放三类题型交叉实测,覆盖面足够宽。
三个核心发现
第一个发现最直接:显式的禁想控制无法可靠地移除可见推理,思维惯性在所有测试组合中都存在,不是某个模型的个体毛病。第二个发现关于题型:答案空间越开放,显式推理越常见,控制难度随任务模糊度上升。第三个发现最有工程含义:布尔与选择题上关推理不影响准确率,但开放题上纯答案合规与准确率出现取舍,硬关推理是要付代价的;给模型提供候选答案能让纯答案回复变容易,这提示了一种缓解路径。
为什么这事值得在意
对推理成本的工程价值最直接:长推理链烧 token 且拖慢响应,很多场景只需要一个答案,但成本优化的努力常被思维惯性吃掉。这份工作证明关推理不是一行提示词或一个开关就能解决的事,它是一个需要独立训练与评测的能力。对做推理模型的团队,这篇文章提供了一个现成的评测协议;对应用层开发者,它解释了为什么你的请别推理提示词总是不管用。下一步值得关注的方向是训练侧的 obedience 对齐,让模型学会真正听话地闭嘴,而不是嘴上答应了脑子里还在想。