字节笔记本
2026年11月6日 · 约 1 分钟读完
腾讯给推理瘦身:局部偏好学习砍掉冗余思维链
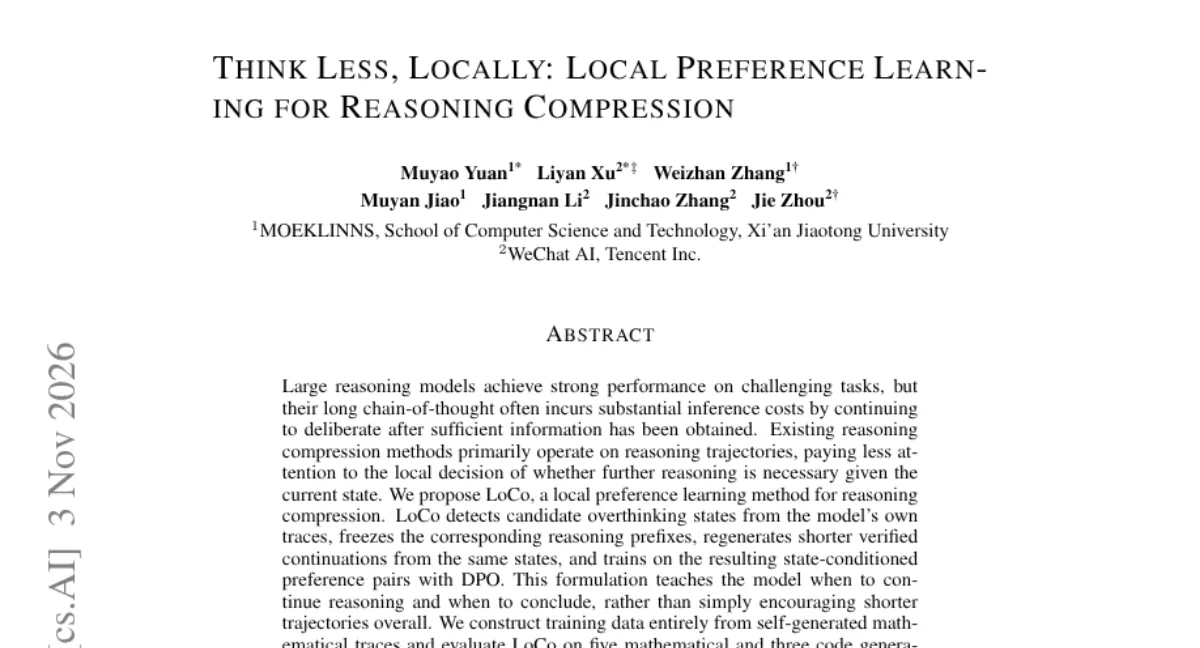
推理模型最大的浪费不是算错,而是「想多了」:信息早就够了,模型还在原地转圈。西安交通大学与腾讯微信 AI 的 LoCo(arXiv 2611.04814)把压缩的手术刀下到了局部:不再整条轨迹一刀切,而是在每个「是否继续推理」的决策点上做偏好学习。
流程三步。先找过度思考的位置:用模型自身的 token 置信度(步级置信度低加波动高)初筛候选状态,再用更强的判官模型复核分类。然后验证式续写:冻结检测到的推理前缀,从该状态采 8 个续写,取最短的正确续写当正例、原始续写当负例。最后做局部 DPO,只保留节省超过 300 token 的样本对。训练对象是 DeepSeek 蒸馏的 7B 模型,只用了数学题自生成轨迹,LoRA 加四块 H20 两轮搞定。
效果按论文口径:五个数学基准的完成长度减少 41.7% 到 45.4%,准确率保持甚至提升,更难的 Olympiad 和 AIME 上同时拿下最高准确率与最高 AUC;代码基准长度减少 23.4% 到 36.3%,而且只拿数学数据训练就迁移到了代码任务。消融的对照很有说服力:整条轨迹级别的偏好学习只能减 5.2% 到 15.8%,随机切点则损失准确率,外部大模型代写续写不如自生成。
「何时停止」是一个被过度思考问题定义淹没的独立决策,这篇把它单独拎出来训练,效果反而更好。被推理成本困扰的团队,这篇的局部化思路可以直接搬走。两个工程细节也顺手记下:外部大模型(GPT-5.4)代写续写的效果不如自生成续写,说明压缩信号最好来自模型自己的分布;代码与模型承诺开在 GitHub(MuyaoYuan/LoCo),复现前先确认许可与数据发布状态。推理瘦身这条线,本月的 rewrite 研究与这篇 LoCo 一个改历史、一个改停止时机,可以搭配服用。